
Régression
Dans toute recherche et toute analyse, il est très courant de recueillir des informations sur plusieurs variables afin d'étudier les relations qui les unissent. Il peut s'agir de données socio-économiques (revenu, niveau d'études, origine ethnique, etc.), de données anthropométriques (poids, taille, IMC, etc.), d'antécédents médicaux (présence d'un diabète, d'une maladie rhumatismale, d'une maladie pulmonaire, d'un cancer, etc.), de biomarqueurs (cholestérol, CRP, marqueurs tumoraux, etc.) et d'autres mesures (pression artérielle, âge, etc.). Pour étudier la relation entre ces variables, la régression est un outil puissant. La régression nous permet de :
- Étudier la relation (l'association) entre une variable dépendante () et une ou plusieurs variables indépendantes (prédicteurs, ).
- Étudier la force de la relation (de l'association) entre chaque prédicteur () et la variable dépendante ().
- Construire un modèle de prédiction utilisable pour prédire, c'est-à-dire prévoir à partir des informations sur .
Dans une analyse de régression, une variable () est prédite par au moins un prédicteur (). Sur le plan terminologique, on dit que dépend de ; est donc la variable dépendante et la variable indépendante.
| Rôle dans le modèle | Synonymes | |
|---|---|---|
| Y | Variable à prédire | Variable dépendante, dependent variable, outcome, critère de jugement, variable de résultat, label, target |
| X | Sert à prédire Y | Prédicteur, predictor, feature, covariable, covariate |
Prédiction ou estimation d'effet
Comme indiqué plus haut, la régression peut servir à étudier la relation entre des variables, à étudier la force de ces associations et/ou à effectuer des prédictions. En pratique, soit nous étudions comment un ou plusieurs prédicteurs sont associés au critère de jugement, soit nous construisons un modèle de prédiction afin de pouvoir prévoir une valeur ou un événement (). Il convient de distinguer les modèles de régression qui visent la prédiction (c'est-à-dire produire des prédictions) de ceux qui visent l'estimation d'effet (c'est-à-dire étudier la force et la forme des associations).
Prédiction : supposons que nous ayons recueilli des données sur 10 000 personnes et que nous les ayons suivies pendant plusieurs années afin d'étudier la survenue de cancers. Pour chaque personne, nous avons notamment recueilli l'âge, le sexe, la profession, la situation socio-économique, le tabagisme, les maladies, les traitements médicamenteux et les conditions de logement. Si l'objectif est de pouvoir prédire quelles personnes développeront un cancer du poumon, l'analyse de régression a pour but de produire des prédictions.
Estimation d'effet : supposons que nous ayons recueilli des données sur 10 000 personnes et que nous les ayons suivies pendant plusieurs années afin d'étudier la survenue de cancers du poumon. Pour chaque personne, nous avons notamment recueilli l'âge, le sexe, la profession, la situation socio-économique, le tabagisme, les maladies, les traitements médicamenteux et les conditions de logement. Si notre objectif est d'étudier la relation entre (par exemple) le tabagisme et le risque de cancer, l'analyse de régression a pour but d'estimer l'effet d'un prédicteur (le tabagisme). Il importe alors que l'association entre tabagisme et cancer ne soit pas faussée par d'autres facteurs. Il se peut par exemple que les fumeurs aient tendance à avoir un statut socio-économique plus bas, lequel influence également le risque de cancer. Il serait donc souhaitable de tenir compte du statut socio-économique (autrement dit, d'ajuster sur celui-ci). Cela peut se faire en incluant le statut socio-économique comme prédicteur dans le modèle. Lorsqu'on construit des modèles de régression destinés à l'estimation d'effet, il est essentiel de prendre en compte les facteurs de confusion de ce type (voir le chapitre Inférence causale).
Régression linéaire simple : une variable dépendante et un prédicteur
Ceci est un bref rappel du chapitre Régression linéaire.
L'équation de régression habituelle s'écrit ainsi :
- est l'ordonnée à l'origine (intercept), c'est-à-dire le point où la droite de régression coupe l'axe des Y (voir la figure ci-dessus).
- est le coefficient de
mass, c'est-à-dire la valeur de la pente de la droite de régression. - est l'écart entre la valeur de prédite par le modèle et la valeur observée de . Il s'agit donc de l'erreur du modèle (error).
La figure suivante montre la relation entre le prédicteur mass (poids corporel) et le critère de jugement glucose (glycémie).
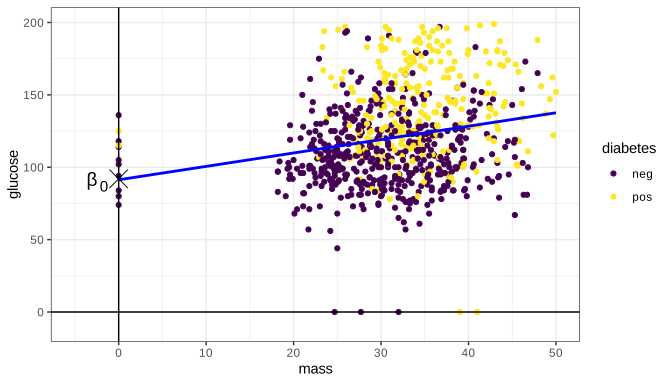
La droite de régression ci-dessus montre une association positive entre et : lorsque augmente, augmente. L'impression visuelle donnée par cette figure est donc que peut servir à prédire . Nous pouvons maintenant réécrire l'équation de la régression linéaire avec les variables mass et glucose :
Si nous souhaitons analyser la relation entre mass et glucose ajustée sur l'âge, une régression multiple est nécessaire. La régression multiple sert donc à étudier la relation entre au moins deux prédicteurs et un critère de jugement.
Régression multiple
<!-- video: https://science.nu/wp-content/uploads/Regressionsplan.mp4 -->
La régression multiple est un modèle comportant plusieurs prédicteurs, au moins 2. La formule mathématique de la régression multiple à deux prédicteurs s'écrit ainsi :
Cette relation ne peut plus être représentée par une droite de régression. La relation entre et les prédicteurs et forme désormais un plan de régression tridimensionnel, comme l'illustre la figure ci-dessus.
Significativité statistique : la relation entre X et Y est-elle statistiquement significative ?
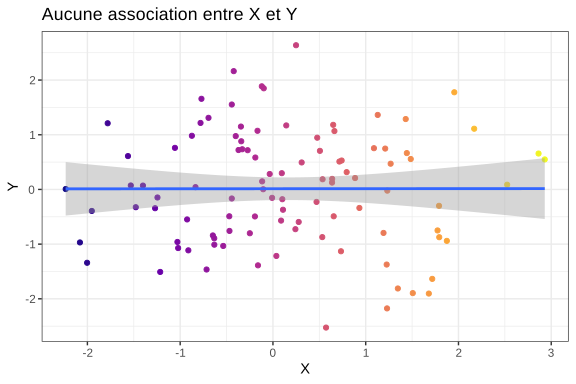
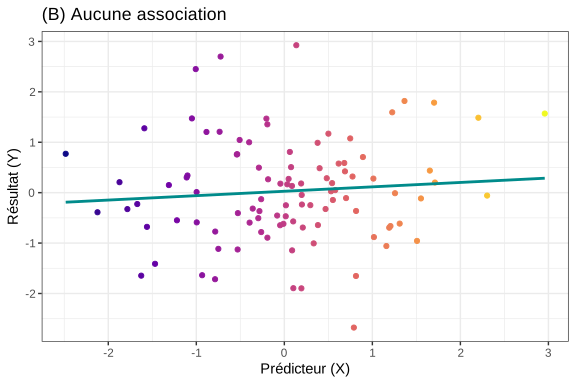
Une question centrale est de savoir si la relation entre et est statistiquement significative. On peut y répondre en partie par une appréciation visuelle de la relation graphique. Les appréciations visuelles sont toutefois subjectives, et il est en outre difficile d'évaluer des plans de régression tridimensionnels (ou des plans de régression comportant encore davantage de dimensions ). Il faut une mesure formelle permettant de dire si la relation entre et est significative. Cela peut se faire dans le cadre d'un test d'hypothèse, c'est-à-dire en posant une hypothèse nulle. Dans ce contexte, l'hypothèse nulle est qu'il n'existe aucune relation entre et , ce qui signifie que la pente (le coefficient) du prédicteur est égale à 0. Si la pente est nulle, il n'y a aucune relation entre et . Une telle situation est illustrée dans la figure ci-dessous.
Test de significativité par le test t (t-statistic)
Pour déterminer s'il existe une relation statistiquement significative entre et , nous devons tester l'hypothèse nulle. L'hypothèse nulle est que le coefficient du prédicteur a une pente nulle, ce qui signifie que la valeur de ne change pas lorsque X augmente ou diminue. Il s'agit alors de calculer la probabilité que l'hypothèse nulle soit vraie. Si cette probabilité est < 5 % (p < 0,05), nous rejetons l'hypothèse nulle et concluons donc à l'existence d'une relation, c'est-à-dire que est un prédicteur statistiquement significatif.
L'hypothèse nulle peut être testée par un test t. La valeur calculée s'appelle la statistique t (t-statistic) ; elle s'obtient en divisant le coefficient () par son erreur standard. La valeur t obtenue peut ensuite être convertie en valeur p. Tous les logiciels de statistique, y compris R, effectuent ces calculs automatiquement. Ainsi, lorsqu'on construit un modèle de régression, on obtient d'office les tests t et les valeurs p de tous les prédicteurs du modèle.
Nous allons maintenant construire un modèle de régression et en interpréter les résultats en détail.
Exercices de régression multiple
Voici deux exercices de régression multiple, l'accent étant mis sur l'interprétation des résultats. Les exercices sont réalisés dans R. Vous pouvez copier le code ci-dessous dans R et effectuer les mêmes analyses.
Nous utiliserons plusieurs packages pour faciliter et rendre plus efficace le travail. La régression linéaire multiple est disponible dans base R (l'installation standard de R). La fonction s'appelle lm(). Il nous faut en outre les packages sjPlot, broom et tidyverse pour extraire et présenter les résultats. Nous utiliserons les données PimaIndiansDiabetes (du package mlbench), qui contiennent des informations sur des Indiens Pima, population à haut risque de diabète. Pour installer et charger les packages ainsi que les données, on saisit les commandes suivantes :
install.packages(c("sjPlot", "broom", "mlbench"))
library(sjPlot)
library(broom)
library(tidyverse)

## Données sur les Indiens Pima
library(mlbench)
data("PimaIndiansDiabetes")

## Copier les données dans un objet au nom plus court
pima <- PimaIndiansDiabetes

## Examiner les 5 premières lignes
head(pima, 5)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
6 148 72 35 0 33.6 0.627 50 pos
1 85 66 29 0 26.6 0.351 31 neg
8 183 64 0 0 23.3 0.672 32 pos
1 89 66 23 94 28.1 0.167 21 neg
0 137 40 35 168 43.1 2.288 33 posL'étape suivante consiste à construire un modèle de régression. On utilise pour cela la fonction lm() (linear model), employée lorsque la variable dépendante est continue. Ici, la variable dépendante (le critère de jugement, Y) est la glycémie (glucose).
Avec la fonction lm(), le symbole ~ sert à spécifier le modèle. On place à gauche de ~ la variable dépendante (glucose) et on spécifie à droite tous les prédicteurs, séparés par +. Nous enregistrons le résultat dans l'objet my_model, puis nous exécutons l'objet pour afficher le résultat.
my_model <- lm(glucose ~ mass + age + insulin + pressure, data=pima)
my_modelCall:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Coefficients:
(Intercept) mass age insulin pressure
68.89351 0.58340 0.72475 0.08665 0.03373On voit ci-dessus la spécification du modèle sous l'intitulé Call. Sous l'intitulé Coefficients figurent les coefficients. La présentation du modèle est donc assez sommaire. Appliquons plutôt la fonction summary() à l'objet.
summary(my_model)Call:
lm(formula = glucose ~ mass + age + insulin + pressure, data = pima)
Residuals:
Min 1Q Median 3Q Max
-123.65 -17.78 -2.50 16.23 86.57
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 68.893507 5.491146 12.546 < 2e-16 ***
mass 0.583397 0.138432 4.214 2.81e-05 ***
age 0.724746 0.090398 8.017 4.06e-15 ***
insulin 0.086647 0.009137 9.483 < 2e-16 ***
pressure 0.033732 0.057169 0.590 0.555
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 28.52 on 763 degrees of freedom
Multiple R-squared: 0.2087, Adjusted R-squared: 0.2045
F-statistic: 50.3 on 4 and 763 DF, p-value: < 2.2e-16On obtient ainsi davantage d'informations sur le modèle. Pour chaque prédicteur sont désormais présentés le coefficient (Estimate), l'erreur standard (Std. Error), la statistique t (t value) et la valeur p (Pr(>|t|)). Les résultats s'interprètent comme suit :
- (Intercept) : l'ordonnée à l'origine ne nous intéresse pas. Il est extrêmement rare qu'elle présente un intérêt. Elle indique la valeur de Y (glucose) lorsque toutes les valeurs de X sont nulles, ce qui n'a pas de sens biologique (par exemple, personne ne pèse 0 kilo). L'ordonnée à l'origine est néanmoins toujours rapportée.
- Les prédicteurs :
- mass : si mass augmente de 1 unité, glucose augmente de 0,583397 unité.
- age : si age augmente de 1 unité, glucose augmente de 0,724746 unité.
- De même, les autres prédicteurs sont eux aussi associés positivement à glucose, puisque tous les coefficients sont positifs.
- Tous les prédicteurs, à l'exception de pressure, ont des valeurs p significatives (p < 0,05). Cela signifie que la relation entre pressure et glucose n'est pas statistiquement significative.
- L'association de chaque prédicteur est ajustée sur tous les autres prédicteurs. Autrement dit, chaque coefficient indique comment le prédicteur influe sur glucose lorsque les autres prédicteurs sont maintenus constants.
- R2 et R2 ajusté : le R2 est le pouvoir explicatif du modèle. Ici, le R2 vaut 0,2087, ce qui signifie que le modèle explique 20,87 % de la variabilité totale de glucose.
Il existe d'autres fonctions et packages permettant d'extraire et de présenter les résultats du modèle. Commençons par le package sjPlot, qui propose plusieurs fonctions utiles à cet effet. Avec tab_model(), les résultats du modèle sont présentés sous forme de tableau :
library(sjPlot)
tab_model(my_model)| Predictor | Estimates | 95% CI | P value |
|---|---|---|---|
| (Intercept) | 68.89 | 58.11 – 79.67 | <0.001 |
| mass | 0.58 | 0.31 – 0.86 | <0.001 |
| age | 0.72 | 0.55 – 0.90 | <0.001 |
| insulin | 0.09 | 0.07 – 0.10 | <0.001 |
| pressure | 0.03 | -0.08 – 0.15 | 0.555 |
| Observations | 768 | ||
| R2 / R2 adjusted | 0.209 / 0.205 |
Les résultats ci-dessus présentent également un intervalle de confiance, qui indique l'intervalle dans lequel se trouve le vrai coefficient avec une probabilité de 95 %. Avec une probabilité de 95 %, le coefficient de mass est compris entre 0,31 et 0,86. Notez que cet intervalle n'inclut pas 0 (zéro), ce qui signifie que nous pouvons affirmer avec 95 % de certitude qu'une augmentation de mass entraîne une augmentation de la glycémie. Cela concorde avec la valeur p, qui est < 0,001. La relation entre mass et la glycémie est donc statistiquement significative. Cet effet de mass est ajusté sur l'effet des autres prédicteurs (covariables) du modèle.
Le coefficient de mass indique l'ampleur de l'effet d'une augmentation de 1 unité de mass sur glucose, lorsque tous les autres prédicteurs (covariables) sont maintenus constants. Le même principe s'applique aux autres prédicteurs.
Notez la ligne Observations du tableau. Elle indique le nombre d'observations incluses dans le modèle de régression. Rappelez-vous que si une observation présente une donnée manquante (« missing ») pour l'un des prédicteurs du modèle, cette observation est exclue de l'ensemble du modèle. Ainsi, si une observation n'a par exemple pas de valeur pour mass mais dispose de valeurs pour toutes les autres variables, cette personne est exclue du modèle et nous perdons une observation.
La fonction plot_model() fournit une représentation graphique des résultats. Elle dispose d'un grand nombre d'arguments permettant d'ajuster le graphique.
plot_model(my_model, show.values = T)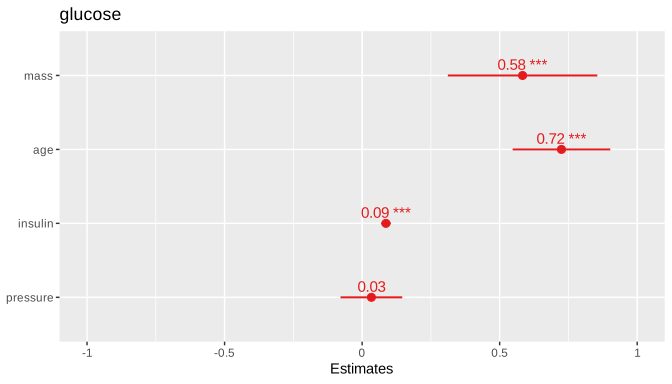
Linéarité (Linearity)
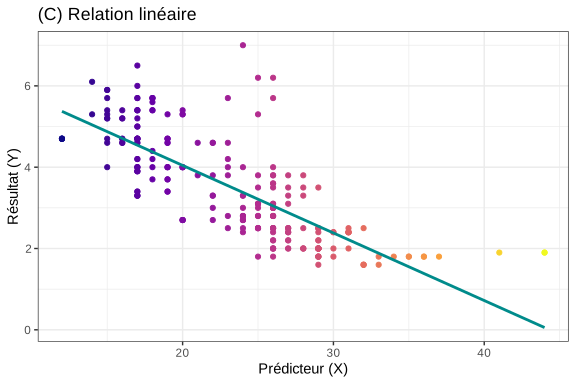
La régression linéaire suppose que chaque prédicteur soit associé linéairement à Y. La figure ci-dessous montre une droite de régression linéaire ajustée sur (A) des données présentant une relation non linéaire, (B) des données sans relation et (C) des données présentant une relation linéaire. Dans le cas (A), le modèle linéaire ne parvient pas à saisir une relation pourtant existante. Dans le cas (B), il n'y a pas de relation notable à saisir.
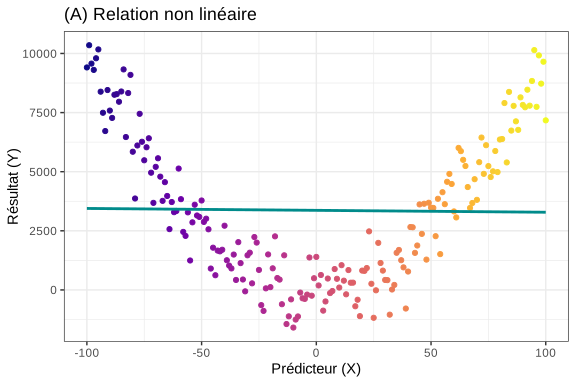
Transformer X en logarithme ne permet pas de saisir la relation dans le cas (A), même si une transformation logarithmique peut rendre plus linéaires certaines relations non linéaires. Pour saisir la relation dans le cas (A), une courbe plus flexible est nécessaire. Les méthodes de prise en charge de la non-linéarité sont présentées dans le chapitre Traitement des variables continues.
Spécification du modèle : bien spécifier le modèle
Si un modèle de régression est mal spécifié, ses coefficients ne sont pas fiables. Omettre des covariables importantes ou des interactions entre variables, ou ignorer des relations non linéaires, sont des causes fréquentes de mauvaise spécification. Cela peut conduire à surestimer, sous-estimer ou mal interpréter l'effet d'un ou de plusieurs prédicteurs. Une interaction signifie que deux prédicteurs (ou plus) interagissent, en ce sens que l'effet de l'un dépend de l'autre.
Interactions
Supposons que le médicament X soit utilisé pour traiter les céphalées. Le médicament n'agit que chez les femmes, car la substance est activée par une enzyme présente dans les glandes mammaires. L'effet du médicament dépend donc du sexe. Il existe ainsi une interaction entre l'effet du médicament et le sexe. Ne pas tenir compte de cette interaction conduit à un modèle erroné. Le modèle erroné se spécifie comme suit.
Ce modèle est erroné parce qu'il traite le sexe et le médicament comme deux paramètres (prédicteurs) distincts. Le modèle correct se spécifie avec l'interaction entre médicament et sexe. L'interaction consiste à multiplier le médicament par le sexe (mathématiquement, cela revient à introduire comme prédicteur la combinaison de chaque niveau du sexe avec chaque niveau du médicament) :
Pour déterminer si l'interaction est significative, on examine la valeur p du terme d'interaction. Tous les logiciels de statistique (y compris R) rapportent la valeur p (et l'intervalle de confiance à 95 %) des termes d'interaction. Si le terme d'interaction est significatif (p < 0,05), cela constitue une preuve de l'existence d'une interaction entre les prédicteurs.
Multicollinearity (multicolinéarité)
La régression multiple a pour but de quantifier l'effet indépendant de chaque prédicteur. Il existe toutefois des situations où un prédicteur ne peut être rendu indépendant d'un ou de plusieurs autres prédicteurs. Supposons que nous étudiions l'influence de l'IMC (indice de masse corporelle) sur la glycémie. Nous construisons une régression dans laquelle la glycémie est le critère de jugement, et l'IMC ainsi que l'âge sont les prédicteurs :
Admettons que l'effet (le coefficient) de l'IMC soit de 0,5, ce qui signifie que pour chaque unité d'augmentation de l'IMC, la glycémie augmente de 0,5 unité. Cet effet de l'IMC est indépendant de l'âge, puisque nous avons ajusté sur l'âge. On peut aussi dire qu'il s'agit de l'effet de l'IMC lorsque l'âge est maintenu constant. Si nous introduisions une covariable supplémentaire, à savoir le poids, une multicolinéarité pourrait apparaître. L'IMC et le poids sont en effet très fortement liés (l'IMC est une fonction du poids et de la taille), en ce sens que lorsque l'IMC augmente, le poids corporel tend lui aussi à augmenter. On ne peut alors plus affirmer que le coefficient de l'IMC représente l'effet de l'IMC à poids constant, puisque le poids augmente très probablement lui aussi lorsque l'IMC augmente. C'est un exemple de multicolinéarité, c'est-à-dire de situation où deux prédicteurs ou plus sont fortement corrélés entre eux.
Ce type de corrélation entre prédicteurs dégrade la précision des coefficients. Cela signifie aussi que nous utilisons plus d'informations que nécessaire. Si l'information contenue dans l'IMC se retrouve aussi dans le poids, et inversement, il suffit d'inclure l'un de ces deux prédicteurs dans le modèle.
Le risque de multicolinéarité est élevé si la corrélation (voir le chapitre Corrélation) entre deux prédicteurs est de 0,9 ou plus. La multicolinéarité peut toutefois poser problème même pour des degrés de corrélation plus faibles. Le facteur d'inflation de la variance (variance inflation factor, VIF) permet de rechercher une multicolinéarité.
Tests de multicolinéarité (multicolinearity)
Il existe plusieurs mesures pour tester la multicolinéarité. Celle-ci peut être testée globalement pour l'ensemble du modèle et pour chaque prédicteur du modèle. Une mesure courante de la multicolinéarité est le VIF (variance inflation factor). Le VIF mesure à quel point la variance d'un prédicteur est gonflée du fait de la multicolinéarité dans le modèle. Si le VIF est supérieur à 5, il existe une multicolinéarité. Si le VIF est > 10, la variable devrait être exclue du modèle.
Nous construisons maintenant un modèle à partir des données sur les Indiens Pima. Cette fois, nous utilisons toutes les variables des données pour prédire la glycémie (glucose). Nous chargeons le package mlbench pour obtenir les données sur les Indiens Pima.
library(mlbench)
data("PimaIndiansDiabetes")
my_model <- lm(glucose ~ ., data=PimaIndiansDiabetes)
Nous installons ensuite le package performance et utilisons la fonction check_model() pour obtenir le VIF sous forme graphique et sous forme de tableau :
install.packages("performance")
library(performance)

## Sous forme graphique
check_model(my_model, check="vif")

## Sous forme de tableau
multicollinearity(my_model)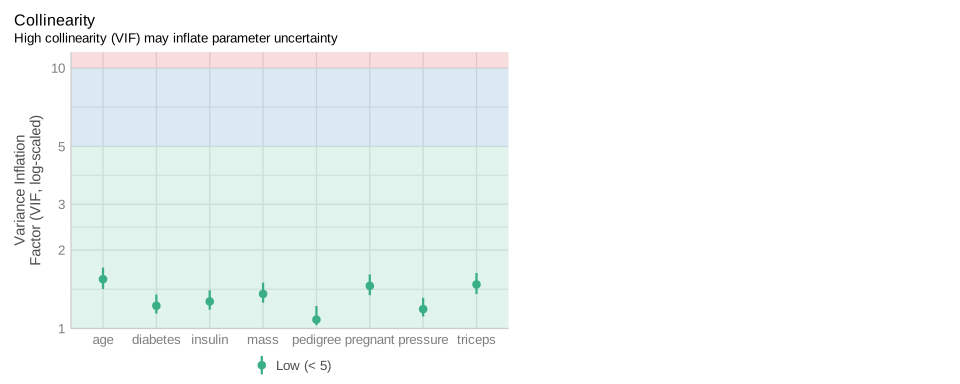
## Check for Multicollinearity

Low Correlation

     Term  VIF   VIF 95% CI Increased SE Tolerance Tolerance 95% CI
 pregnant 1.46 [1.34, 1.61]         1.21      0.69     [0.62, 0.75]
 pressure 1.19 [1.11, 1.31]         1.09      0.84     [0.76, 0.90]
  triceps 1.48 [1.36, 1.63]         1.21      0.68     [0.61, 0.74]
  insulin 1.27 [1.18, 1.40]         1.13      0.79     [0.71, 0.85]
     mass 1.36 [1.26, 1.50]         1.17      0.74     [0.67, 0.80]
 pedigree 1.08 [1.03, 1.22]         1.04      0.92     [0.82, 0.97]
      age 1.55 [1.42, 1.71]         1.24      0.65     [0.58, 0.71]
 diabetes 1.22 [1.14, 1.35]         1.11      0.82     [0.74, 0.88]
Comme on le voit ci-dessus, aucun prédicteur n'avait un VIF > 5 ; la colinéarité ne pose donc pas de problème dans notre modèle.
Prédicteurs catégoriels (factors)
Jusqu'ici, la discussion n'a porté que sur des prédicteurs qui sont des variables continues. On peut bien entendu étudier des prédicteurs qui sont des variables catégorielles, comme le sexe, le traitement, la ville, le pays, etc. Les modèles de régression contiennent généralement à la fois des prédicteurs continus et catégoriels.
Supposons que nous étudiions l'influence de l'âge, du poids et du pays de naissance sur la pression artérielle. Le modèle s'écrit ainsi :
L'âge et le poids sont des variables continues. Le pays de naissance (land) est en revanche une variable catégorielle comportant les modalités suivantes : (1) Suède, (2) pays nordiques et (3) Europe. Lorsque nous incluons le pays dans le modèle, l'une de ces modalités doit servir de modalité de référence, et les autres modalités sont comparées à cette référence. Interprétons maintenant les résultats du modèle de régression ci-dessus :
| Estimate | 95% CI | P values | |
|---|---|---|---|
| (Intercept) | 83.68 | 73.47 – 90.90 | <.001 |
| BMI | 0.91 | 0.76 – 1.05 | <.001 |
| Âge | 1.14 | 1.01 – 1.30 | <.001 |
| Pays de naissance | |||
| Suède | ref | ||
| Pays nordiques | 3.0 | 2.0 – 4.1 | <.001 |
| Europe | 2.1 | 1.5 – 2.7 | <.001 |
| Observations | 150 | ||
| R2 / adj. R2 | .837 / .832 |
On constate qu'il existe des coefficients (Estimate) pour les pays nordiques et l'Europe, mais que pour la Suède figure seulement la mention « ref ». Cela s'explique par le fait que la modalité Suède est la modalité de référence, à laquelle les pays nordiques et l'Europe sont comparés. Les effets présentés pour les pays nordiques et l'Europe le sont donc par rapport à la Suède. L'interprétation est alors la suivante :
- Pour chaque unité d'augmentation de l'IMC, la pression artérielle augmente de 0,91 unité, et ce résultat est statistiquement significatif.
- Pour chaque année d'âge supplémentaire, la pression artérielle augmente de 1,14 unité, et ce résultat est statistiquement significatif.
- Par rapport aux Suédois, les personnes nées dans les pays nordiques ont une pression artérielle plus élevée de 3,0 unités. Ce résultat est statistiquement significatif (p < 0,001) et la vraie valeur se situe entre 2,0 et 4,1 unités de pression artérielle en moins.
- Par rapport aux Suédois, les personnes nées en Europe ont une pression artérielle plus élevée de 2,1 unités. Ce résultat est statistiquement significatif (p < 0,001) et la vraie valeur se situe entre 1,5 et 2,7 unités de pression artérielle en moins.