Traitement des prédicteurs : catégoriels, continus
Lors du recueil des données et du développement de modèles de prédiction, il faut toujours s'efforcer d'utiliser des variables continues. Une variable continue contient toujours (quel que soit le modèle) davantage d'information qu'une variable catégorielle, et il est en règle générale erroné de catégoriser une variable continue, qu'il s'agisse du critère de jugement () ou d'un prédicteur (). Pourtant, les variables continues sont souvent catégorisées sans justification.
Il existe toutefois des situations où la catégorisation d'une variable continue se justifie. Supposons que nous étudiions l'influence du poids corporel (kg) sur le risque de développer un diabète. Nous construisons alors un modèle de prédiction avec le poids corporel (kg) comme prédicteur et le diabète (oui/non) comme critère de jugement. Si le poids corporel est une variable continue (kg), le coefficient de régression indiquera de combien le risque de diabète augmente pour chaque kg (kilogramme) de poids supplémentaire. L'augmentation du risque associée à une prise de poids de 1 kg peut paraître faible, voire dépourvue de pertinence clinique. Il peut alors être justifié de répartir le poids corporel en catégories (par exemple poids normal, surpoids, obésité). Lorsque le modèle de prédiction utilise ce prédicteur catégorisé, l'« effet » (c'est-à-dire le coefficient de régression) sera plus marqué. Dans ce cas, il peut donc être pertinent de catégoriser le prédicteur. Cela ne répond toutefois qu'à un objectif pédagogique ; le modèle comportant le prédicteur catégorisé sera en principe toujours moins performant que le modèle comportant le prédicteur continu.
Les études prospectives doivent, dans la mesure du possible, recueillir les données sous forme de variables continues. Il reste alors possible de catégoriser les variables ultérieurement.
L'hypothèse de linéarité : assouplissement par splines cubiques restreintes et polynômes
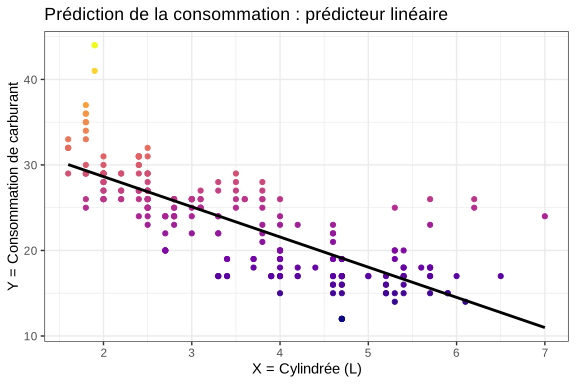
Les modèles linéaires, ou les modèles étroitement apparentés au modèle linéaire, dominent les analyses réalisées pour l'estimation d'effets et la prédiction. Le modèle linéaire repose sur l'hypothèse d'une relation linéaire entre le prédicteur et le critère de jugement (voir la figure ci-dessous). Cette hypothèse est une commodité, car les relations linéaires sont simples à manipuler mathématiquement. Or la nature est rarement parfaitement linéaire, et il peut être naïf de supposer que les relations sont linéaires. Si les analystes et les chercheurs se contentent souvent de fonctions linéaires, c'est parce qu'elles offrent une approximation acceptable de la réalité. Dans la figure ci-dessous, une droite de régression (noire) montre la relation entre le prédicteur et la consommation de carburant (). La figure montre que la droite de régression constitue une approximation acceptable de la relation, mais que pour les valeurs faibles (<2) et élevées (>5) de , la droite s'éloigne davantage des points de données (l'erreur est plus importante).
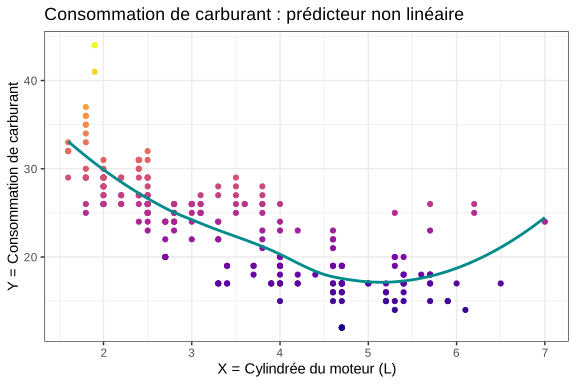
Reprenons le modèle ci-dessus en laissant le prédicteur entretenir une relation non linéaire avec . Cela signifie que la relation entre et peut varier (être flexible) sur l'étendue de . Le résultat est le suivant :
En superposant les graphiques, il apparaît plus clairement que le modèle non linéaire est plus précis :
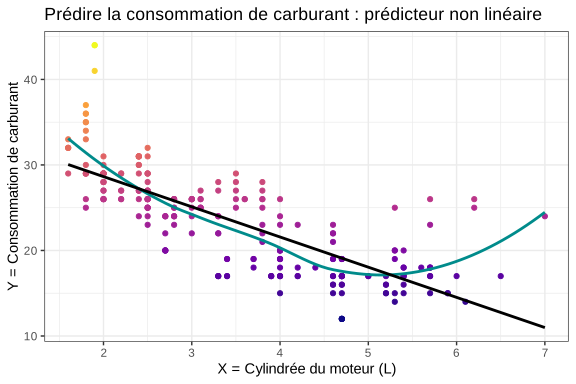
L'hypothèse de linéarité doit, en règle générale, être remise en question. Elle peut être examinée facilement, comme dans l'exemple ci-dessus (voir le chapitre Régression linéaire). La validité du modèle linéaire est meilleure lorsque les prédicteurs sont correctement spécifiés.
Si la relation entre et n'est pas linéaire, cela peut conduire à des conclusions erronées. La figure ci-dessous montre une relation fortement non linéaire qui conduit à la conclusion erronée qu'il n'existe aucune relation entre et , ce que traduit la droite de régression dont la pente est pratiquement nulle (β ≈ 0).
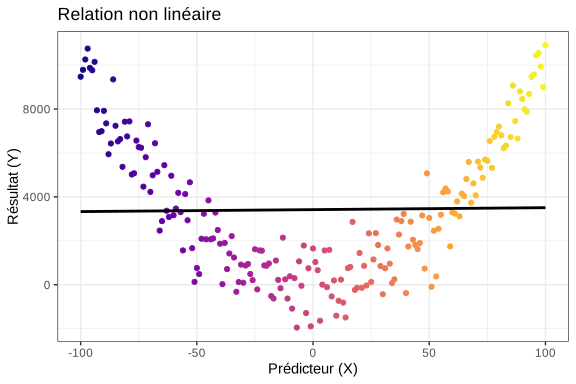
Il faut une droite de régression plus flexible. L'hypothèse de linéarité doit être assouplie pour que la droite de régression suive (prédise) mieux les données. Transformer le prédicteur était autrefois une méthode populaire. Prenons le logarithme du prédicteur et visualisons de nouveau la droite de régression :
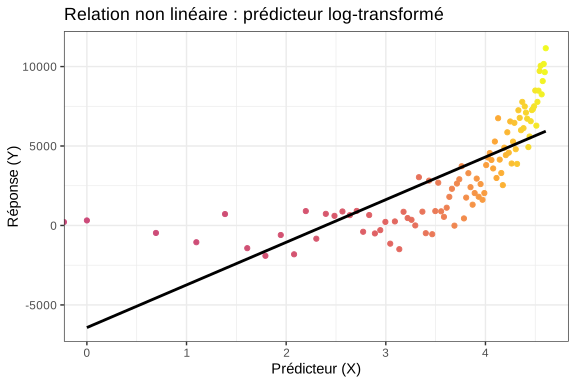
Dans le cas ci-dessus, la transformation du prédicteur donne un meilleur modèle, mais celui-ci n'est pas optimal (voir l'intervalle < 2) et, de plus, le coefficient devient plus difficile à interpréter (imaginez que nous ayons pris le logarithme du poids corporel en kg). Il est préférable d'utiliser des fonctions non linéaires de , qui ne supposent pas que la relation entre et est linéaire. Nous construisons à nouveau le modèle de prédiction avec une fonction non linéaire, sans transformation logarithmique de , ce qui donne le résultat suivant :
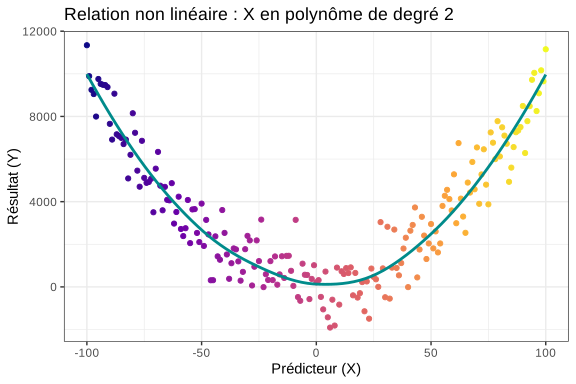
Dans la figure ci-dessus, a été modélisé par un polynôme du second degré, ce qui signifie que a été multiplié par . C'est la manière la plus simple d'assouplir l'hypothèse de linéarité ; elle consiste à utiliser un polynôme (angl. polynomial), c'est-à-dire des puissances entières du prédicteur . On distingue les polynômes suivants :
- Polynôme du second degré :
- Polynôme du troisième degré :
- Polynôme du quatrième degré :
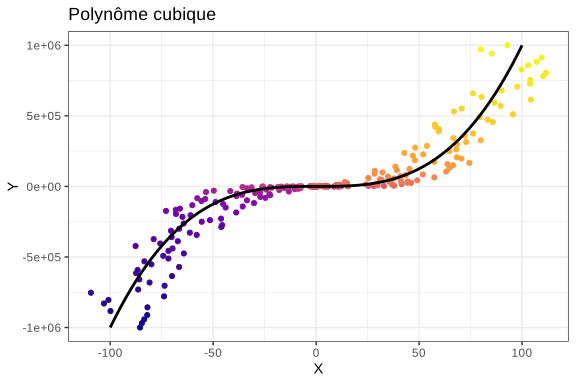
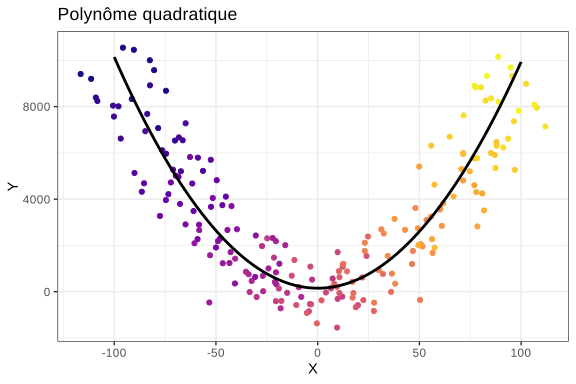
Si l'on souhaite inclure des polynômes dans une régression, tous les degrés inférieurs du prédicteur doivent également être inclus. Ainsi, si un polynôme du troisième degré () de l'âge doit être inclus dans le modèle, et doivent aussi être inclus comme prédicteurs distincts. Une méthode fréquemment utilisée, et tout aussi fréquemment critiquée, pour inclure des polynômes dans les modèles consiste à tester les polynômes et à les conserver si leurs coefficients sont statistiquement significatifs (P < 0,05), car cela prouverait l'existence d'une fonction non linéaire dans les données. La syntaxe d'un modèle linéaire comportant un polynôme du troisième degré pour le prédicteur x est la suivante :
lm(y ~ x + poly(x, 2) + poly(x, 3), data=data)En réalité, R inclut toujours les degrés inférieurs d'un polynôme, même si on ne le précise pas. Le modèle ci-dessus est donc équivalent au suivant :
lm(y ~ poly(x, 3), data=data)Construisons une régression linéaire avec un polynôme du troisième degré sur les données mpg. Nous utilisons le package broom pour extraire les résultats du modèle.
library(tidyverse)
data(mpg)

my_fit <- lm(hwy ~ drv + cyl + poly(displ, 3), data=mpg)

library(broom)
tidy(my_fit)| term | estimate | std.error | statistic | p.value |
|---|---|---|---|---|
| (Intercept) | 24.8304756 | 2.1392664 | 11.607005 | 0.000000 |
| drvf | 4.4553554 | 0.5050549 | 8.821528 | 0.000000 |
| drvr | 4.1892200 | 0.6871610 | 6.096417 | 0.000000 |
| cyl | -0.6548109 | 0.3682590 | -1.778126 | 0.0767217 |
| poly(displ, 3)1 | -41.8215567 | 9.8728249 | -4.236027 | 0.000033 |
| poly(displ, 3)2 | 17.0200984 | 3.2063213 | 5.308295 | 0.000000 |
| poly(displ, 3)3 | 2.0802160 | 3.0357794 | 0.685233 | 0.493896 |
Comme le montre le tableau ci-dessus, le polynôme du troisième degré (« poly(displ, 3)3 ») n'est pas statistiquement significatif (p = 0,493896), tandis que le polynôme du second degré est statistiquement significatif (p = 0,000000), de même que le prédicteur linéaire (p = 0,000033). Les polynômes présentent toutefois plusieurs défauts susceptibles de conduire à des prédictions insatisfaisantes. Les splines sont souvent préférées aux polynômes.
Splines de régression : splines linéaires, splines cubiques, splines cubiques restreintes
Une spline est une fonction flexible composée de plusieurs polynômes. Chaque polynôme représente un intervalle de la distribution du prédicteur , et tous les polynômes sont raccordés à leurs extrémités.
La fonction spline la plus simple est la spline linéaire. Une spline linéaire simple signifie tout simplement que le prédicteur a été divisé en intervalles, ce qui revient en fait à scinder en plusieurs prédicteurs. Même si chacun des intervalles correspond à une fonction linéaire, leur ensemble peut former une fonction non linéaire. Dans la figure ci-dessous, a été divisé en 3 intervalles à l'aide de deux nœuds (angl. knots). Le nombre et la position de ces nœuds peuvent être ajustés.
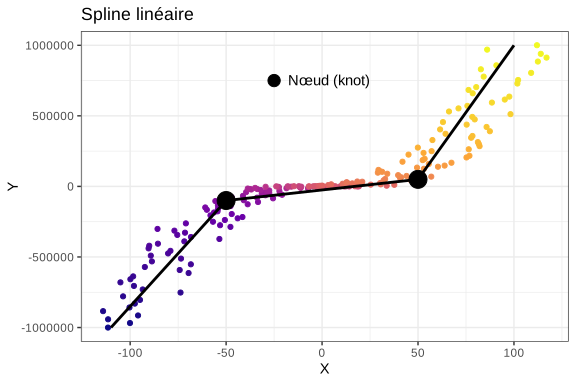
Une spline linéaire simple permet de modéliser des fonctions non linéaires et exige seulement que la relation entre et soit linéaire à l'intérieur de chaque intervalle.
L'équation du modèle initial (sans spline) est la suivante :
Y = β0 + β1X1
Si le prédicteur X1 est développé en une spline à 3 intervalles, l'équation devient :
Y = β0 + β1X1 + β2X2 + β3X3
Splines cubiques (CS)
Une spline linéaire est le plus souvent préférable aux polynômes, mais malheureusement les splines linéaires manquent de flexibilité précisément au niveau des nœuds, de sorte que la modélisation de relations courbes n'est pas optimale. Pour y remédier, on peut utiliser des splines cubiques (angl. cubic splines), qui sont identiques aux splines linéaires, à ceci près que l'on utilise un polynôme dans chaque intervalle. Les raccordements entre les intervalles sont ainsi lisses, et les splines cubiques décrivent mieux (que les splines linéaires) les relations courbes. Si une spline cubique comporte 3 nœuds (knots), il faut estimer au total 6 coefficients de régression (β1 à β6). Le nombre de coefficients à estimer est en effet k+3, où k est le nombre de nœuds. L'utilisation de splines cubiques devient donc coûteuse, puisqu'un plus grand nombre de paramètres doit être estimé.
Splines cubiques restreintes (RCS, splines naturelles)
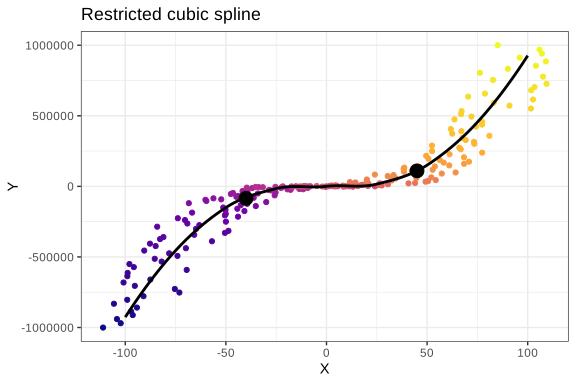
La fonction spline la meilleure et la plus utilisée est la spline cubique restreinte (angl. restricted cubic spline). Ces fonctions spline ressemblent aux splines cubiques, mais la fonction est contrainte d'être linéaire dans les queues (au début et à la fin de la distribution du prédicteur). Cela améliore la précision du modèle. L'utilisation de splines cubiques restreintes pénalise le modèle de k+1 paramètres. Ainsi, si 3 nœuds sont utilisés, 4 coefficients doivent être estimés.
Les splines sont-elles nécessaires ?
Si un prédicteur est développé en une fonction spline, on peut utiliser la valeur P pour déterminer si la fonction spline est nécessaire. L'hypothèse nulle est que les coefficients (des différents intervalles de la spline) sont égaux à 0 ; si la valeur P est < 0,05, cette hypothèse est peu vraisemblable et l'on conserve alors ces splines.
Combien de nœuds (knots) faut-il ?
Si l'on connaît la relation entre le prédicteur et le critère de jugement , et que l'on sait où se situent les courbures et les non-linéarités, on peut spécifier soi-même l'emplacement des nœuds. Il n'est pas indispensable de savoir où se situe la non-linéarité. On peut parfaitement utiliser des splines sans cette connaissance, à condition que les nœuds soient répartis uniformément sur l'étendue de .
Dans R, vous indiquez le nombre de nœuds souhaité et ceux-ci sont automatiquement placés aux bons intervalles. On utilise au moins 3 nœuds (même si les exemples ci-dessus ont été illustrés avec deux nœuds), et il est rarement nécessaire d'en utiliser plus de 6. Plus le nombre d'observations est élevé, plus on peut utiliser de nœuds.
Les splines cubiques restreintes peuvent être utilisées en régression linéaire, en régression logistique, en régression de Poisson, en régression de Cox, etc.
Il faut recourir généreusement aux splines cubiques restreintes, car il est naïf de supposer que les relations sont linéaires. Il convient toutefois de prédéfinir ses splines avant de construire le modèle. Il n'est pas recommandé de faire précéder cette étape d'une visualisation des relations entre variables (par exemple à l'aide de diagrammes de corrélation). Il faut être particulièrement généreux avec les splines pour les prédicteurs fortement liés au critère de jugement. Il est généralement inutile d'investir des degrés de liberté dans des variables faiblement liées au critère de jugement.
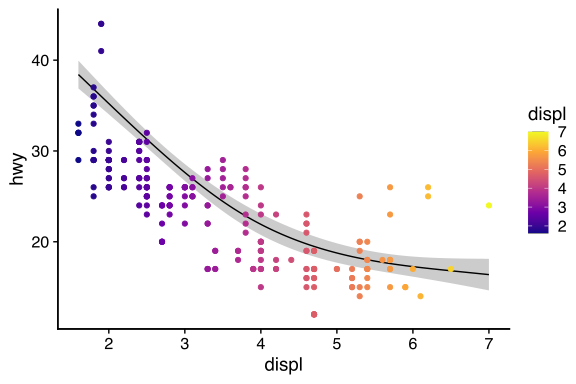
Dans le code ci-dessous, nous chargeons les packages tidyverse, Hmisc et rms, puis les données mpg. Le package rms contient des fonctions pour les splines cubiques restreintes (rcs()). Pour utiliser rms, nous devons indiquer au package quelles distributions figurent dans les données mpg. Nous les déclarons ensuite dans options(). Nous construisons ensuite un modèle avec ols() (la fonction de régression linéaire du package rms), dans lequel le prédicteur displ est modélisé par une fonction spline. La relation est ensuite visualisée avec ggplot(). Notez que nous réalisons deux graphiques que nous superposons avec cowplot().
library(Hmisc)
library(rms)

## Distributions
ddist <- datadist(mpg)
options(datadist='ddist')

## Création du modèle
model <- ols(hwy ~ rcs(displ, 3), data=mpg, x=T, y=T)

## Graphique de la fonction spline
p1 <- ggplot(Predict(model, "displ"), ylab="Y (hwy)") +theme_half_open()

## Graphique avec les valeurs de x et de y
p2 <- ggplot(mpg, aes(x=displ, y=hwy, color=displ)) + geom_point() + scale_color_viridis_c(option = "plasma") + theme_half_open()

## Superposition des graphiques
library(cowplot)
aligned_plots <- align_plots(p1, p2, align="hv", axis="tblr")
ggdraw(aligned_plots[[1]]) + draw_plot(aligned_plots[[2]])