
La corrélation n'est pas la régression
L'étude du lien (l'association, la relation) entre deux variables ou plus est courante dans toute recherche et toute analyse. Dans ce contexte, les termes lien, association et relation sont synonymes. Parmi les liens que l'on peut étudier figurent par exemple le lien entre le cholestérol et l'infarctus du myocarde, ou entre l'IMC (indice de masse corporelle) et la glycémie. Une fois l'association entre les variables caractérisée, il est possible de répondre aux questions suivantes :
- Existe-t-il une relation entre les variables ?
- Quelle est la force de la relation entre les variables ?
- Quelle est la forme de la relation ?
Pour étudier les associations entre variables, on utilise le plus souvent la corrélation et la régression. La corrélation permet d'étudier la force d'une relation linéaire entre deux variables. La régression est un outil plus puissant : elle permet en effet d'étudier la force de la relation, d'étudier plus de deux variables simultanément et d'utiliser le résultat pour prédire (faire des prédictions). Prédire consiste à utiliser un modèle statistique pour estimer la valeur d'une variable inconnue à partir de variables dont les valeurs sont connues. Les variables utilisées pour prédire sont appelées prédicteurs. La variable à prédire est notée mathématiquement et possède plusieurs synonymes, par exemple critère de jugement, mesure de résultat, outcome, variable dépendante, label, etc.
Supposons que nous étudiions la relation entre l'IMC (indice de masse corporelle) et la glycémie. La corrélation nous permet de déterminer la force de la relation entre l'IMC et la glycémie. La régression nous permet, outre de nous prononcer sur la force de la relation, de décrire la forme du lien et d'apprendre à prédire la glycémie pour différentes valeurs d'IMC.
Corrélation et régression : causalité ou association ?
La causalité a été abordée précédemment. Voir le chapitre Inférence causale (causalité) pour plus de détails.
La notion de causalité est centrale dans toute recherche et toute analyse. Un lien de causalité entre deux facteurs signifie que l'un des facteurs influence l'autre. Il existe donc une relation de cause à effet entre ces facteurs. Il existe un lien de causalité entre le cholestérol LDL et le risque de maladie coronarienne. Cela signifie qu'à mesure que le cholestérol LDL augmente, le risque de maladie coronarienne augmente. Le lien entre le cholestérol LDL et la maladie coronarienne est donc causal. Comme discuté dans le chapitre Inférence causale (causalité), ce sujet est relativement complexe. Le théorème central est qu'une association mathématique (qu'elle soit démontrée par la corrélation, la régression ou le machine learning) n'est pas nécessairement causale. Toute association doit être interprétée avec prudence, et la conclusion qu'un lien est causal doit reposer sur une science approfondie, multidisciplinaire et reproductible.
Voici un exemple de lien non causal :
Supposons que nous étudiions le lien entre les doigts jaunis et le risque de cancer du poumon. Nous examinons 5 000 personnes et attribuons à leurs doigts un score de 0 à 50 selon leur degré de jaunissement, puis nous constatons que plus les doigts sont jaunes, plus le risque de cancer du poumon est élevé. Dans ce cas, le lien entre doigts jaunis et cancer du poumon est réel, c'est-à-dire qu'il existe un lien confirmé mathématiquement. Les doigts jaunis ne sont toutefois pas la cause du cancer du poumon : il est plus probable que les personnes aux doigts jaunis fument, et plus on fume, plus les doigts sont jaunes. C'est le tabagisme qui explique à la fois les doigts jaunis et le cancer du poumon. Même si les doigts jaunis ne sont pas la cause du cancer, la mise en évidence de ce lien reste importante, car (1) les doigts jaunis peuvent être utilisés cliniquement comme outil de dépistage et (2) les doigts jaunis peuvent nous conduire à la véritable cause du cancer.
La corrélation et le coefficient de corrélation
Une corrélation fait intervenir deux variables (ci-après et ). Ces variables sont traitées de manière symétrique, en ce sens qu'aucune d'elles n'est considérée comme prédicteur ou comme critère de jugement (outcome). La corrélation entre et représente le lien entre les variables. La corrélation varie de –1 à +1, et cette valeur, appelée coefficient de corrélation, est sans unité. Un coefficient de corrélation de +1 indique une relation linéaire positive parfaite entre et . Si le coefficient vaut au contraire –1, cela indique une relation linéaire négative parfaite entre et . Si le coefficient de corrélation vaut 0, il n'existe aucun lien entre et .
Nous allons maintenant visualiser et calculer la corrélation entre deux variables des données mtcars. Pour visualiser la corrélation et calculer le coefficient de corrélation, nous utilisons le package ggpubr, qui contient la fonction ggscatter(). Les commentaires ci-dessous expliquent les arguments.
library(tidyverse)
data("mtcars")

library(ggpubr)
ggscatter(mtcars,
          x = "wt",
          y = "mpg",
          size = 3,
          add = "reg.line",
          cor.coef = TRUE,
          cor.coeff.args = list(method = "pearson", label.x = 3, label.sep = "\n"))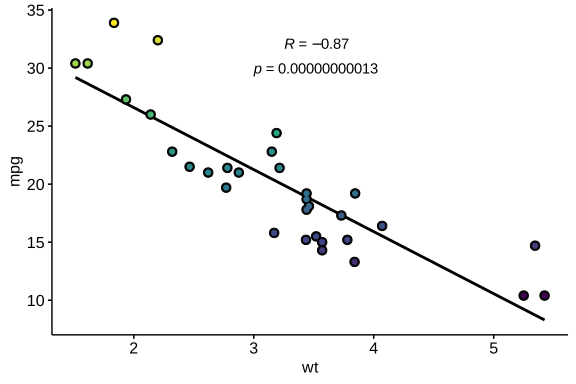
Le coefficient de corrélation était de -0,87, ce qui correspond à une forte relation négative. Notez que la droite du graphique ci-dessus est une droite de régression. Une corrélation ne produit pas de droite passant par les données.
La fonction ggpairs() du package GGally permet de générer une matrice de corrélation pour de nombreuses variables à la fois. Le code et le résultat sont les suivants :
library(GGally)
ggpairs(mtcars,
        # Quelles colonnes ?
       columns = 1:4,
       ggplot2::aes(colour=factor(am)))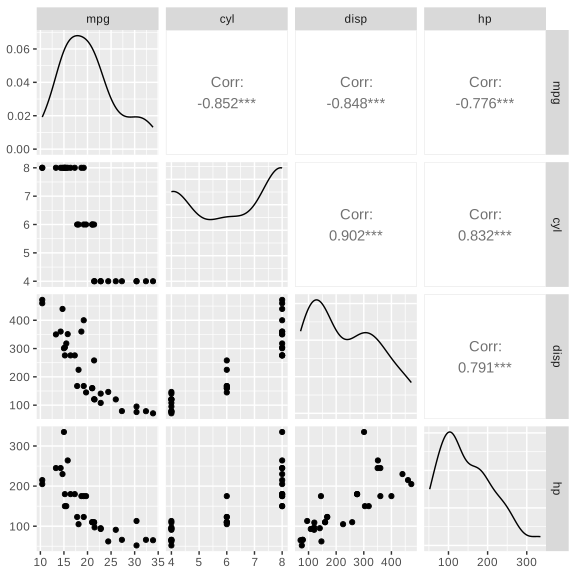
Le coefficient de corrélation mesure la relation linéaire entre X et Y. Le coefficient peut valoir au maximum –1 ou +1, selon que la relation est négative ou positive. Plus la corrélation est proche de 0, plus la relation est faible. Plus la corrélation est proche de –1 ou de +1, plus la relation est forte. Si le coefficient de corrélation vaut 0, une variation de X n'entraîne pas de variation de Y.
Coefficient de corrélation de Pearson
Le coefficient de corrélation doit être calculé à partir des données. Il existe plusieurs façons de le calculer. Le coefficient de corrélation le plus utilisé est le Pearson’s Product-Moment Coefficient of Correlation, ou simplement coefficient de corrélation de Pearson. Il est désigné par la lettre r. Le coefficient de corrélation de Pearson s'obtient en divisant la covariance des variables et par le produit de leurs écarts-types.
Covariance et corrélation
La covariance s'apparente à la corrélation. La covariance mesure la covariation de deux variables (, ), c'est-à-dire la manière dont et varient conjointement. Si des valeurs plus élevées de X correspondent à des valeurs plus élevées de Y, et inversement, il existe une covariation entre et . Une covariance positive signifie que des valeurs plus élevées de correspondent à des valeurs plus élevées de . Une covariance négative signifie l'inverse.
La covariance est la covariation linéaire entre et , ce qui rappelle beaucoup la corrélation entre et . La covariance est toutefois plus difficile à interpréter et à comparer. Par exemple, on ne peut pas déterminer si la covariance entre l'âge et le poids corporel est aussi forte que la covariance entre l'âge et la taille, car la covariance dépend de l'échelle (si les variables ne sont pas sur la même échelle, elles ne peuvent pas être comparées). La solution consiste à normaliser la covariance. Pour cela, on divise la covariance par un facteur qui représente l'échelle et la variabilité de et de . On obtient ainsi une valeur comprise entre –1 et +1, quelles que soient les variables étudiées. Cela permet également de comparer les corrélations entre variables. Pour le coefficient de corrélation de Pearson, ce facteur est donc le produit des écarts-types des variables (, ).
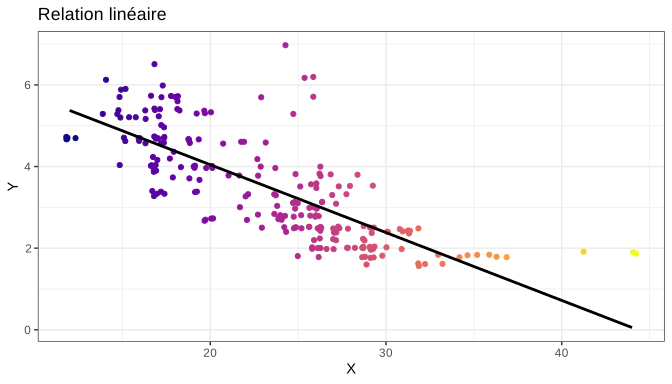
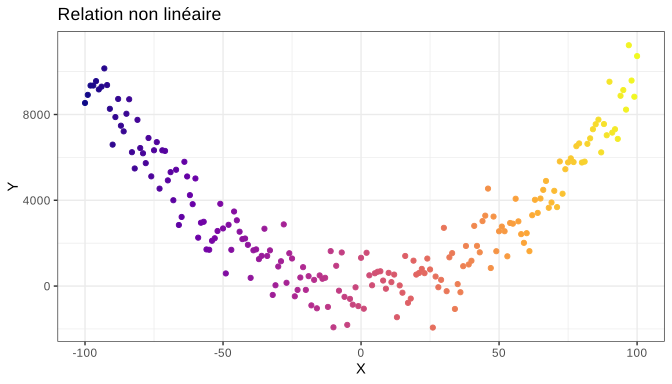
Le coefficient de corrélation de Pearson repose sur l'hypothèse que et suivent une loi normale et que la relation entre et est linéaire. La méthode de Pearson est donc paramétrique (elle exige que les variables suivent une loi normale). La figure ci-dessous montre respectivement une relation linéaire et une relation non linéaire.
Spearman rank correlation coefficient (coefficient de corrélation de Spearman)
Si les variables ( et ) ne satisfont pas aux hypothèses ci-dessus, il existe des méthodes non paramétriques (c'est-à-dire qui n'exigent pas de loi normale). La méthode non paramétrique la plus utilisée est le Spearman rank correlation coefficient, ou simplement coefficient de corrélation de Spearman. Cette méthode compare plutôt les rangs de et de . L'utilisation des rangs rend le calcul plus robuste lorsque la relation n'est pas linéaire. Les rangs réduisent également l'influence d'éventuelles valeurs aberrantes (outliers).
Si les hypothèses du coefficient de corrélation de Pearson sont satisfaites, il ne faut pas utiliser la corrélation de Spearman, car elle est moins efficace : la méthode de Pearson a une plus grande capacité à détecter une relation (si celle-ci existe).
On peut aussi transformer ou (ou les deux) s'ils ne satisfont pas aux hypothèses de Pearson. La transformation peut par exemple consister à prendre le logarithme d'une variable ou des deux. Cela permet souvent de satisfaire aux hypothèses de Pearson. La transformation n'affecte pas le coefficient de corrélation de Spearman, puisque celui-ci n'utilise que les rangs des variables, qui ne sont pas modifiés par la transformation.
Comment vérifier si les variables suivent une loi normale ?
Réponse : réalisez un histogramme pour chaque variable.
Comment vérifier si la relation entre et est linéaire ?
Réponse : un nuage de points permet d'examiner (visuellement) la forme de la relation.
Exemple dans R
Chargez tidyverse et les données diamonds, qui contiennent des informations sur différents diamants.
library(tidyverse)
data(diamonds)
Réalisez ensuite un nuage de points avec le prix (price) en abscisse, le carat (carat) en ordonnée, et colorez les points selon la taille (cut).
ggplot(diamonds,
       aes(x=price, y=carat, color=cut)) +
  geom_point() +
  theme_bw()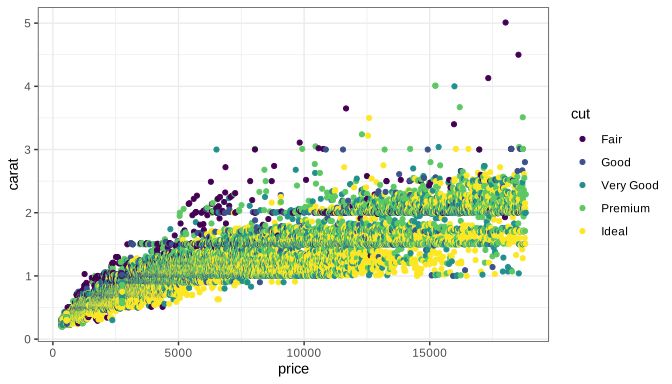
## Force de la corrélation selon la méthode de Pearson
cor(tabell$price, tabell$carat, method="pearson")[1] 0.9215913## Force de la corrélation selon la méthode de Spearman
cor(tabell$price, tabell$carat, method="spearman")[1] 0.9628828Évaluation visuelle de la relation
Il faut toujours procéder à une évaluation visuelle d'une corrélation. Un nuage de points est excellent pour cela, en particulier si une droite de régression peut être représentée sur le graphique. L'évaluation visuelle est importante parce que le coefficient de corrélation lui-même ne caractérise pas la relation entre les variables.
Le coefficient de corrélation est donc une mesure de synthèse et ne doit jamais remplacer une évaluation visuelle de la relation entre et .