
Régression
La régression permet d'étudier la relation (l'association) entre deux variables ou plus. Dans une analyse de régression, une variable () est prédite par au moins un prédicteur (). Sur le plan terminologique, on dit que dépend de ; est donc la variable dépendante et la variable indépendante.
| Rôle dans le modèle | Synonyme | |
|---|---|---|
| Y | Variable à prédire | Variable dépendante, dependent variable, outcome, critère de jugement, variable de résultat, label, target |
| X | Sert à prédire Y | Prédicteur, predictor, feature, covariable, covariate |
Supposons que nous étudiions la relation entre l'IMC (indice de masse corporelle) et la glycémie. La régression permet d'utiliser l'une des variables pour prédire la valeur de l'autre. Ici, l'IMC sert à prédire la glycémie. L'IMC est donc la variable indépendante (prédicteur) et le glucose la variable dépendante (outcome).
Nous illustrerons la régression linéaire avec des données provenant d'Indiens Pima, une population présentant un risque très élevé de diabète. Les données des Indiens Pima se trouvent dans le package mlbench. Installez mlbench, chargez le package ainsi que les données des Indiens Pima avec la commande suivante :
library(mlbench)
data(PimaIndiansDiabetes)

## Graphique de la relation entre mass et glucose
ggplot(data=PimaIndiansDiabetes,
       aes(x=mass, y=glucose, color=diabetes)) +
  geom_point() +
  geom_smooth()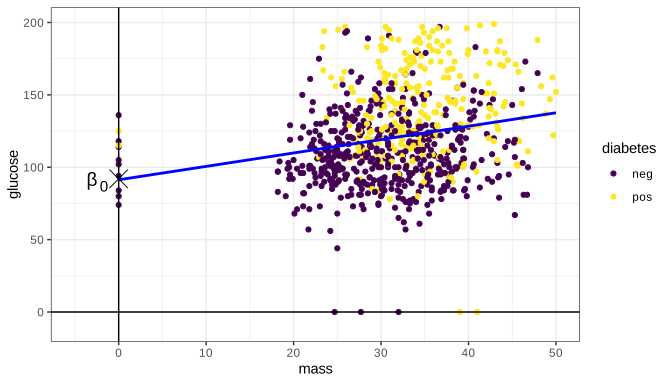
La figure ci-dessus montre comment l'IMC (mass) est associé à la glycémie (glucose). On y voit une droite bleue qui constitue la droite de régression de mass. La relation entre mass et glucose peut être décrite par une formule simple.
- est l'ordonnée à l'origine (intercept), c'est-à-dire le point où la droite de régression coupe l'axe des Y (voir la figure ci-dessus).
- est le coefficient de
mass, autrement dit la valeur de la pente de la droite de régression. - est la différence entre la valeur de prédite par le modèle et la valeur observée de . Il s'agit donc de l'erreur du modèle (error).
En résumé, il s'agit d'un modèle qui prédit à l'aide d'une droite de régression dont la pente est . L'ordonnée à l'origine () nous intéresse très rarement. L'erreur du modèle () est une mesure de la qualité du modèle.
L'objectif est d'obtenir une droite de régression dont la pente est ajustée de façon à représenter la relation entre et . La pente de la droite dépend de la relation entre mass et glucose. La pente de mass est également appelée coefficient de mass. Si glucose augmente lorsque mass augmente, la droite de régression aura une pente positive. Dans la figure ci-dessus, on voit que la droite a une pente positive ; le coefficient de mass est donc positif.
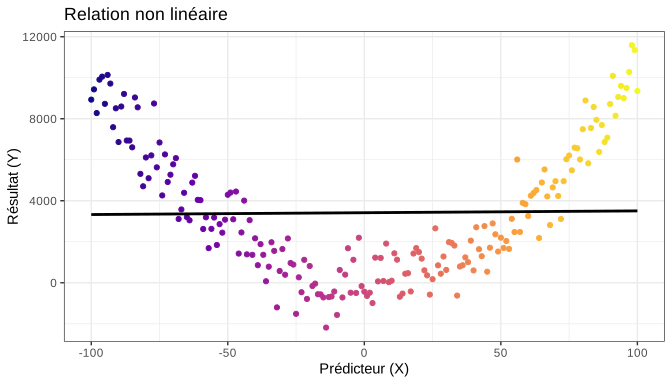
Notez que la relation entre et doit être linéaire pour que le modèle linéaire puisse être utilisé. Si la relation n'est pas linéaire, le modèle linéaire peut être trompeur. Voici un exemple de relation non linéaire entre et . La droite de régression calculée ne parvient pas à rendre compte de la relation entre et .
Poursuivons en construisant un modèle de régression linéaire dans R. On utilise pour cela la fonction lm(), disponible en base R (aucun package à installer).
modell <- lm(glucose ~ mass, data=PimaIndiansDiabetes)

summary(modell)Call:
lm(formula = glucose ~ mass, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-128.970 -20.756 -3.705 19.509 81.568
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 92.2129 4.7083 19.585 < 0.0000000000000002 ***
mass 0.8965 0.1429 6.274 0.000000000589 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.2 on 766 degrees of freedom
Multiple R-squared: 0.04887, Adjusted R-squared: 0.04763
F-statistic: 39.36 on 1 and 766 DF, p-value: 0.0000000005891Les résultats ci-dessus montrent ce qui suit :
- L'ordonnée à l'origine vaut 92,2, ce qui signifie que la droite de régression coupe l'axe des Y en Y = 92,2, ce qui semble concorder avec l'examen graphique.
- , c'est-à-dire le coefficient de mass, vaut 0,8965. Cela signifie que si
massaugmente de 1 unité,glucoseaugmente de 0,8965 unité.
Calcul de la droite de régression
Le calcul de la droite de régression est fondamental en analyse de régression. La méthode la plus courante est la least-squares method (en français, méthode des moindres carrés). On parle aussi de ordinary least-squares (moindres carrés ordinaires). Cette méthode produit une droite qui minimise la somme des erreurs (error). Dans la figure ci-dessous, les mêmes données que précédemment (les Indiens Pima) ont été agrandies sur l'intervalle 50 à 150 de l'axe des x et de l'axe des y afin de mieux faire comprendre ce que sont les sommes des carrés. La figure montre également une droite de régression.
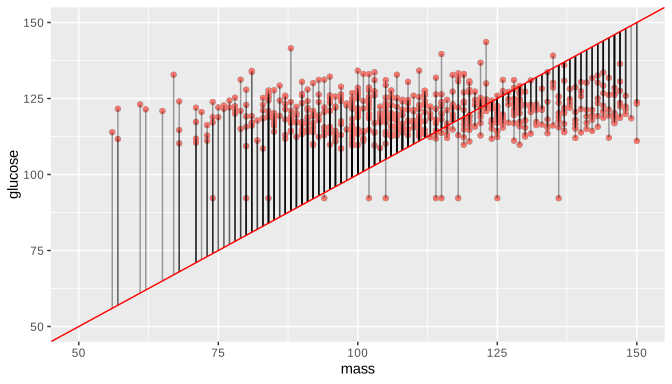
La méthode des moindres carrés vise à obtenir une droite de régression qui minimise la somme des erreurs de toutes les observations. La figure ci-dessus montre que la distance entre la droite de régression et les points varie beaucoup. Dans l'intervalle 100 à 140 de l'axe des x, la droite est proche des points (l'erreur est faible), mais en dehors de cet intervalle elle s'en éloigne davantage (l'erreur est plus grande). La méthode des moindres carrés consiste à minimiser l'erreur cumulée (totale). La droite est inclinée dans un sens puis dans l'autre jusqu'à ce que sa pente minimise la somme de toutes les erreurs. Avant d'additionner les erreurs, on les élève au carré ; le but est que toutes les erreurs négatives (celles des points situés sous la droite) deviennent des valeurs positives. La somme de toutes les erreurs au carré est appelée RSS (Residual Sum of Squares), ou somme des carrés des résidus. La tâche du modèle linéaire est donc de trouver les valeurs de et qui minimisent la RSS. La formule de la RSS est la suivante :
Coefficient de détermination : R2
Pour estimer la force de la relation entre et , on peut utiliser le coefficient de détermination (coefficient of determination), également appelé . Cette valeur va de 0 à 1. Si vaut 0, il n'existe aucune relation, et si vaut 1, la relation est parfaite, ce qui signifie que explique toute la variation de .
Hypothèses de la régression par la méthode des moindres carrés
Les hypothèses suivantes doivent être vérifiées pour pouvoir utiliser la méthode des moindres carrés :
- Les résidus doivent suivre une loi normale de moyenne 0. Cela peut être vérifié à l'aide d'un diagramme quantile-quantile (quantile-quantile plot). Si l'hypothèse est satisfaite, ce diagramme doit montrer une droite.
- Les résidus doivent avoir une variance constante. Cela peut être vérifié à l'aide d'un nuage de points (scatterplot) des résidus estimés en fonction des valeurs ajustées (fitted values). Le graphique doit montrer un nuage de points sans relation entre les valeurs.
- Les résidus doivent être indépendants les uns des autres. Cela pose rarement problème, sauf si une même personne, cellule, bactérie, unité, etc., figure plusieurs fois dans la population d'étude. Si une même personne figure plusieurs fois dans la population d'étude (par exemple en raison de mesures répétées de l'IMC et du glucose), les résidus de ces observations sont dépendants les uns des autres.
Les points (1) et (2) peuvent être examinés facilement dans R avec la commande suivante, qui renvoie tous les graphiques nécessaires :
plot(modell)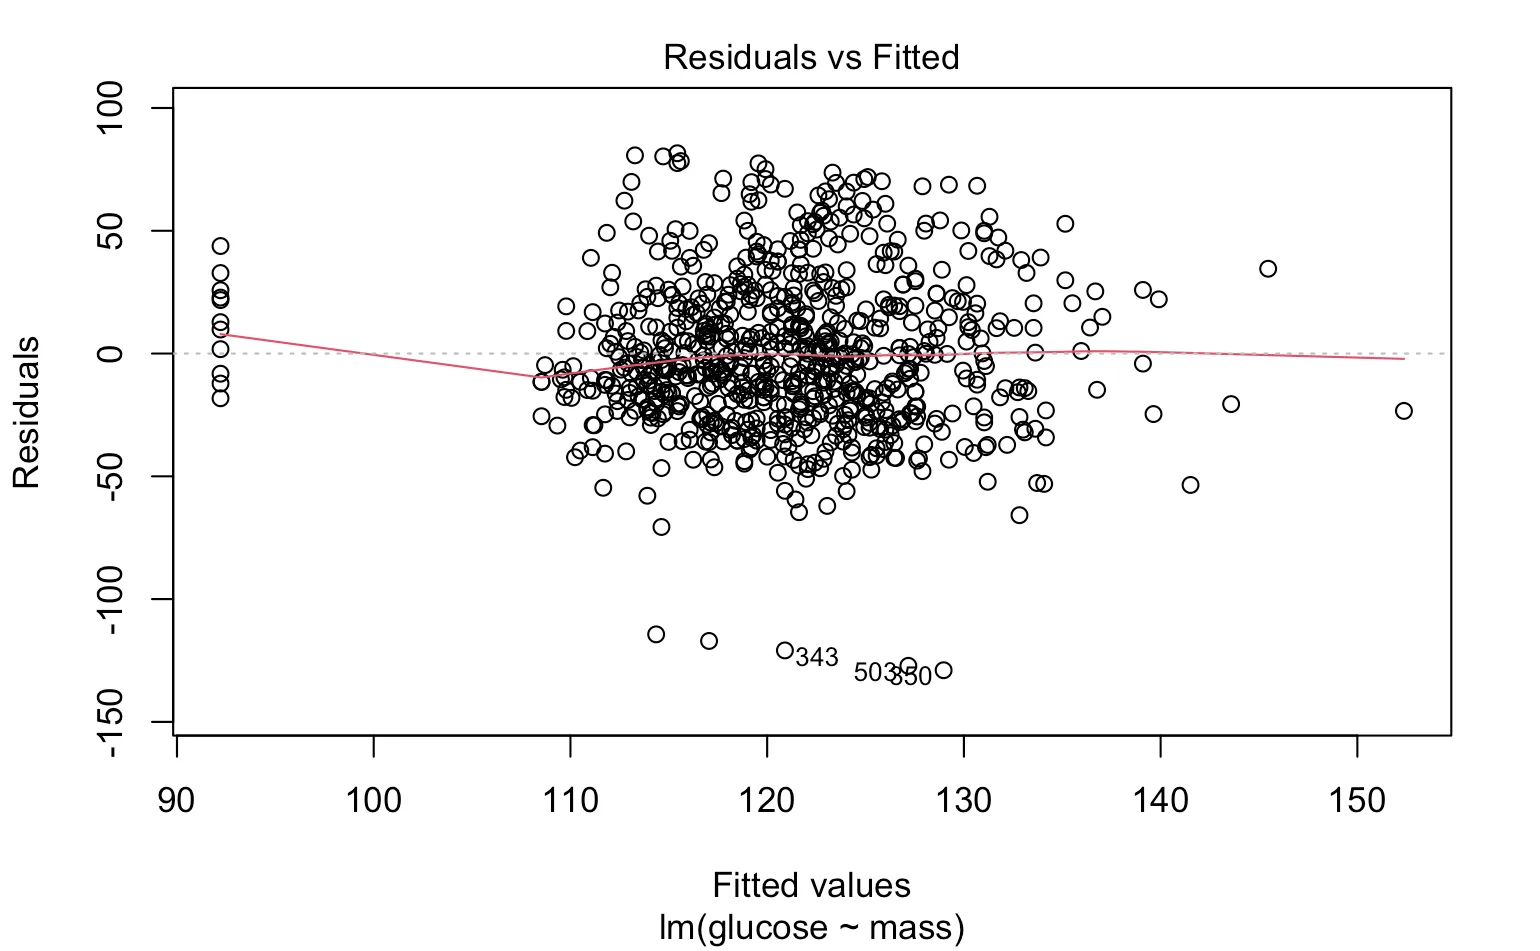
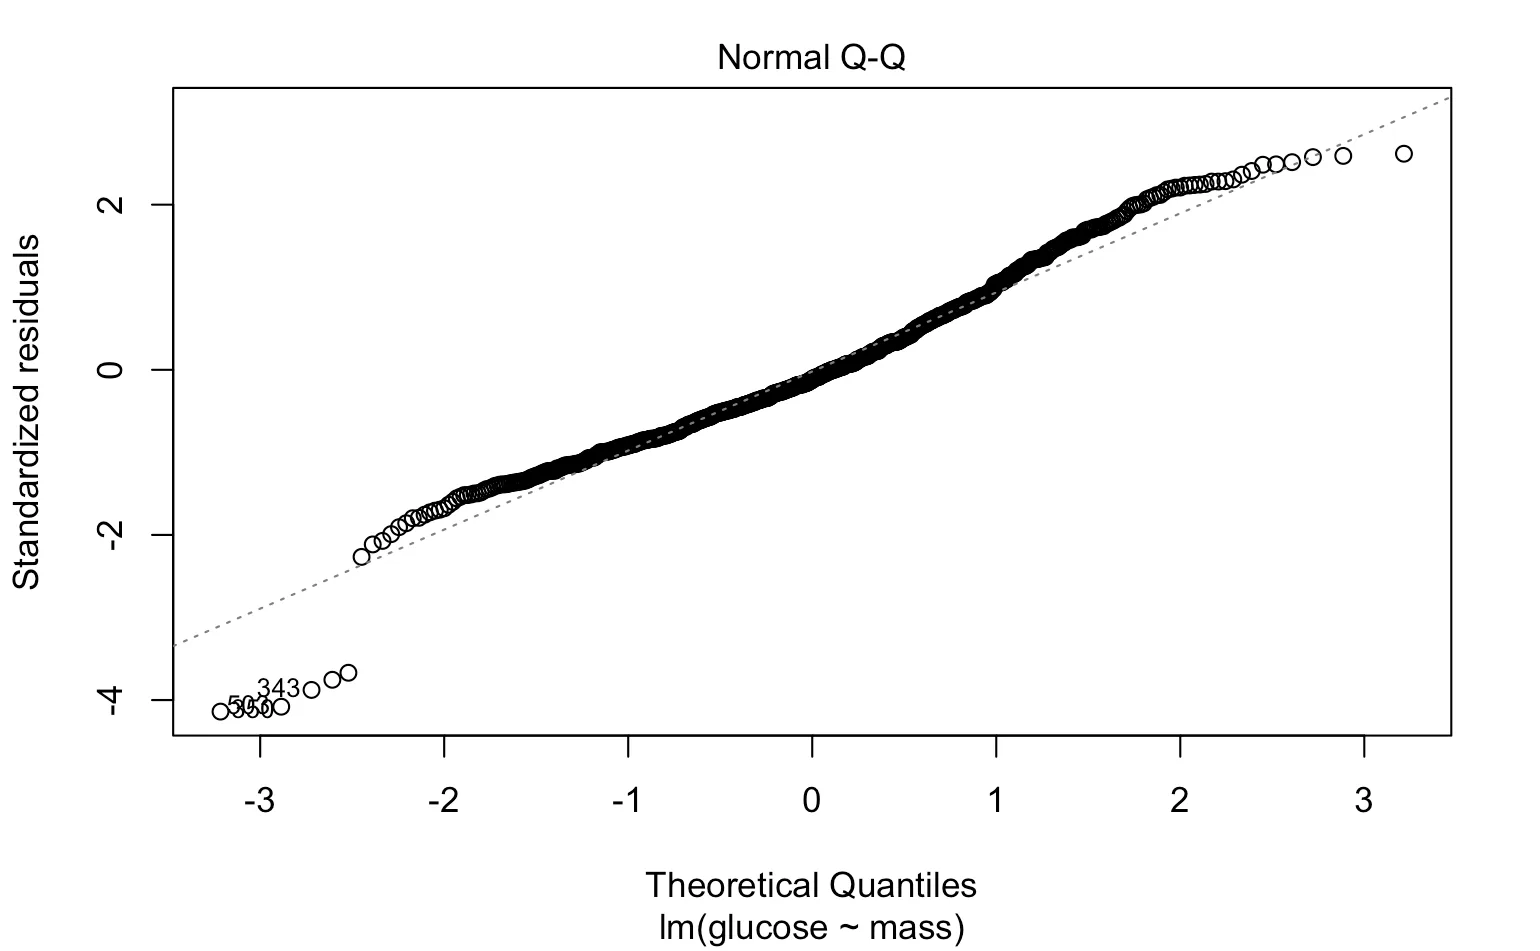
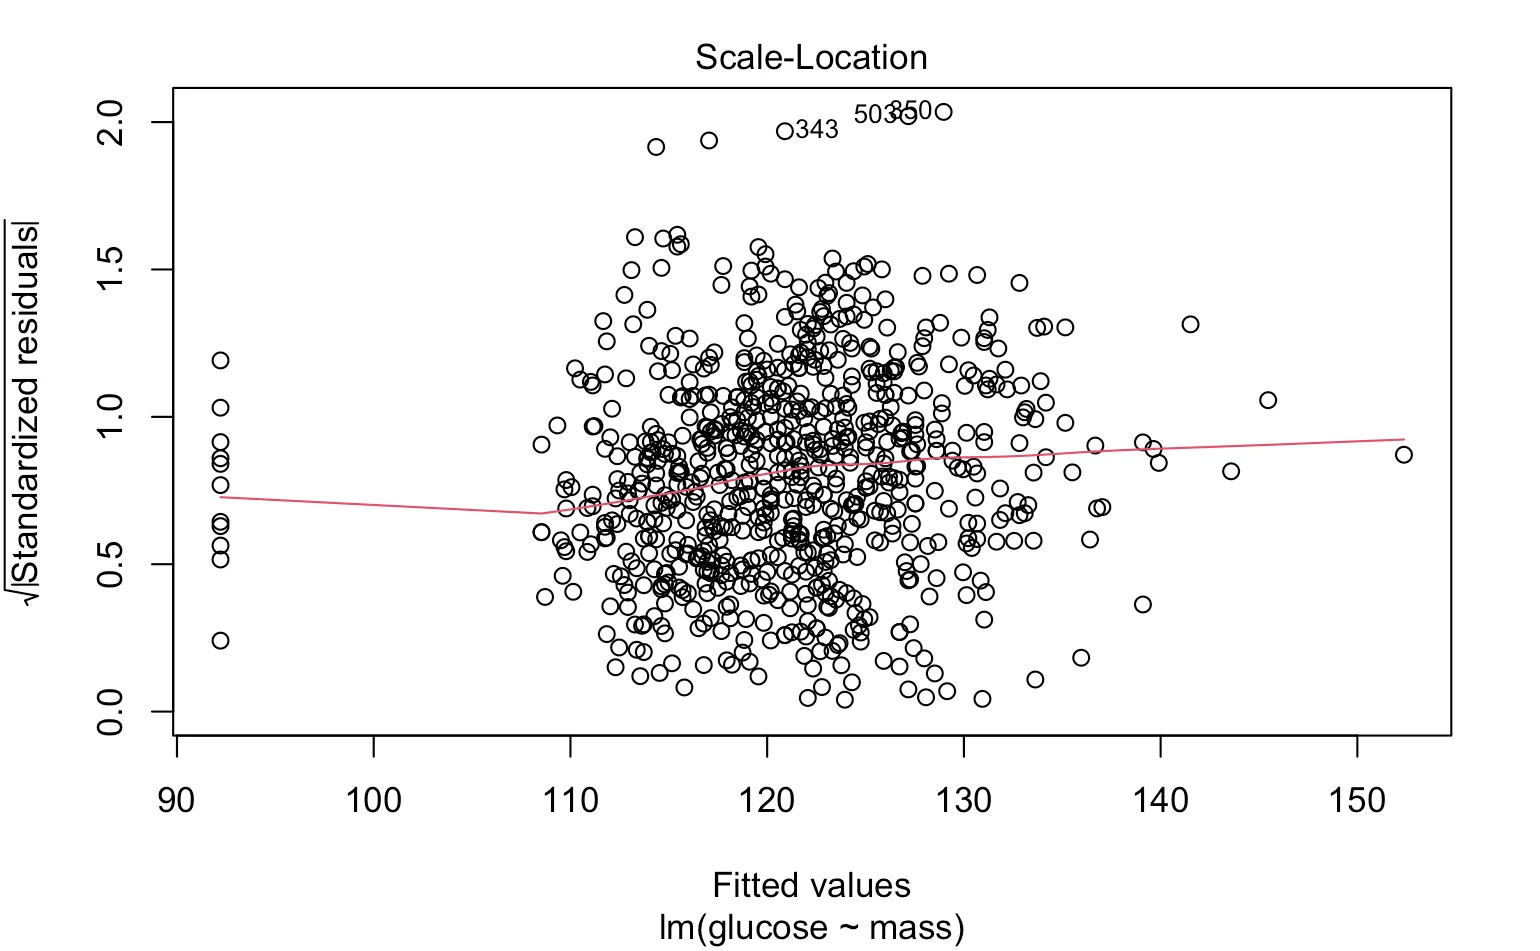
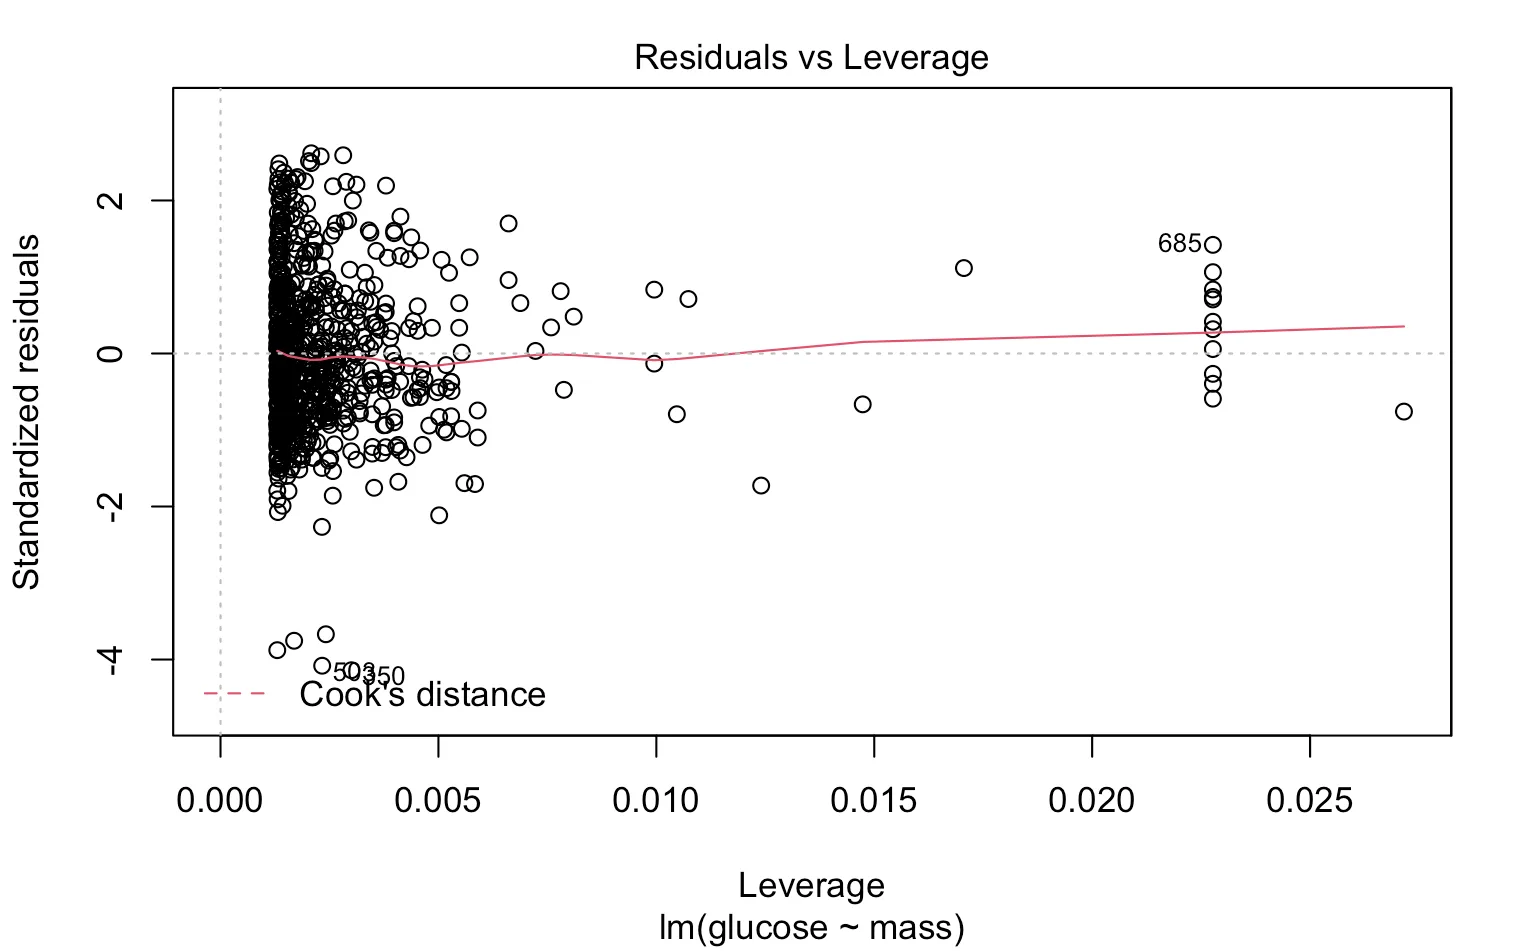
Prédiction par régression
Le modèle de régression peut servir à la prédiction. Cela signifie que nous pouvons estimer la valeur de Y pour une valeur donnée de X. Il peut par exemple être intéressant de prévoir quelle sera la valeur de glucose pour une valeur donnée de mass. Pour ce faire, nous créons maintenant un nouveau modèle avec la spécification glucose ~ ., ce qui signifie que nous modélisons glucose en fonction de toutes les autres variables. Nous utilisons ensuite predict() avec l'objet modèle (modell_2) en précisant les données sur lesquelles nous voulons tester le modèle. Ici, nous le testons sur les données mêmes qui ont servi à l'entraîner, ce qui n'est pas recommandé. Nous enregistrons la valeur prédite dans une nouvelle colonne (Predicted_Glucose) du même data frame. Enfin, nous affichons les 10 premières lignes avec les valeurs observées et les valeurs prédites.
modell_2 <- lm(glucose ~ ., data=PimaIndiansDiabetes)

PimaIndiansDiabetes$Predicted_Glucose <- predict(modell_2, newdata=PimaIndiansDiabetes)

select(PimaIndiansDiabetes, glucose, Predicted_Glucose) %>%
  slice(1:10)
glucose Predicted_Glucose
1 148 134.03797
2 85 100.53489
3 183 130.46052
4 89 106.04599
5 137 145.69693
6 116 106.94069
7 78 128.57557
8 115 98.26398
9 197 181.40914
10 125 136.97599Régression multiple
Si nous voulons étudier comment l'IMC (mass) covarie avec le glucose (glucose) tout en tenant compte de l'âge, nous utilisons la régression multiple. La régression multiple se définit simplement comme une régression comportant au moins 2 prédicteurs. Elle obéit aux mêmes principes que la régression linéaire présentée jusqu'ici. La méthode des moindres carrés est utilisée comme d'habitude, mais dans ce cas on n'ajuste pas une droite de régression : on ajuste un plan de régression à travers les points de données. Ce plan a un aspect tridimensionnel, illustré ci-dessous avec les mêmes données. Le second prédicteur est pressure (pression artérielle).
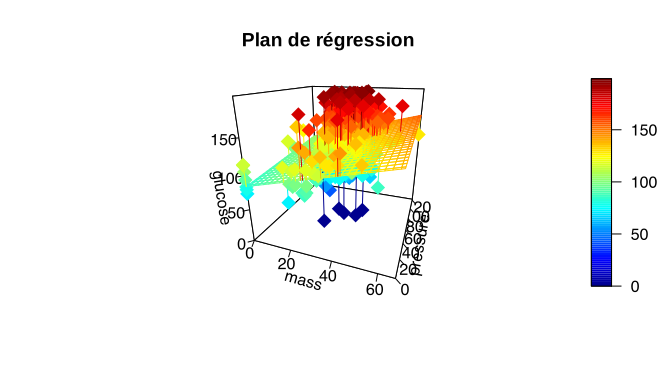
Le code du modèle de régression est le suivant :
modell_2 <- lm(glucose ~ mass + pressure, data=PimaIndiansDiabetes)
summary(modell_2)Call:
lm(formula = glucose ~ mass + pressure, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-129.725 -20.893 -3.277 19.206 80.092
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 84.60294 5.48135 15.435 < 0.0000000000000002 ***
mass 0.78442 0.14834 5.288 0.000000161 ***
pressure 0.16201 0.06042 2.681 0.00749 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.08 on 765 degrees of freedom
Multiple R-squared: 0.05773, Adjusted R-squared: 0.05526
F-statistic: 23.43 on 2 and 765 DF, p-value: 0.0000000001326Les coefficients s'interprètent comme suit.
- Lorsque
massaugmente de 1 unité,glucoseaugmente de 0,78442 unité. Cet effet est ajusté sur pressure. - Lorsque
pressureaugmente de 1 unité,glucoseaugmente de 0,16201 unité. Cet effet est ajusté surmass.