
Termes et notions de l'IA et de l'apprentissage automatique
Données
Bien que ce terme soit défini de manière assez floue, il désigne généralement les données dont on dispose. Dans le cas de la boutique en ligne, les données sont les informations sur les visiteurs et leurs achats. Les données ne se présentent toutefois pas nécessairement sous forme de tableau ; les images, les vidéos, les graphiques, etc. sont également des données.
Modèle (modèle de prédiction)
Pour étudier des données, on utilise des fonctions mathématiques, et la synthèse de ces fonctions est appelée modèle. On dit que l'on utilise des données pour construire un modèle. Ce modèle peut ensuite servir, par exemple, à prédire si de nouveaux patients développeront un cancer, ou si de nouveaux visiteurs feront des achats dans la boutique en ligne. Le modèle résume ce que l'ordinateur a appris par apprentissage automatique (machine learning). Les termes modèle et modèle de prédiction sont synonymes dans ce contexte.
Entraînement (training)
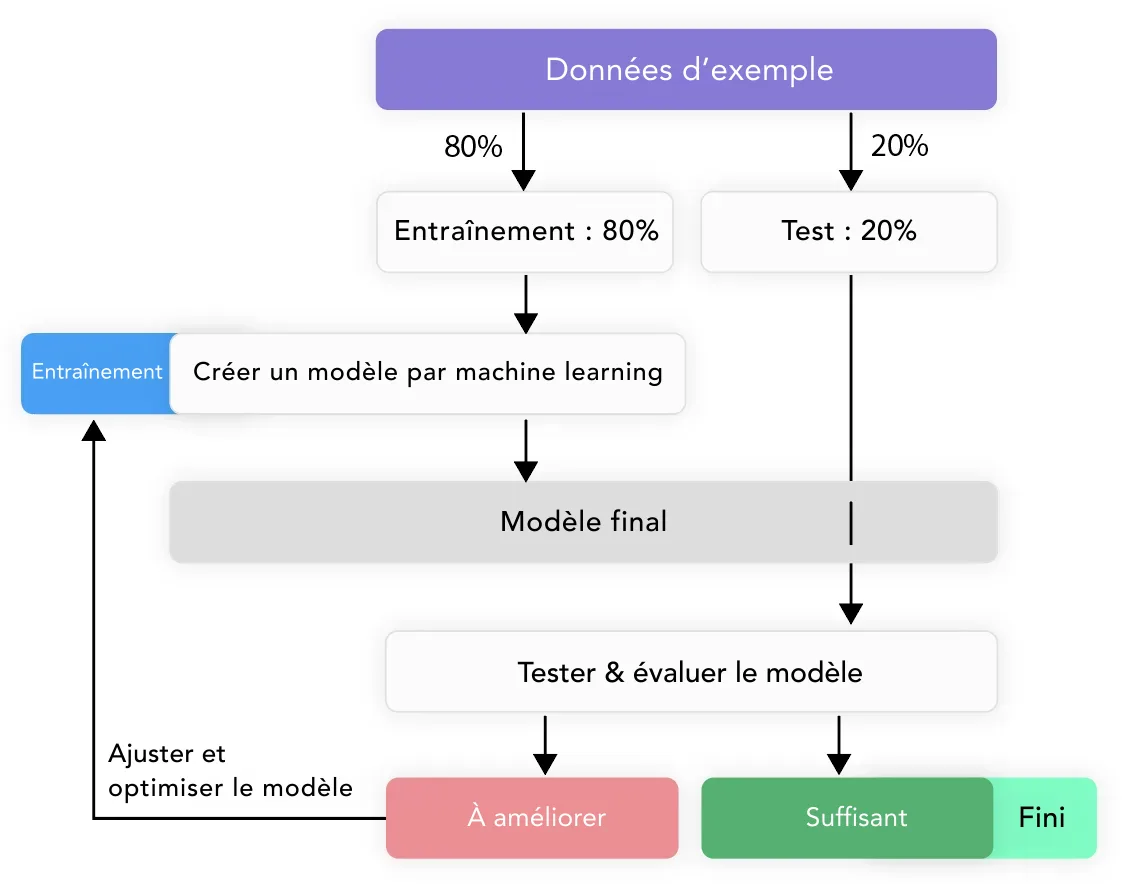
Pour créer un modèle, il faut des données d'exemple. Dans l'exemple de la boutique en ligne, nous avions besoin de données sur de nombreux visiteurs et leur comportement avant de pouvoir faire des prédictions sur de nouveaux visiteurs. Les données d'exemple (données d'entraînement) servent à ce que l'apprentissage automatique découvre les motifs présents dans les données. Cette phase est appelée entraînement (en anglais training), car la machine est entraînée à l'aide des données d'exemple. On utilise en règle générale 80 % de l'ensemble des données pour l'entraînement.
Test (testing)
Les 20 % des données qui ne sont pas utilisés pour l'entraînement peuvent servir au test. Lors du test, on évalue la qualité du modèle, et cette évaluation doit être réalisée sur des données sur lesquelles le modèle n'a pas été entraîné. Le test consiste donc à évaluer la précision ou la performance du modèle.
Il est important de toujours tester le modèle sur des données qu'il n'a pas étudiées pendant la phase d'entraînement. En effet, le modèle aura toujours une précision élevée sur les données qu'il a « vues pendant l'entraînement ». La précision sur les données de test sera toujours plus faible, et c'est cette précision qui nous intéresse, car elle donne une meilleure indication de la performance du modèle sur des données futures. La répartition 80/20 peut être ajustée selon la situation et les données.
Variable
Par variable, on entend généralement les colonnes d'un tableau. Chaque colonne décrit une caractéristique des unités étudiées (patients, visiteurs, etc.).
Prédicteur (feature)
Toutes les variables utilisées pour prédire le critère de jugement sont des prédicteurs. Autrement dit, un prédicteur est une variable utilisée pour prédire le critère de jugement. Dans l'exemple des élèves, leur assiduité scolaire et le revenu de leurs parents sont des exemples de prédicteurs.
Critère de jugement, outcome, label
Le critère de jugement est ce que l'on cherche à prédire à l'aide du modèle. Dans l'exemple des élèves, le critère de jugement est leur note finale. Dans l'exemple de la boutique en ligne, le critère de jugement est le fait que les visiteurs achètent ou non des articles. Le critère de jugement est donc ce que l'on cherche à prédire.