
Régression logistique
Synonymes : régression logit, modèle logit
La régression linéaire permet d'étudier des variables de résultat continues (), par exemple le poids corporel, la pression artérielle, le revenu ou un prix. Elle ne doit cependant pas être utilisée pour étudier des variables de résultat binaires, c'est-à-dire comportant deux catégories. On parle de variable binaire lorsque le résultat est classé en oui/non, 0/1, malade/sain, bon/mauvais, satisfait/insatisfait, peu/beaucoup, etc.
Plusieurs raisons font que la régression linéaire ne doit être utilisée ni pour les variables de résultat binaires, ni pour les variables catégorielles à plus de 2 catégories. La première raison est conceptuelle et peut être illustrée par une variable catégorielle à trois niveaux. Supposons que nous étudiions l'association entre le prédicteur et un diagnostic , qui peut prendre l'une des catégories suivantes : accident vasculaire cérébral (AVC), épilepsie ou maladie de Parkinson. Pour utiliser la régression linéaire, nous codons ces diagnostics par les chiffres 1 à 3. Nous définissons notre variable de résultat comme suit :
Définir la variable de résultat de cette manière pose plusieurs problèmes. Tout d'abord, cela revient à affirmer qu'il existe un ordre intrinsèque entre les diagnostics, ce qui n'est pas le cas ici. De plus, cela implique que la différence entre l'AVC et l'épilepsie (différence numérique de 1) est aussi grande que la différence entre l'épilepsie et la maladie de Parkinson (différence numérique de 1), ce qui est une comparaison irrationnelle.
Si l'objectif du modèle de régression est d'étudier comment divers prédicteurs () sont liés au risque de ces diagnostics (Y), le modèle linéaire conduit à des résultats absurdes. Pour l'illustrer, nous construisons une régression linéaire à partir des données PimaIndiansDiabetes, disponibles dans le package mlbench. Le package peut être installé avec la commande install.packages("mlbench"). Dans PimaIndiansDiabetes, la variable diabetes est codée neg (negative) ou pos (positive), que nous recodons respectivement en 0 et 1 afin de pouvoir réaliser une régression linéaire. Dans ce cas précis, nous construisons la régression linéaire directement dans ggplot() (on utilise habituellement la fonction lm()). Avec ggplot(), nous traçons un nuage de points avec glucose sur l'axe des x et diabetes sur l'axe des y, puis nous utilisons geom_smooth() pour ajuster une régression linéaire aux données.
library(mlbench)
data("PimaIndiansDiabetes")

## Recodage de diabetes en 0 / 1
PimaIndiansDiabetes$diabetes <- ifelse(PimaIndiansDiabetes$diabetes=='pos', 1, 0)

## Modèle de régression linéaire
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5, size=3) +
  geom_smooth(method = "lm") +
  labs(title = "Linjär regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")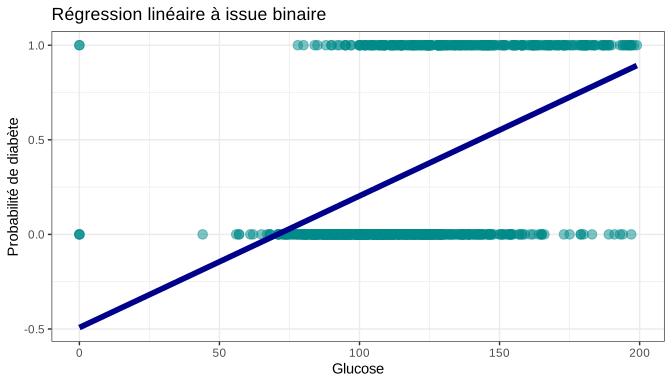
Le graphique ci-dessus est problématique. Tout d'abord, le modèle prédit des probabilités négatives pour glucose < 75. Une probabilité ne peut jamais être négative. En outre, le modèle prédirait une probabilité > 1 pour des valeurs élevées (> 200) de glucose. Une probabilité ne peut jamais dépasser 1,0. Il est donc évident que la régression linéaire n'est pas adaptée aux variables de résultat catégorielles.
La solution mathématique à ce problème consiste à construire un modèle de régression qui produit toujours une prédiction comprise entre 0 et 1, quelle que soit la valeur du prédicteur . Pour ce faire, la variable de résultat doit être traitée comme une probabilité (), qui est toujours comprise entre 0 et 1. On y parvient à l'aide de la fonction logit ou log odds :
Dans la formule ci-dessus, correspond à l'odds (la cote) de l'événement. La notion d'odds est essentielle pour comprendre la suite de la discussion.
Odds
L'odds est au cœur de la régression logistique. Dans une régression logistique, la variable de résultat est binaire (0/1). On peut la considérer comme une situation dans laquelle un événement peut ne pas survenir (0) ou survenir (1). Le modèle logistique calcule l'odds de survenue de l'événement. L'odds est la probabilité qu'un événement survienne divisée par la probabilité qu'il ne survienne pas. On trouvera ci-dessous la définition de l'odds pour un événement défini en oui/non, où est la probabilité.
Ce qui équivaut à :
Exemple 1 : Quel est l'odds d'obtenir un chiffre pair (2, 4 ou 6) lors d'un lancer de dé ?
Réponse : Un dé comporte six chiffres (1, 2, 3, 4, 5, 6). La probabilité d'obtenir 2, 4 ou 6 est de 3/6. La probabilité de ne pas obtenir 2, 4 ou 6 est également de 3/6. L'odds se calcule comme suit :
Un odds de 1,0 signifie que l'événement a autant de chances de survenir que de ne pas survenir.
Exemple 2 : Quel est l'odds d'obtenir l'un des chiffres 1, 2, 3 ou 4 lors d'un lancer de dé ?
Réponse : La probabilité d'obtenir 1, 2, 3 ou 4 est de 4/6 et la probabilité de tout autre résultat est de 2/6. L'odds se calcule comme suit :
L'odds est donc de 2,0, ce qui signifie que la probabilité que l'événement survienne est deux fois plus élevée que la probabilité qu'il ne survienne pas.
Revenons maintenant à la discussion sur le logit.
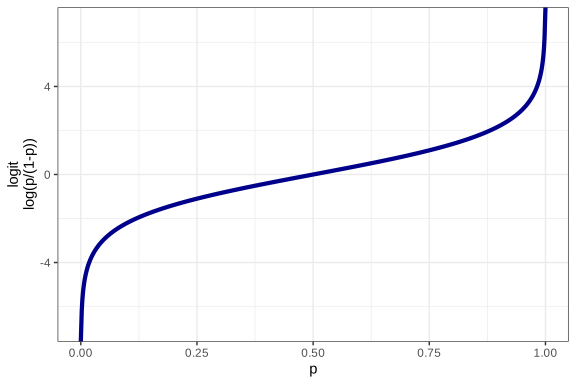
La figure ci-dessous représente en fonction du logit (log odds). La figure montre que le logit permet de convertir des probabilités en n'importe quelle valeur d'odds.
On peut calculer des probabilités à partir du log odds à l'aide de la fonction logistique (logistic function) :
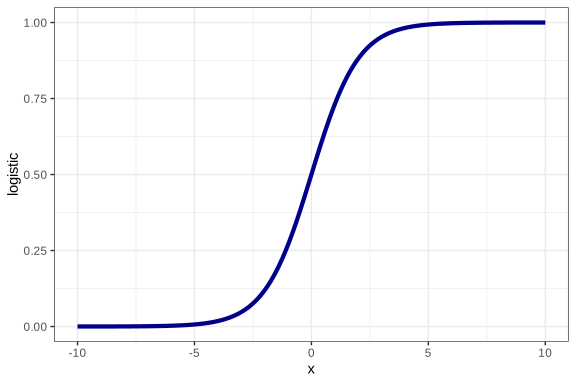
Cette fonction peut être représentée comme le montre la figure ci-dessous. On remarque que la probabilité (axe des y) est comprise entre 0 et 1, quelle que soit la valeur du prédicteur .
En transformant la probabilité au moyen du logit, on obtient une valeur qui peut être prédite par une équation linéaire, comme suit :
La fonction logit permet donc de relier à . Le logit peut ainsi être considéré comme une fonction de lien (link function). En régression logistique, le logarithme de l'odds est donc une fonction linéaire des prédicteurs.
Si l'on applique cette fonction aux mêmes données que ci-dessus (prédiction du diabète), le modèle de régression prend la forme suivante :
PimaIndiansDiabetes %>%
  ggplot(aes(glucose, diabetes)) +
  geom_point(alpha = 0.5) +
  geom_smooth(method = "glm", method.args = list(family = "binomial")) +
  labs(title = "Logistisk regression med binärt utfall",
       x = "Glucose",
       y = "Sannolikhet för diabetes")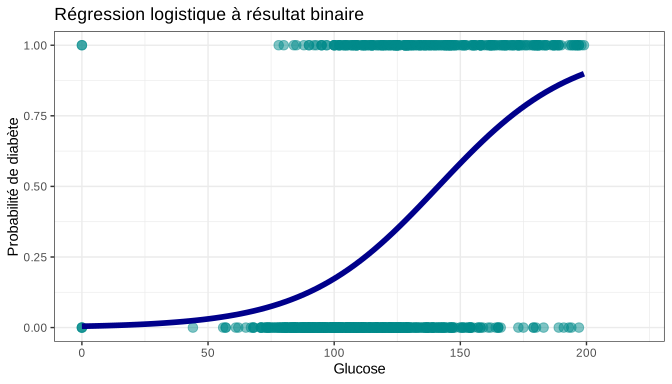
Ce modèle produira toujours des probabilités comprises entre 0 et 1.
Interprétation de la régression logistique
Le coefficient de régression () représente la variation du logarithme de l'odds de l'événement lorsque le prédicteur augmente d'une unité. Cela rappelle la régression linéaire, où représente la variation de lorsque le prédicteur augmente d'une unité. En régression logistique, c'est donc le logarithme de l'odds de l'événement qui varie.
Odds ratio (rapport de cotes)
La probabilité est une notion difficile à appréhender. Interpréter des probabilités logarithmiques l'est encore davantage. C'est pourquoi nous transformons le coefficient de régression en l'exponentiant, ce qui donne un rapport de cotes (odds ratio, OR). L'odds ratio est nettement plus facile à interpréter. Voici un exemple :
- Pour le prédicteur , nous obtenons un coefficient de régression de 0,5, ce qui signifie que lorsque le prédicteur augmente d'une unité, le logarithme de l'odds de survenue de l'événement augmente de 0,5.
- Nous exponentions le coefficient :
- Cela signifie que lorsque le prédicteur augmente d'une unité, l'odds de l'événement augmente de 65 %.
On peut donc convertir un odds ratio en pourcentage ! On utilise pour cela la formule : .
Exemple 1 : Odds ratio = 1,10. Calcul : 100•(1,10 – 1) = 10 %. Interprétation : pour chaque unité d'augmentation du prédicteur X, l'odds de l'événement augmente de 10 %.
Exemple 2 : Odds ratio = 0,90. Calcul : 100•(0,9 – 1) = –10 %. Interprétation : pour chaque unité d'augmentation du prédicteur X, l'odds de l'événement diminue de 10 %.
Un odds ratio (rapport de cotes) de 1,0 signifie que le prédicteur n'est pas associé à , puisqu'une augmentation ou une diminution de n'influe pas sur l'odds de l'événement . Si l'odds ratio est supérieur à 1,0, l'odds de l'événement augmente, et s'il est inférieur à 1,0, l'odds de l'événement diminue. Un odds ratio de 1,50 correspond à une augmentation de 50 % de l'odds et un odds ratio de 0,5 à une diminution de 50 % de l'odds.
Avec l'odds ratio, la variation en pourcentage de l'odds est la même chaque fois que le prédicteur augmente d'une unité. Cela tient au fait que la régression logistique suppose une relation linéaire entre et log(odds).
Exemple de régression logistique
Nous construisons une régression logistique à partir des données PimaIndiansDiabetes, disponibles dans le package mlbench. Installez le package avec la commande install.packages("mlbench"). Dans les données, la variable diabetes est codée pos (positive) ou neg (negative). La régression logistique est réalisée à l'aide de la fonction glm(), incluse dans l'installation de base de R. GLM signifie generalized linear model (modèle linéaire généralisé), qui estime des modèles linéaires au moyen d'une fonction de lien (link function). En régression logistique, le log odds (logit) est la fonction de lien. Le modèle se spécifie comme suit :
diabetes="pos" ~ glucose + agesignifie que c'est la catégorie "pos" que nous voulons prédire à l'aide des variables glucose et age.family = binomial(link = logit)indique la fonction de lien que GLM doit utiliser.
library(mlbench)
data("PimaIndiansDiabetes")

min_modell <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)
Résultat du modèle avec la fonction summary() de base R :
summary(min_modell)Call:
glm(formula = diabetes == "pos" ~ glucose + age, family = binomial(link = logit),
data = PimaIndiansDiabetes)
Deviance Residuals:
Min 1Q Median 3Q Max
-2.3367 -0.7775 -0.5087 0.8367 3.1630
Coefficients:
Estimate Std. Error z value Pr(>|z|)
(Intercept) -5.912449 0.462620 -12.78 < 0.0000000000000002 ***
glucose 0.035644 0.003290 10.83 < 0.0000000000000002 ***
age 0.024778 0.007374 3.36 0.000778 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
(Dispersion parameter for binomial family taken to be 1)
Null deviance: 993.48 on 767 degrees of freedom
Residual deviance: 797.36 on 765 degrees of freedom
AIC: 803.36
Number of Fisher Scoring iterations: 4Les coefficients de régression sont présentés sous la rubrique Coefficients. Les deux coefficients (voir Estimate pour glucose et age) sont positifs (> 0). De plus, les valeurs p sont < 0,005, ce qui signifie que les coefficients sont statistiquement significatifs.
Dans une publication scientifique, on souhaite le plus souvent présenter l'odds ratio (OR) avec son intervalle de confiance à 95 %. Pour ce faire, nous utilisons la fonction tidy du package broom. Rappelons que le coefficient est le log odds de Y, ce qui signifie qu'il doit être exponentié pour obtenir l'odds ratio. La commande ci-dessous demande à la fois l'exponentiation et l'intervalle de confiance à 95 % :
library(broom)
tidy(min_modell, exponentiate=T, conf.int=T)
## A tibble: 3 × 7
term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 0.00271 0.463 -12.8 2.11e-37 0.00106 0.00653
2 glucose 1.04 0.00329 10.8 2.37e-27 1.03 1.04
3 age 1.03 0.00737 3.36 7.78e- 4 1.01 1.04Le résultat ci-dessus s'interprète comme suit :
- Estimate est l'odds ratio de l'événement Y.
- Lorsque glucose augmente d'une unité, le risque de diabète augmente de 4 %.
- Lorsque age augmente d'une unité, le risque de diabète augmente de 3 %.
- conf.low et conf.high indiquent un intervalle de confiance à 95 %. Avec une confiance de 95 %, l'odds ratio est compris entre 1,03 et 1,04 pour glucose, ce qui signifie qu'une augmentation d'une unité de glucose entraîne, avec une confiance de 95 %, une probabilité de diabète supérieure de 3 % à 4 %.
Les diagnostics du modèle s'obtiennent efficacement avec la fonction check_model() du package easystats :
library(easystats)
check_model(min_modell)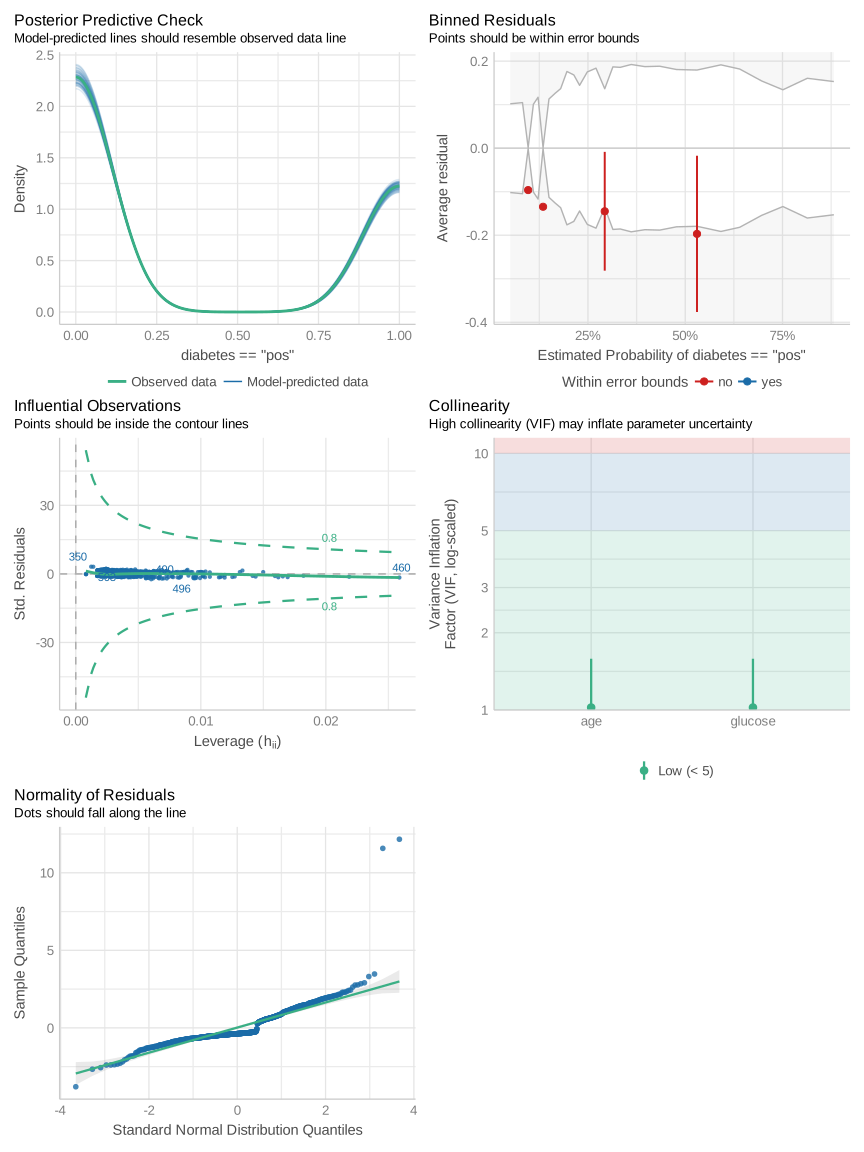
Prédire avec la régression logistique
Le modèle de régression permet de faire des prédictions à l'aide de la fonction predict(). Voici deux exemples dans lesquels nous faisons une prédiction pour une seule personne en créant un nouveau dataframe contenant ses valeurs de glucose et d'age :
## Définir une nouvelle observation et nommer l'objet "new_patient"
new_patient = data.frame(age=50,
                         glucose=150)

## Prédire la probabilité de diabète
predict(min_modell, newdata=new_patient, type="response")0.00422564Le chiffre ci-dessus est la probabilité () que la personne soit atteinte de diabète.
Courbe ROC du modèle
La capacité prédictive du modèle est généralement évaluée à l'aide d'une courbe ROC. Ci-dessous, nous créons trois variantes du modèle et les comparons au moyen de la courbe ROC. Notons toutefois que la comparaison de différents modèles doit de préférence reposer sur une forme de rééchantillonnage, idéalement la validation croisée (voir le chapitre Évaluer et comparer des modèles).
## Un modèle avec glucose et age
min_modell_1 <- glm(diabetes=="pos" ~ glucose + age,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## Un modèle avec glucose, age, insulin et pressure
min_modell_2 <- glm(diabetes=="pos" ~ glucose + age + insulin + pressure,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

## Un modèle avec tous les prédicteurs disponibles dans les données
## Le point (.) est un raccourci pour "tous les prédicteurs"
min_modell_3 <- glm(diabetes=="pos" ~ .,
                  family = binomial(link = logit),
                  data=PimaIndiansDiabetes)

library(easystats)
plot(performance_roc(min_modell_1, min_modell_2, min_modell_3))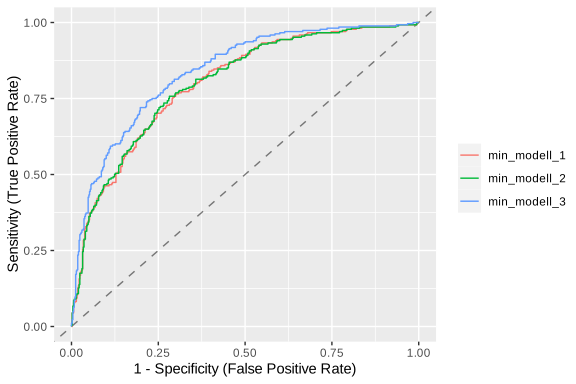
Régression logistique multiple
Comme le montrent les exemples ci-dessus, on peut inclure plusieurs prédicteurs dans le modèle logistique, qui accepte des prédicteurs aussi bien catégoriels que continus. Lorsque le modèle comporte plusieurs prédicteurs, le coefficient de chaque prédicteur s'interprète comme son « effet » lorsque les autres prédicteurs sont maintenus constants. L'« effet » du prédicteur est donc celui observé après ajustement sur les autres prédicteurs du modèle.
Estimation du maximum de vraisemblance (MLE) : calcul des coefficients de régression en régression logistique
Rappelons que le modèle linéaire dispose d'une formule simple pour trouver les paramètres du modèle (ordonnée à l'origine et coefficients de régression). L'équation correspond à la droite de régression qui décrit le mieux les données. On l'obtient en minimisant la somme de toutes les erreurs (voir Régression linéaire). Pour la régression logistique, il n'existe pas d'équation simple à résoudre. Le logiciel doit plutôt trouver les paramètres à l'aide de fonctions d'optimisation (optimizer functions). La méthode la plus courante pour y parvenir est la MLE (maximum likelihood estimation).
L'estimation du maximum de vraisemblance (MLE, méthode du maximum de vraisemblance) est utilisée de manière générale pour estimer les paramètres d'une distribution de probabilité. La méthode retient les paramètres qui maximisent la probabilité d'obtenir les résultats observés. Elle exige l'utilisation d'une distribution de probabilité pour , qui est la loi de Bernoulli dans le cas de la régression logistique. À partir de cette distribution, on peut calculer une fonction de vraisemblance pour les observations des données. Cette fonction peut ensuite être optimisée afin de trouver les paramètres qui décrivent le mieux les données. Le calcul exact de ces paramètres dépasse le cadre de ce cours.