
Comparer et choisir entre plusieurs modèles
Si l'objectif est de développer un modèle de prédiction doté d'une forte capacité prédictive, il faut tester et comparer différents modèles. Se contenter de construire et d'évaluer un seul modèle est une erreur capitale lorsque le but est d'utiliser ce modèle pour faire des prédictions. Pour évaluer et comparer différents modèles, il faut un flux de travail standardisé, résumé dans l'organigramme suivant.
graph TD;
    D(1. Données) --> |"75%"| TD(2. Données d'entraînement);
    D --> |"25%"| Test(7. Données de test);
    TD --> Kand(3. Modèles candidats) --> CV(4. Cross-Validation<br>Validation croisée)
CV --> BP(5. Trouver les meilleurs paramètres)
TD --> OM(6. Réentraîner le modèle)
BP-->OM
OM-->Test
Test-->SE(8. Évaluation finale)
Modèles candidats (candidate models)
Si l'on teste différents types de modèles, c'est parce que l'on ne sait pas à l'avance lequel sera le meilleur. Pour des critères de jugement continus, on peut citer par exemple la régression linéaire, la forêt aléatoire (random forest), le gradient boosting, etc. Pour des critères de jugement binaires, on peut tester la régression logistique, la forêt aléatoire, le gradient boosting, etc. En réalité, pour chaque type de modèle, on peut tester différentes spécifications du modèle. On comprend assez vite que, pour une tâche donnée, il est possible de tester un très grand nombre de modèles, ce qui représente un travail long et fastidieux. Heureusement, il existe dans R un ensemble de packages et de fonctions qui facilitent ce travail. Nous y reviendrons plus loin.
Entraînement (training)
Une fois un certain nombre de modèles sélectionnés, ils doivent être entraînés sur un sous-ensemble de l'ensemble des données. En règle générale, 70 à 80 % des données servent à l'entraînement (« training set »). Les modèles sont ensuite testés sur les données de test (« test set »), qui représentent les 20 à 30 % de données restantes.
Surapprentissage (overfitting)
Évaluer les modèles sur des données de test est une démarche simple mais brillante. Les modèles présentent presque toujours une forte capacité prédictive sur les données d'entraînement, ce qui s'explique par le fait qu'ils ont vu toutes les observations de ces données. Autrement dit, les modèles connaissent les motifs et les relations présents dans les données d'entraînement. Il en résulte une précision faussement élevée sur les données d'entraînement. Le véritable défi consiste à construire un modèle d'une grande précision sur des données futures (que le modèle n'a jamais observées), et c'est précisément le rôle des données de test. Les modèles ne doivent jamais être entraînés sur les données de test. Les observations des données de test sont donc « nouvelles » pour les modèles. La précision obtenue sur les données de test reflète la précision attendue du modèle sur des données nouvelles et futures.
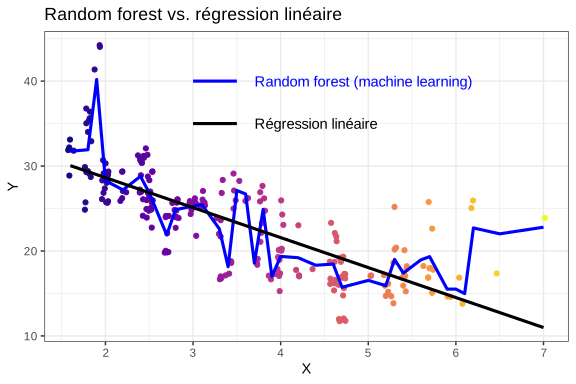
L'importance de ce qui précède apparaît encore plus clairement avec l'apprentissage automatique (machine learning). La plupart des modèles d'apprentissage automatique ne modélisent pas des relations linéaires entre et . Ces modèles peuvent produire des fonctions très flexibles qui épousent les données de très près. Cela signifie que même de petits écarts, insignifiants, dans les relations peuvent être captés et modélisés. C'est ce qu'illustre la figure ci-dessous, qui compare les résultats de deux modèles de prédiction. L'un est une régression linéaire classique, l'autre un modèle d'apprentissage automatique par forêt aléatoire. Les deux modèles ont été entraînés et testés sur le même jeu de données (aucune donnée de test n'a été utilisée). La figure montre que la forêt aléatoire est un modèle très flexible qui suit les données avec une grande précision. Cela peut sembler impressionnant, mais c'est en réalité un inconvénient majeur. Ce phénomène s'appelle surapprentissage (overfitting) : la prédiction du modèle est excellente sur les données d'entraînement (du fait de la flexibilité du modèle), ce qui induit le modèle en erreur lorsqu'il est testé sur de nouvelles données qu'il n'a pas encore observées. Un bon modèle se généralise aux données de test et affiche une grande précision sur des observations qu'il n'a encore jamais rencontrées.
Validation croisée (cross-validation)
Validation croisée à k blocs (k-fold cross-validation)
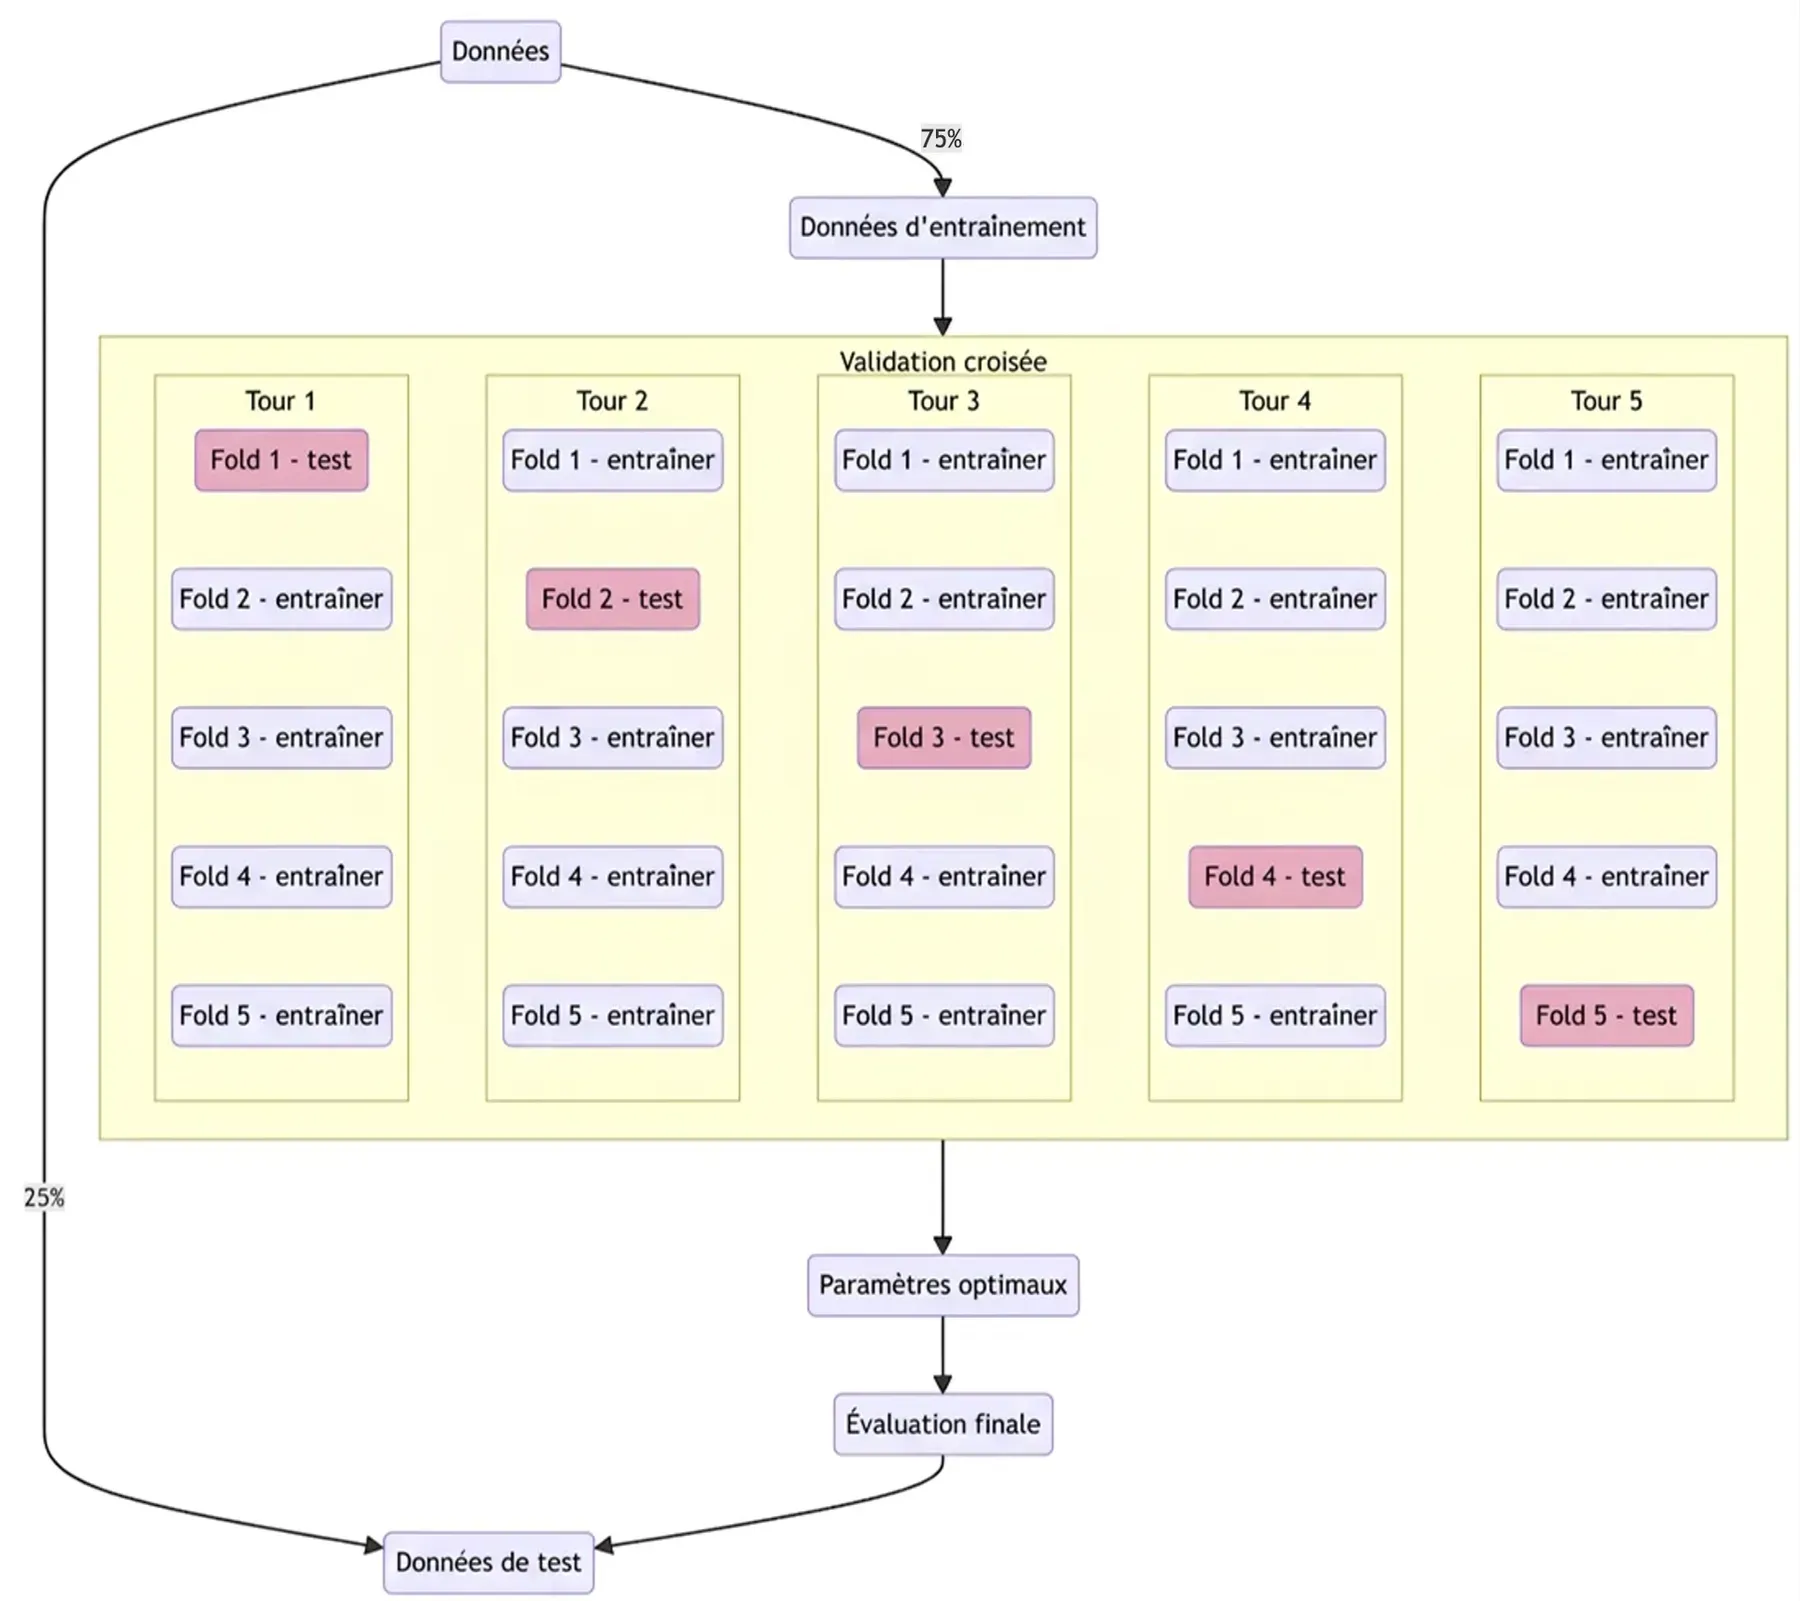
La méthode la plus utilisée pour évaluer des modèles sur les données d'entraînement est la validation croisée (cross-validation). L'organigramme ci-dessous montre comment fonctionne la validation croisée.
- Le jeu de données initial est divisé aléatoirement en données d'entraînement et données de test. La répartition peut être, par exemple, de 75 % et 25 % respectivement.
- Folds (blocs) : les données d'entraînement sont ensuite divisées aléatoirement en blocs (parties) de taille égale. Dans l'exemple ci-dessous, 5 blocs sont créés. Le modèle est entraîné sur 4 d'entre eux et testé sur le dernier bloc (sur lequel le modèle n'a pas été entraîné).
- Repeats (répétitions) : la procédure de l'étape 2 est répétée, mais cette fois 5 nouveaux blocs sont tirés au sort. Comme à l'étape 2, l'entraînement se fait sur 4 d'entre eux et le test sur le dernier bloc.
La figure ci-dessous montre une validation croisée à 5 blocs répétée 5 fois. En pratique, il peut être avantageux de faire 10 répétitions. L'objectif de la validation croisée est d'identifier le meilleur modèle dès l'étape des données d'entraînement, en n'utilisant pas (à chaque répétition) la totalité des données d'entraînement pour l'entraînement. Nous pouvons ainsi évaluer différents types de modèles et, pour chaque modèle, évaluer en outre différentes spécifications. Si le modèle est une régression logistique, nous pouvons évaluer des régressions avec et sans interactions, fonctions splines ou autres transformations des prédicteurs. Il en va de même pour l'apprentissage automatique. Cela signifie qu'à cette étape, nous pouvons identifier les paramètres optimaux.
Le meilleur modèle peut ensuite être appliqué à l'ensemble des données d'entraînement pour estimer à nouveau les paramètres, puis aux données de test pour évaluer sa précision sur des données nouvelles et futures.
Mesures de la capacité prédictive du modèle (evaluation metrics)
Pour comparer des modèles par validation croisée (ou par d'autres méthodes), il faut utiliser une mesure de précision. Il existe toute une série de mesures, et la plus appropriée varie selon la question posée. Certaines règles empiriques sont toutefois adaptées à la plupart des situations. Elles sont présentées dans le chapitre suivant.