
Dans ce chapitre, nous utilisons les données des Indiens Pima. Le diabète est plus fréquent chez les Indiens Pima, et dans ces données 768 individus ont été examinés en ce qui concerne le diabète, la glycémie, etc. Les données se trouvent dans le package mlbench. Vous devez d'abord installer mlbench, puis charger les données. Nous allons en outre créer une copie des données sous la forme de l'objet pima.
## Installer et charger mlbench
install.packages("mlbench")
library(mlbench)

## Charger les données
data(PimaIndiansDiabetes)

## Copier les données
pima <- PimaIndiansDiabetes

## Inspecter les données
head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 pos
2 1 85 66 29 0 26.6 0.351 31 neg
3 8 183 64 0 0 23.3 0.672 32 pos
4 1 89 66 23 94 28.1 0.167 21 neg
5 0 137 40 35 168 43.1 2.288 33 pos
6 5 116 74 0 0 25.6 0.201 30 negLa dernière colonne (diabetes) indique si la personne est diabétique (pos) ou non (neg). À l'étape suivante, nous recodons la colonne diabetes en Yes ou No au lieu de pos et neg respectivement.
pima$diabetes = recode_factor(pima$diabetes,
                              'pos'='Yes',
                              'neg'='No')

head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 Yes
2 1 85 66 29 0 26.6 0.351 31 No
3 8 183 64 0 0 23.3 0.672 32 Yes
4 1 89 66 23 94 28.1 0.167 21 No
5 0 137 40 35 168 43.1 2.288 33 Yes
6 5 116 74 0 0 25.6 0.201 30 NoCréer les données d'entraînement et les données de test
Nous utilisons ensuite la fonction initial_split() pour créer les données d'entraînement et les données de test. Nous indiquons prop=0.7 afin que 70 % des données servent à l'entraînement. Avec les fonctions training() et testing(), nous extrayons ensuite les données d'entraînement et les données de test dans des fichiers distincts.
## Création des jeux d'entraînement et de test
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test  <- testing(pima_split)
Notez que, dans le code ci-dessus, nous avons indiqué strata=diabetes, ce qui signifie que notre partition est stratifiée sur la colonne diabetes : la proportion de Yes et de No est ainsi identique dans les données d'entraînement et dans les données de test. C'est souhaitable, car on veut que la proportion de personnes atteintes de diabète soit la même dans les données d'entraînement et dans les données de test.
Spécifier le modèle et la méthode
Nous commençons par spécifier le type de modèle que nous voulons utiliser. Cela se fait à l'aide des fonctions du package parsnip. Nous commençons par spécifier que nous voulons utiliser une régression logistique, ce que nous faisons avec la fonction logistic_reg() de parsnip. Si nous écrivons seulement le nom de la fonction et exécutons le code, nous obtenons le résultat suivant :
logistic_reg()Logistic Regression Model Specification (classification)
Computational engine: glmOn peut lire ci-dessus qu'un modèle logistique a été spécifié pour effectuer une classification (classification), ce qui signifie que le critère de jugement est une variable catégorielle. Cela sera fait avec glm (modèle linéaire généralisé, generalized linear model), qui est la forme classique de la régression logistique. La méthode (« engine ») GLM est donc la méthode par défaut pour la régression logistique dans Tidymodels. Nous pouvons toutefois spécifier d'autres méthodes de régression logistique. Pour cela, nous ajoutons la fonction set_engine() et spécifions une méthode. Toutes les options de logistic_reg() figurent dans la documentation ici.
Nous n'avons pas encore enregistré notre spécification. Ci-dessous, nous spécifions une régression logistique à l'aide de GLM, destinée à la classification. Ce dernier point est spécifié avec la fonction set_mode(). Cette fonction est particulièrement importante si le modèle peut servir à la fois à la classification (prédire des critères de jugement catégoriels) et à la régression (prédire des critères de jugement continus). Nous enregistrons la spécification dans l'objet log_mod.
log_mod <-
  logistic_reg() |>
  set_engine("glm") |>
  set_mode("classification")

log_mod
Logistic Regression Model Specification (classification)
Computational engine: glmSpécifier une formule
Nous poursuivons en spécifiant la formule proprement dite avec la fonction fit() et l'ajoutons à l'objet log_mod. Notez que la formule diabetes ~ . signifie que nous créons un modèle dans lequel diabetes est le critère de jugement et toutes les autres variables sont des prédicteurs, ce qui est spécifié par le point (.) :
log_fit <-
  log_mod |>
  fit(diabetes ~ ., data=pima_train)

## Afficher le résultat
log_fit
parsnip model object
Call: stats::glm(formula = diabetes ~ ., family = stats::binomial,
data = data)
Coefficients:
(Intercept) pregnant glucose pressure triceps insulin mass pedigree age
8.591e+00 -1.499e-01 -3.117e-02 1.470e-02 5.995e-06 1.321e-03 -1.056e-01 -7.798e-01 -2.357e-02
Degrees of Freedom: 536 Total (i.e. Null); 528 Residual
Null Deviance: 694.2
Residual Deviance: 500.4 AIC: 518.4Extraire les résultats
Le résultat est plus lisible avec la fonction tidy() du package broom. Nous indiquons que les arguments exponentiate et conf.int valent TRUE afin d'obtenir les coefficients exponentiés ainsi que les intervalles de confiance :
tidy(log_fit, exponentiate=T, conf.int=T) term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 5382. 0.873 9.84 7.85e-23 1040. 32053.
2 pregnant 0.861 0.0386 -3.88 1.05e- 4 0.797 0.928
3 glucose 0.969 0.00431 -7.24 4.61e-13 0.961 0.977
4 pressure 1.01 0.00648 2.27 2.32e- 2 1.00 1.03
5 triceps 1.00 0.00843 0.000711 9.99e- 1 0.984 1.02
6 insulin 1.00 0.00102 1.29 1.97e- 1 0.999 1.00
7 mass 0.900 0.0192 -5.51 3.52e- 8 0.866 0.933
8 pedigree 0.458 0.365 -2.14 3.27e- 2 0.222 0.930
9 age 0.977 0.0109 -2.16 3.04e- 2 0.956 0.998La colonne estimate correspond à l'odds ratio (rapport des cotes). Les colonnes conf.low et conf.high sont respectivement les bornes inférieure et supérieure de l'intervalle de confiance à 95 %.
Prédire
À l'étape suivante, le modèle est utilisé pour prédire sur les données de test (pima_test). Cela se fait avec la fonction predict(). Le résultat est enregistré dans une nouvelle colonne de pima_test. Cette nouvelle colonne s'appelle predicted :
pima_test$predicted <- predict(log_fit,
                               new_data = pima_test,
                               type="prob")
Si nous examinons pima_test, nous constatons que la nouvelle colonne se compose en réalité de deux colonnes, à savoir .pred_Yes et .pred_No. Il s'agit donc d'une colonne « imbriquée » (nested), puisqu'elle est constituée de plusieurs colonnes.
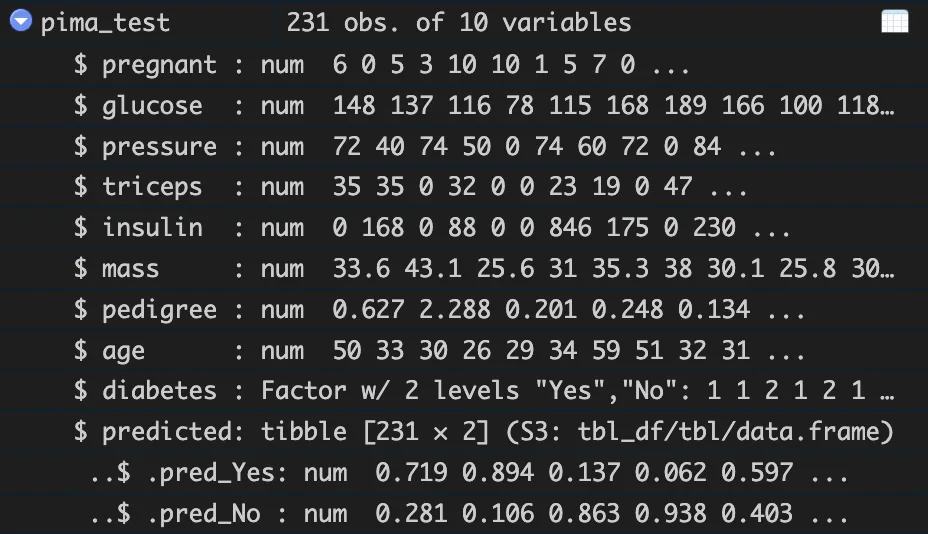
Les colonnes imbriquées constituent certes un mode de stockage efficace, mais elles sont ici peu pratiques. Nous extrayons donc ces colonnes en colonnes distinctes à l'aide de la fonction unnest(), de la manière suivante :
pima_test <- unnest(pima_test, predicted)

## Inspecter les données
head(pima_test)
pregnant glucose pressure triceps insulin mass pedigree age diabetes .pred_Yes .pred_No
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <fct> <dbl> <dbl>
1 6 148 72 35 0 33.6 0.627 50 Yes 0.719 0.281
2 0 137 40 35 168 43.1 2.29 33 Yes 0.894 0.106
3 5 116 74 0 0 25.6 0.201 30 No 0.137 0.863
4 3 78 50 32 88 31 0.248 26 Yes 0.0620 0.938
5 10 115 0 0 0 35.3 0.134 29 No 0.597 0.403
6 10 168 74 0 0 38 0.537 34 Yes 0.885 0.115
7 1 189 60 23 846 30.1 0.398 59 Yes 0.760 0.240
8 5 166 72 19 175 25.8 0.587 51 Yes 0.658 0.342
9 7 100 0 0 0 30 0.484 32 Yes 0.361 0.639
10 0 118 84 47 230 45.8 0.551 31 Yes 0.384 0.616Les colonnes .pred_Yes et .pred_No sont les probabilités prédites des issues Yes et No respectivement, selon le modèle de régression logistique. La somme des probabilités de Yes et de No est toujours égale à 1,0.
Évaluer le modèle
Si nous ne considérons que la probabilité de Yes (.pred_Yes), nous pouvons par exemple choisir de prédire que l'individu est diabétique si la probabilité est >0,5 (supérieure à 0,5). Le seuil de 0,5 est souvent utilisé par défaut dans de nombreux packages et fonctions, car des valeurs >0,5 signifient que la survenue de l'événement (ici, le diabète) est plus probable que son absence. Ce seuil est souvent appelé decision threshold (seuil de décision). On peut bien entendu abaisser le seuil de décision à 0,4, 0,35, 0,2, voire plus bas. Plus le seuil est bas, plus le nombre d'individus diabétiques détectés est élevé, mais plus le nombre d'individus recevant un diagnostic faussement positif augmente. Il existe des fonctions simples pour évaluer la sensibilité et la spécificité pour un grand nombre de seuils de décision. Avec la fonction roc_curve(), nous calculons la sensibilité et la spécificité pour plus de 200 seuils de décision :
pima_test %>%
  roc_curve(diabetes, .pred_Yes)
.threshold specificity sensitivity
<dbl> <dbl> <dbl>
1 -Inf 0 1
2 0.00171 0 1
3 0.0133 0.00667 1
4 0.0176 0.0133 1
5 0.0190 0.0200 1
6 0.0210 0.0267 1
7 0.0260 0.0333 1
8 0.0279 0.0400 1
9 0.0282 0.0467 1
10 0.0297 0.0533 1
....Nous pouvons calculer automatiquement l'aire sous la courbe ROC avec le code suivant :
pima_test %>%
  roc_auc(diabetes, .pred_Yes)
.metric .estimator .estimate
roc_auc binary 0.840L'AUC ROC est de 0,840.
La courbe ROC s'obtient avec le code suivant :
pima_test %>%
  roc_curve(diabetes, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()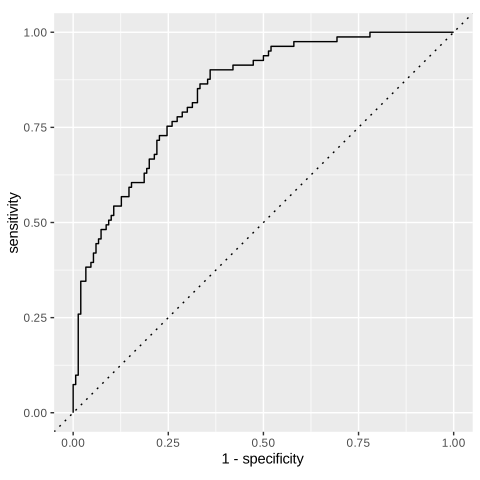
Par curiosité, nous pouvons refaire le modèle, cette fois avec l'extreme gradient boosting (XGBoost), qui est un modèle très performant. XGBoost est disponible via la fonction boost_tree(). Il comporte des hyperparamètres (par exemple tree_depth) qui devraient en principe être optimisés, mais cela n'est pas fait dans cet exemple. Par souci de simplicité, chaque hyperparamètre reçoit une seule valeur par défaut. À la ligne 13, nous créons un nouveau data frame appelé resultat, qui ne contient que la colonne diabetes de pima_test. À la ligne 16, nous utilisons notre modèle XGBoost pour prédire la probabilité de diabète, et le résultat est envoyé dans la colonne predicted2 de resultat. À la ligne 21, nous désimbriquons (unnest) la colonne predicted2. L'AUC ROC et la courbe ROC sont ensuite calculées.
## Spécifier le modèle et la méthode
xgb_mod <-
  boost_tree(tree_depth = 4,
             trees = 600,
             learn_rate = 0.005,
             min_n = 5,
             sample_size = 0.5) |>
  set_engine('xgboost') |>
  set_mode('classification') |>
  fit(diabetes ~ ., data=pima_train)

## Créer un data frame avec les diagnostics réels
resultat <- data.frame(diabetes = pima_test$diabetes)

## Prédire le diagnostic
resultat$predicted2 <- predict(xgb_mod,
                               new_data = pima_test,
                               type="prob")

## Désimbriquer la colonne predicted2
resultat <- unnest(resultat, predicted2)

## ROC AUC
resultat %>%
    roc_auc(diabetes, .pred_Yes)

## Courbe ROC
resultat |>
  roc_curve(diabetes, .pred_Yes) |>
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal()
.metric .estimator .estimate
roc_auc binary 0.844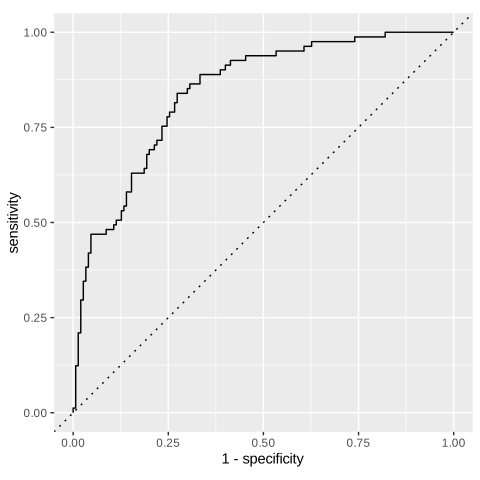
L'AUC ROC de XGBoost sans optimisation des hyperparamètres était de 0,844, contre 0,840 pour la régression logistique.
Importance des variables
Les méthodes d'apprentissage automatique de ce type disposent de méthodes intégrées pour comparer l'importance relative des prédicteurs. C'est ce qu'on appelle la relative variable importance (importance relative des variables). Le package vip (variable importance) permet d'extraire cette information des objets Tidymodels, de la manière suivante :
library(vip)
xgb_mod %>% vip(geom = "point")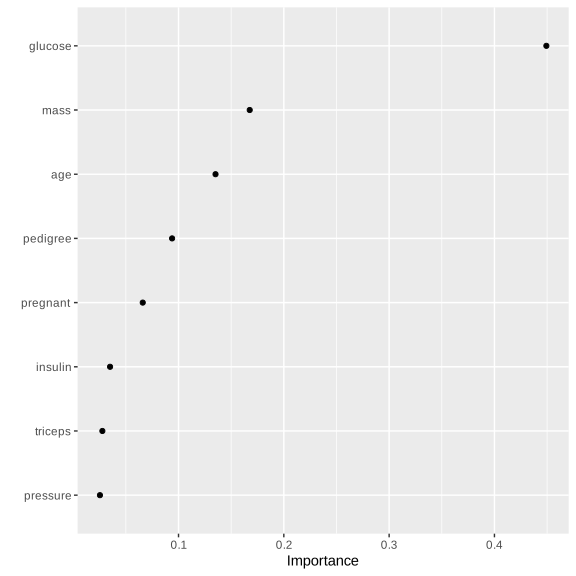
Questions et réponses
Où trouver la liste des modèles et méthodes disponibles ? Cliquez ici pour accéder à la documentation de parsnip.