
Fonction de survie (survival function) et fonction de risque (hazard function)
Le chapitre précédent (Analyse de survie) est un prérequis pour comprendre ce chapitre.
Le temps de survie (survival time) est une variable continue qui peut être décrite par deux fonctions simples :
- : la fonction de survie (survival function) est la probabilité qu'une personne soit en vie après le temps t.
- : la fonction de risque (hazard function) décrit le risque instantané que l'événement (event) survienne au temps t, à condition que la personne ait survécu jusqu'au temps t.
Toutes les variables continues (y compris le survival time) peuvent être décrites par une fonction de répartition (cumulative distribution function, CDF). Ces fonctions sont des distributions de probabilité définies comme suit :
Cette fonction décrit la probabilité que soit inférieur ou égal à . Le temps de survie, , possède lui aussi une fonction de répartition :
Cette fonction décrit la probabilité que l'événement survienne au temps ou avant, mais pas après . Notre objectif est toutefois d'estimer , c'est-à-dire la probabilité que l'individu ait survécu au-delà du temps (autrement dit, qu'il n'ait pas présenté l'événement au temps ). est donc la probabilité de survivre au-delà du temps :
a une forme en escalier, comme le montre le graphique ci-dessous (courbe de Kaplan-Meier). Le graphique décrit comment la probabilité de survie diminue au fil du temps. Les signes plus (+) sur le graphique indiquent les moments où des personnes ont été censurées. n'est pas affectée par les censures. ne diminue que lorsqu'un ou plusieurs individus présentent l'événement.
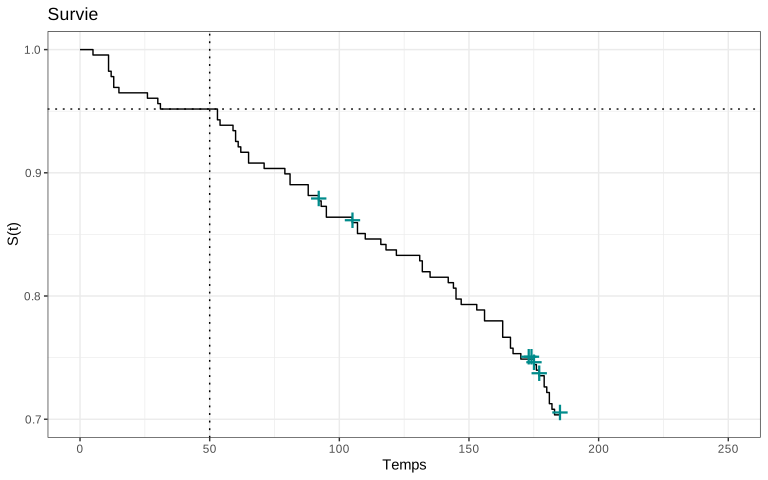
Dans le graphique ci-dessus, la valeur de est de 0,952 à , ce qui signifie que la probabilité de survivre au moins 50 jours est de 95,2 %, et que 4,8 % ont présenté l'événement à . La survie médiane est le moment où 50 % de la population a présenté l'événement, c'est-à-dire .
Estimateur de Kaplan-Meier (estimateur produit-limite)
Il est toujours important de visualiser la survie à l'aide d'un graphique, car celui-ci montre comment le processus de survie évolue dans le temps. La méthode la plus courante pour présenter repose sur l'estimateur de Kaplan-Meier (courbe de Kaplan-Meier, Product Limit Estimator), illustré dans la figure ci-dessus.
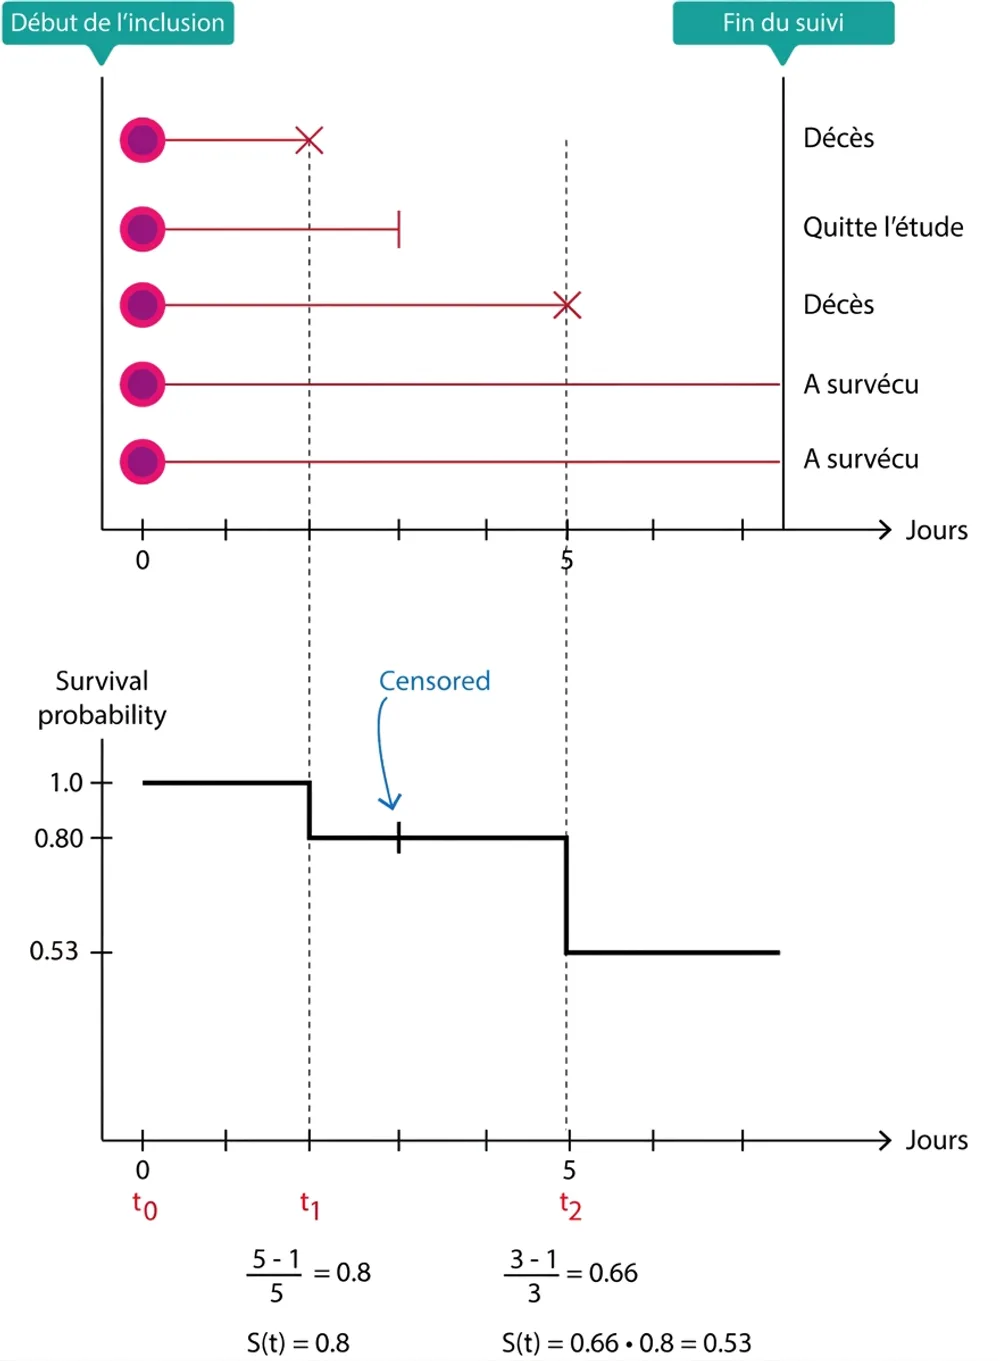
Pour construire une courbe de Kaplan-Meier, le survival time (la durée de suivi) doit être découpé en intervalles. Chaque intervalle commence lorsqu'un événement survient. Tous les temps auxquels surviennent des événements (event times) sont ordonnés, du premier au dernier événement. Au temps survient le premier événement, au temps le deuxième, au temps le troisième, et ainsi de suite. L'étude commence à , et aucun événement n'est encore survenu à ce moment. À , , ce qui signifie que la probabilité de survie est de 100 %.
Pour calculer à , on effectue le calcul suivant :
= nombre de patients observés au début de
= nombre d'événements à
Il s'agit de la proportion de patients qui survivent après , parmi les patients qui ont survécu jusqu'à . Pour calculer la probabilité de survivre après , à condition d'avoir survécu jusque-là, le calcul se fait en deux étapes :
est le produit des probabilités de survivre jusqu'à , soit :
Ceci est illustré dans la figure ci-dessous.
| Temps (x) | Nombre à risque | Nombre d'événements | Nombre de censurés | Survie (y) |
|---|---|---|---|---|
| 0 | 228 | 0 | 0 | 1.00000000 |
| 5 | 228 | 1 | 0 | 0.99561404 |
| 11 | 227 | 3 | 0 | 0.98245614 |
| 12 | 224 | 1 | 0 | 0.97807018 |
| 13 | 223 | 2 | 0 | 0.96929825 |
| 15 | 221 | 1 | 0 | 0.96491228 |
| 26 | 220 | 1 | 0 | 0.96052632 |
| 30 | 219 | 1 | 0 | 0.95614035 |
| 31 | 218 | 1 | 0 | 0.95175439 |
| 53 | 217 | 2 | 0 | 0.94298246 |
| 54 | 215 | 1 | 0 | 0.93859649 |
| 59 | 214 | 1 | 0 | 0.93421053 |
| 60 | 213 | 2 | 0 | 0.92543860 |
| 61 | 211 | 1 | 0 | 0.92105263 |
| 62 | 210 | 1 | 0 | 0.91666667 |
| 65 | 209 | 2 | 0 | 0.90789474 |
| 71 | 207 | 1 | 0 | 0.90350877 |
La probabilité de survie (survival probability) correspond à sur la courbe de Kaplan-Meier. Il s'agit donc de la proportion de personnes encore en vie à chaque instant. La courbe descend progressivement à mesure que des personnes présentent l'événement. La courbe de Kaplan-Meier n'atteint que si tous les participants présentent l'événement. La survie médiane correspond tout simplement à la proportion de vivants à .
Tests d'hypothèse et analyse de survie : le test du log-rank
Tester la différence entre des courbes de survie
La figure suivante compare la survie entre les hommes et les femmes.
21.7.1 Code R pour la courbe de Kaplan-Meier ci-dessus
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)

## Charger les données d'exemple
data(colon)

## Inspecter les 10 premières lignes
head(colon, 10)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1La fonction de survie est générée à l'aide des fonctions survfit() et Surv(). Dans Surv(), le premier argument est le temps de survie (time) et le second est la variable d'événement. Pour la variable d'événement, nous pouvons préciser quel niveau indique que l'événement est survenu. C'est ce que nous faisons ci-dessous en indiquant status==1. Avec l'argument pval = TRUE, nous demandons un test d'hypothèse par le test du log-rank. Ce test calcule la probabilité que l'hypothèse nulle ( soit vraie (l'hypothèse nulle postule qu'il n'existe aucune différence de survie. Si la valeur p obtenue par le test du log-rank est < 0,05, est rejetée. Ici, les hommes sont comparés aux femmes en incluant la variable sex comme strate :
## Créer l'objet survfit. C'est dans cet objet que la fonction de survie est construite
fit <- survfit(Surv(time, status==1) ~ sex, data = lung)

## Tracer la courbe de Kaplan-Meier
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)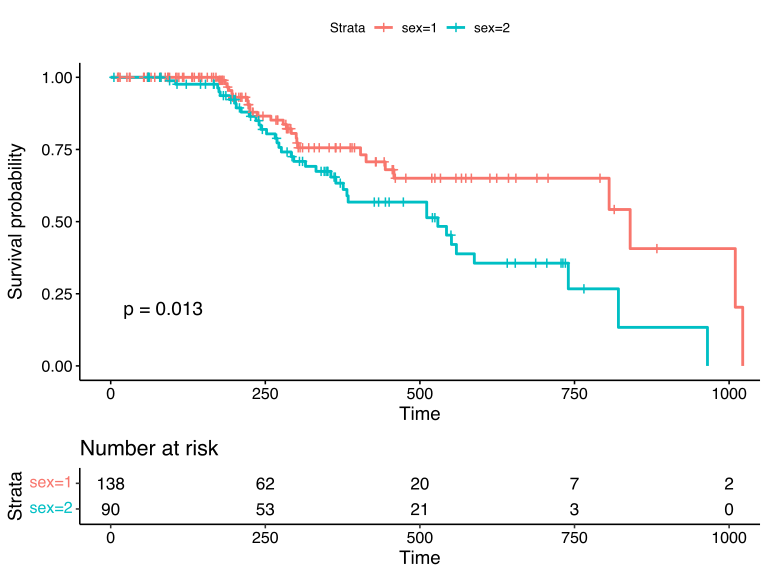
Comme on le voit ci-dessus, les courbes sont séparées, ce qui signifie que la survie diffère entre les hommes (sex=2) et les femmes (sex=1). À chaque instant, est plus élevée chez les femmes. La survie est donc meilleure chez les femmes, ce qui peut être apprécié visuellement. La valeur p est de 0,013, ce qui indique également que la différence est statistiquement significative. La valeur p est calculée par le test du log-rank.
Le test du log-rank suit le principe général des tests d'hypothèse. On part de l'hypothèse nulle (), qui postule qu'il n'existe aucune différence entre les groupes, puis on calcule une probabilité (valeur p) que l'hypothèse nulle soit vraie. Si cette probabilité est < 0,05, l'hypothèse nulle est rejetée. Le test du log-rank peut être utilisé pour comparer deux courbes de survie ou plus.
La courbe de Kaplan-Meier peut ainsi être utilisée pour étudier la survie, dans l'ensemble de la population ou dans des sous-groupes (par exemple les hommes et les femmes). Il n'est toutefois pas possible d'ajuster sur des covariables dans un calcul de Kaplan-Meier ; cela nécessite une analyse de régression, dont la méthode la plus courante est la régression de Cox, présentée dans le chapitre suivant.