
Analyse de survie (survival analysis) : de Kaplan-Meier à la régression de Cox
Une version révisée de ce chapitre est disponible ici :
L'analyse de survie est un outil puissant pour étudier des événements (events). L'information sur la durée d'observation y occupe une place centrale. On étudie en effet toujours le délai jusqu'à la survenue d'un événement. Dans la littérature anglophone, on emploie les termes survival analysis ou time-to-event analysis. Ce dernier terme, time-to-event analysis, est en réalité plus exact, car ces analyses permettent d'étudier tout type d'événement et pas seulement le décès. Dans ce chapitre, nous prendrons toutefois le décès comme exemple, car cela facilite la compréhension.
La connaissance de la durée d'observation, c'est-à-dire la période pendant laquelle l'individu est observé, est essentielle en analyse de survie. Il ne s'agit bien sûr pas nécessairement d'une personne : il peut tout aussi bien s'agir de cellules, de bactéries ou d'autres unités. Dans sa forme la plus simple, la durée d'observation commence lorsque l'individu est inclus dans l'étude et se termine lorsque l'événement survient ou lorsque la période de suivi de l'étude prend fin. La période pendant laquelle l'individu est observé est appelée survival time.
Les objectifs de l'analyse de survie sont les suivants :
- Étudier le processus de survie.
- Étudier comment différents prédicteurs influencent la survie.
Pour étudier le processus de survie, on peut recourir à des méthodes descriptives, dont la plus importante est l'estimateur de Kaplan-Meier (la courbe de Kaplan-Meier). La méthode de Kaplan-Meier fournit une description graphique (et mathématique) de la survie. Elle permet aussi de comparer la survie entre deux groupes ou plus. L'estimateur de Kaplan-Meier ne permet cependant pas d'analyser en profondeur l'effet de différents prédicteurs sur la survie.
Pour étudier comment différents prédicteurs influencent la survie, une analyse de régression est nécessaire. Aujourd'hui, l'analyse de survie est dominée par la régression de Cox (Cox Proportional Hazards Model), qui permet de comparer la survie entre deux groupes ou plus et d'étudier comment différents prédicteurs influencent la survie. La régression de Cox est un outil extrêmement puissant, et des milliers d'articles dont elle constitue la pierre angulaire sont publiés chaque jour.
L'estimateur de Kaplan-Meier et la régression de Cox sont les outils les plus importants à maîtriser ; c'est pourquoi la suite de l'exposé porte sur ces deux méthodes.
Analyse de survie ou régression logistique
L'analyse de survie étudie donc des événements dichotomiques (binaires). On étudie si un événement survient ou non. À cet égard, l'analyse de survie présente des similitudes avec la régression logistique (voir Régression logistique). La régression logistique est d'ailleurs elle aussi utilisée pour étudier des événements dichotomiques. Chaque jour paraissent des centaines d'articles dans lesquels la régression logistique a servi à étudier l'association entre divers prédicteurs et le décès ou d'autres événements. La régression logistique est cependant (en principe) toujours un moins bon choix que l'analyse de survie pour étudier la survie, car elle ne peut pas tenir compte de la durée d'observation. La durée d'observation est la clé de l'analyse de survie (c'est en fait la distribution du survival time qui est étudiée en analyse de survie) et elle ne peut pas être intégrée dans une régression logistique. Illustrons cela par un exemple (extrême) :
Vous étudiez l'effet d'un médicament administré à 50 des 100 patients atteints d'un cancer du poumon en 2013. Ces patients ont été revus en 2014, et tous étaient alors décédés. Il y a donc autant de décès parmi ceux qui ont reçu le médicament que parmi ceux qui ne l'ont pas reçu. Vous réalisez une régression logistique dans laquelle la survie est examinée (comme critère de jugement dichotomique) en 2014. Comme tous les patients sont décédés, la régression logistique indiquera que le médicament est inefficace, puisque le nombre de décès en 2014 était identique dans les deux groupes. Supposons que la survie médiane dans le groupe n'ayant pas reçu le médicament était de 1 mois et que le groupe ayant reçu le médicament avait une survie médiane de 6 mois. Certes, tous étaient décédés au bout de 12 mois, mais il semble néanmoins que le médicament ait prolongé la vie. Une analyse de survie correcte nous permettrait de confirmer que le médicament est efficace, et ce parce que l'analyse de survie peut intégrer la durée de survie elle-même (survival time) !
Avec l'analyse de survie (et en particulier la régression de Cox), on a donc plus de chances de mettre en évidence des différences de survie. Il faut toujours préférer l'analyse de survie (en particulier la régression de Cox) à la régression logistique lorsque l'on dispose du survival time. (Signalons toutefois que, dans certaines circonstances particulières, la régression logistique peut être équivalente à la régression de Cox, mais ce point n'est pas abordé dans ce chapitre.)
Événement (event, outcome, critère de jugement) en analyse de survie
Le critère de jugement d'une analyse de survie est un événement (en anglais : event). L'événement peut être le décès, la survenue d'un accident vasculaire cérébral, un diagnostic de cancer ou des événements plus « mous » comme l'instauration d'un traitement médicamenteux ou la sortie de l'hôpital. On peut donc étudier tout type d'événement par l'analyse de survie, y compris la durée de vie d'un ordinateur. La nature de l'événement est donc secondaire, mais il incombe à l'investigateur de définir un événement clair et pertinent. Toutes les personnes de la population doivent être suivies depuis le moment de leur inclusion dans l'étude jusqu'à la fin du suivi. Il est important de pouvoir dater (avec la plus grande précision possible) le moment de l'événement, afin que la durée d'observation puisse être calculée avec une résolution élevée. Il est donc bien préférable d'enregistrer le survival time en nombre de jours plutôt qu'en nombre de mois. Plus la mesure du survival time est grossière, moins l'analyse est précise.
Prédicteurs, covariables et variables indépendantes
Lorsque l'analyse de survie sert à étudier comment différentes variables influencent le critère de jugement, on utilise généralement la régression de Cox (Cox proportional hazards model). Les variables étudiées sont appelées prédicteurs, covariables ou variables indépendantes. Ces trois dénominations sont toutes utilisables et désignent la même chose.
Censoring (censure)
La durée de survie (survival time) est une variable continue, et il peut donc être tentant d'utiliser la régression linéaire pour étudier la survie. Cela n'est cependant pas possible en raison de la *censure (*angl. : censoring). En règle générale, toutes les personnes ne connaîtront pas l'événement étudié ; il est par exemple rare que toutes les personnes de l'étude décèdent. Les personnes qui survivent pendant toute la durée d'observation posent donc un problème, puisque nous ne pouvons pas dire si ni quand elles décéderont. Ces personnes sont censurées (angl. : censored) à la fin du suivi de l'étude. Le même problème se pose si des participants quittent l'étude (par ex. en raison d'effets indésirables d'un médicament, ou parce qu'ils partent vivre à l'étranger, etc.). Ces personnes sont elles aussi censurées (puisque nous ne pouvons pas dire si ni quand elles décéderont). La censure signifie donc que le suivi prend fin avant la survenue de l'événement. On distingue trois types de censure :
- Si une personne termine l'étude sans que l'événement survienne, elle est right censored (censurée à droite). Cela signifie que nous ne pouvons nous prononcer sur le devenir du patient que jusqu'au moment où le suivi prend fin. Les personnes qui quittent l'étude (quelle qu'en soit la raison) sont elles aussi right censored.
- Nous nous intéressons souvent à une exposition donnée ; une étude peut par exemple examiner comment le diabète influence la survie. Or on ignore souvent quand la maladie diabétique est apparue. La maladie peut avoir existé de nombreuses années avant que le diagnostic ne soit posé. Si l'on ignore quand une exposition a commencé, l'individu est left censored (censuré à gauche) à cet égard. La censure à gauche signifie donc que l'on ne sait pas quand le risque de l'individu a commencé. Cela ne pose généralement pas de problème majeur.
- Si un individu est à la fois left et right censored, il est interval censored (censuré par intervalle).
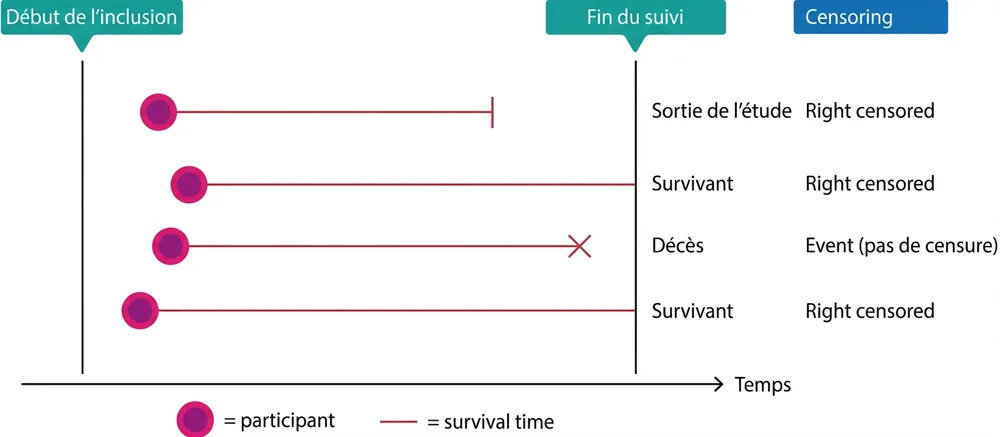
Censure informative ou non informative
La censure doit être indépendante (1) des covariables (prédicteurs) de l'individu et (2) de la durée pendant laquelle l'individu est resté sans événement dans l'étude. La censure en cours d'étude (avant la fin du suivi) doit être aléatoire, faute de quoi l'étude est biaisée. Voici un exemple. Supposons que nous étudions l'effet d'un antihypertenseur sur la mortalité. Le médicament étudié s'avère provoquer des effets indésirables sévères, de sorte que de nombreuses personnes qui le reçoivent sont contraintes de quitter l'étude. Dans ce cas, la censure est déterminée par une covariable (prédicteur), à savoir le médicament, et il en résulte un biais, car les patients quittent l'étude avant d'avoir eu le temps de décéder. Cela conduit à une sous-estimation du nombre de décès et donc à une surestimation de la survie. Ce type de censure est appelé censure informative, ce qui signifie que la censure n'était pas aléatoire.
La censure doit donc être non informative, c'est-à-dire qu'il ne doit exister aucune raison à la censure. Dans l'exemple de l'antihypertenseur, la distribution du survival time sera identique entre les groupes si la censure est non informative.
Survival function et hazard function
La survie (survival time) est une variable continue qui peut être décrite par deux fonctions simples :
S(t) : survival function (fonction de survie). S(t) est la probabilité qu'une personne soit encore en vie après le temps t.
h(t) : hazard function (fonction de risque instantané). h(t) indique le risque instantané que l'événement survienne au temps t, à condition que la personne ait survécu jusque-là.
La formule et la relation entre S(t) et h(t) sont les suivantes :
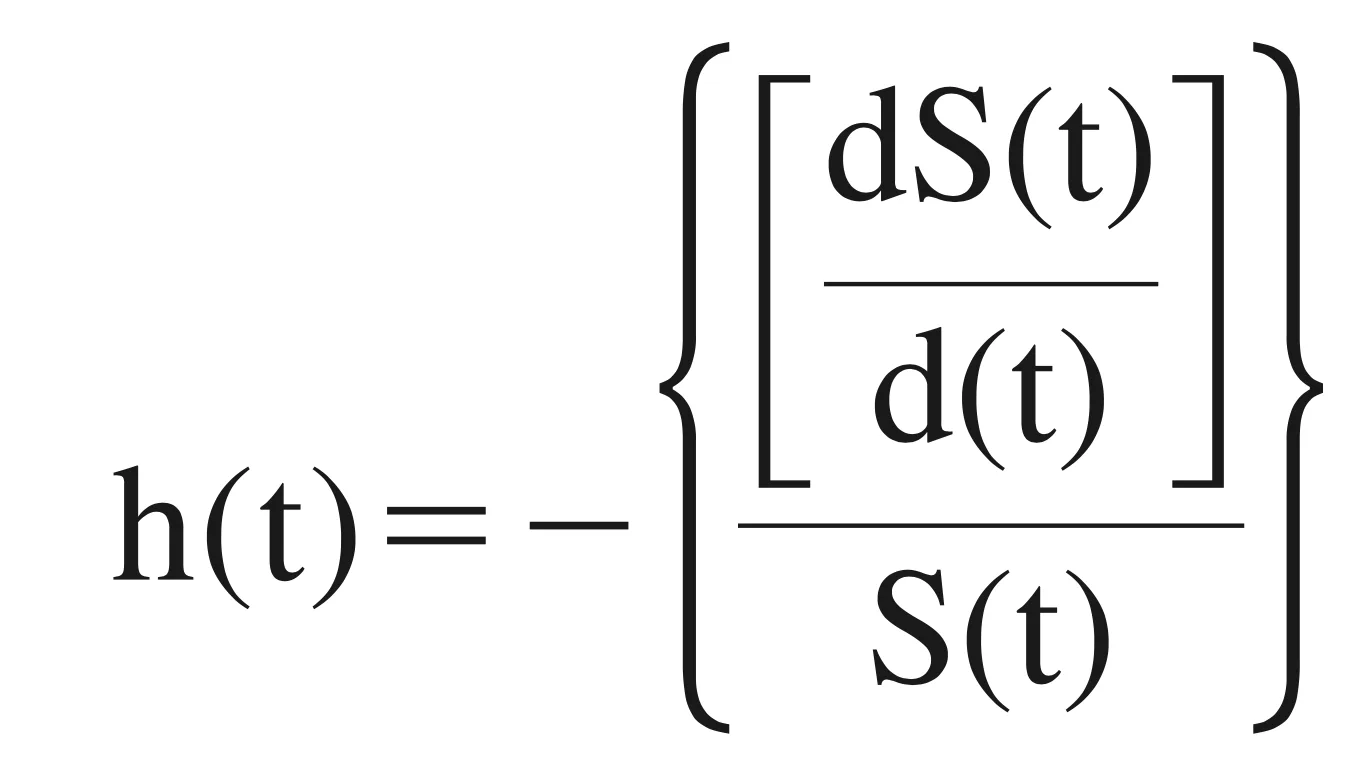
S(t) sert à produire des statistiques descriptives. En calculant S(t), on peut notamment établir des courbes de survie et déterminer la survie médiane. La survie médiane est le moment où 50 % de la cohorte initiale est en vie, ce qui signifie que S(t) = 0,5. Notez que les courbes de survie comme la survie médiane sont rapportées dans la plupart des études ayant recours à l'analyse de survie. La fonction de risque instantané, en revanche, n'est généralement pas présentée dans une étude scientifique. Elle n'en revêt pas moins une importance fondamentale pour l'analyse de survie, comme nous le verrons plus loin.
S(t) et l'estimateur (la courbe) de Kaplan-Meier
Il est en règle générale toujours utile de visualiser la survie sous forme de graphique, car celui-ci montre comment le processus de survie évolue au cours du temps. Un graphique permet de discerner facilement si les participants décèdent surtout au début, au milieu ou à la fin d'une étude. La méthode la plus courante pour présenter S(t) est l'estimateur de Kaplan-Meier.
Pour construire une courbe de Kaplan-Meier, l'échelle de temps (la durée de suivi) doit être découpée en intervalles (Figure 2). Chaque intervalle commence lorsqu'un événement survient. Tous les moments où surviennent des événements (event times) sont classés, du premier au dernier événement. En t1 survient le premier événement, en t2 le deuxième, en t3 le troisième, et ainsi de suite. L'étude commence en t0, moment où aucun événement n'est encore survenu. En t0, S(t) = 1,0, ce qui signifie que la probabilité de survie est de 100 %. Pour calculer S(t) en t1, on effectue le calcul suivant :
(n1 – m1) / n1
n1 est le nombre de patients observés au début de t1.
m1 est le nombre d'événements en t1.
Il s'agit donc de la proportion de patients qui survivent après t1, parmi les patients qui ont survécu jusqu'à t1.
Pour calculer la probabilité de survivre après t2, à condition d'avoir survécu jusque-là, le calcul se fait en deux étapes :
(n2 – m2) / n2
n2 est le nombre de patients observés au début de t2.
m2 est le nombre d'événements en t2.
Il s'agit donc de la proportion de patients qui survivent après t2, parmi ceux qui ont survécu jusqu'à t2. S(t) est le produit des probabilités de survivre jusqu'à t2, soit :
(n1 –m1)/n1 × (n2 – m2)/n2
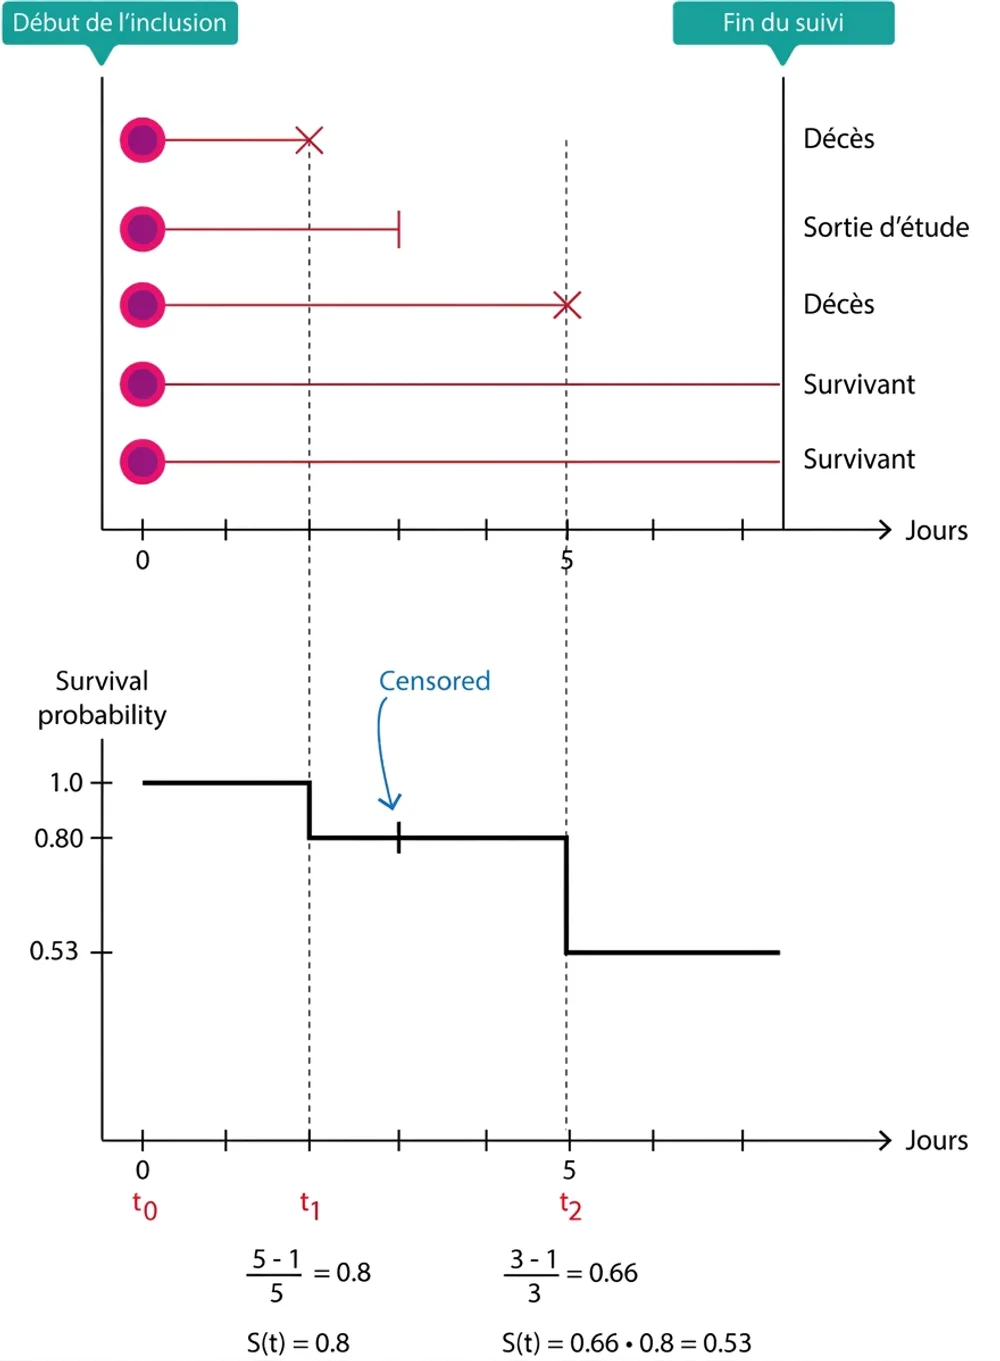
La courbe de survie (courbe de Kaplan-Meier) présente la survival probability sur l'axe des Y et le temps sur l'axe des X. La survival probability est S(t), c'est-à-dire la proportion de personnes encore en vie à chaque instant. La courbe commence toujours à Y = 1, puisque tous survivent jusqu'à t1 (moment où survient le premier événement). Ensuite, la courbe descend progressivement à mesure que des personnes décèdent. D'éventuels « + » sur la courbe indiquent les moments où des personnes sont censurées (c'est-à-dire où le suivi prend fin avant la survenue d'un événement). Comme vous pouvez le constater sur la figure ci-dessus, S(t) n'est pas affectée par la censure. La courbe de Kaplan-Meier n'atteint S(t) = 0 que si tous les participants à l'étude décèdent. La survie médiane est tout simplement la proportion de personnes en vie à S(t) = 0,5.
Tester la différence entre courbes de survie : le test du log-rank
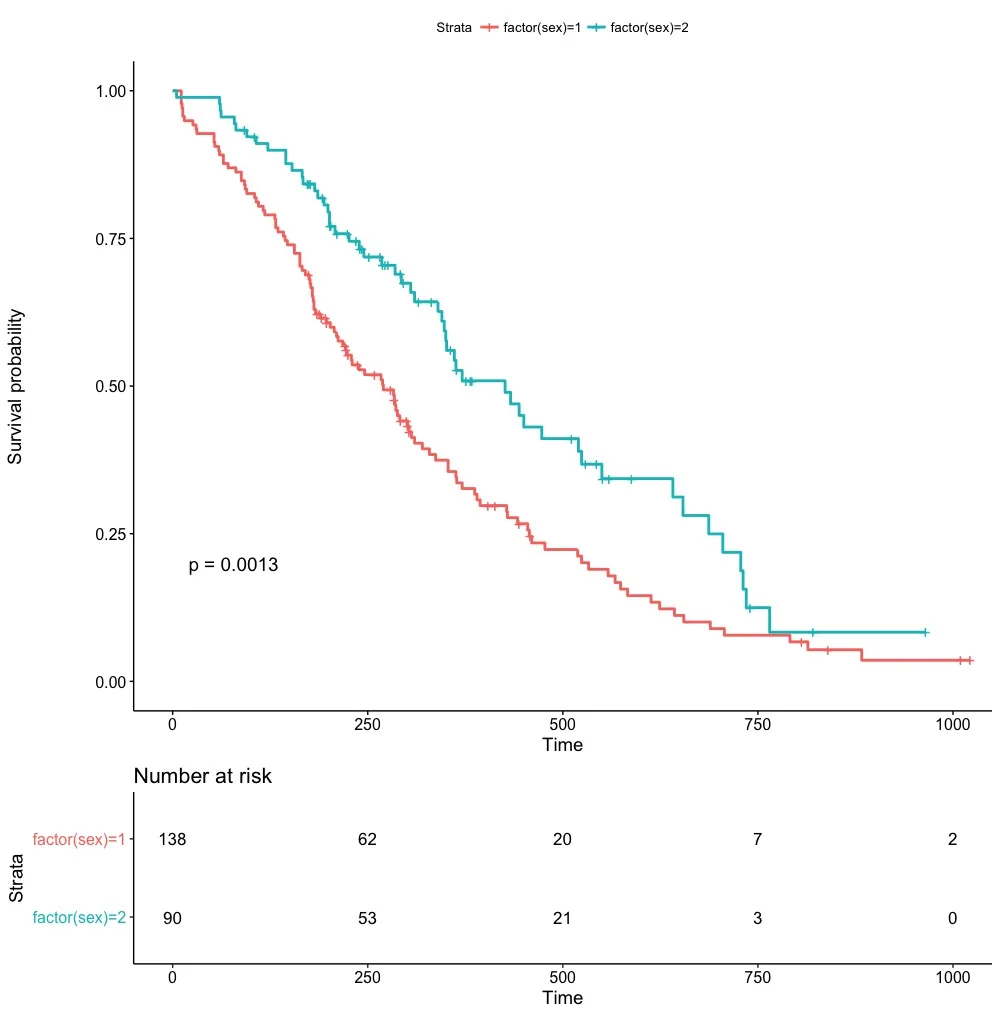
La figure suivante compare la survie entre hommes et femmes.
Code R pour la courbe de Kaplan-Meier ci-dessus
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)
## Charger les données d'exemple et examiner la structure des données
data(lung)
str(lung)
## garantit que sex est une variable catégorielle en la convertissant à l'aide de la fonction "as.factor"
lung$sex <- as.factor(lung$sex)
## Créer l'objet survfit. C'est dans cet objet que la fonction de survie est construite
fit <- survfit(Surv(time, status==2) ~ sex, data = lung)
## Tracer la courbe de Kaplan-Meier
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)
Comme on le voit ci-dessus, les courbes sont séparées, ce qui signifie que la survie diffère entre hommes et femmes. À chaque instant, S(t) est plus élevée chez les femmes (la courbe des femmes se situe au-dessus de celle des hommes). Cela signifie que la survie est meilleure chez les femmes, et cela peut donc être apprécié visuellement. Il est toutefois souhaitable de tester si la survie diffère au moyen d'un test statistique. On utilise à cette fin le test du log-rank.
Le principe du test du log-rank suit celui des tests d'hypothèse. On part de l'hypothèse nulle selon laquelle il n'existe aucune différence entre les groupes, puis on calcule une probabilité (valeur p) que l'hypothèse nulle soit vraie. Si cette probabilité est < 0,05, l'hypothèse nulle est rejetée. Les groupes peuvent être définis à partir de n'importe quelle variable catégorielle, à deux catégories ou plus. Dans l'exemple ci-dessus, il n'y a que deux groupes, à savoir les hommes et les femmes. Le test du log-rank peut donc servir à comparer deux courbes de survie ou plus.
La courbe de Kaplan-Meier peut ainsi être utilisée pour étudier la survie, dans l'ensemble de la population ou dans des sous-groupes (par ex. hommes et femmes). On ne peut toutefois pas ajuster sur des covariables dans un calcul de Kaplan-Meier ; cela nécessite une analyse de régression.
Régression de Cox (Proportional Hazards Model)
Aujourd'hui, la régression de Cox est presque synonyme d'analyse de survie. Cela tient aux nombreux avantages de la méthode par rapport aux autres modèles de régression. Les alternatives à la régression de Cox, par exemple la régression de Weibull, fournissent dans certaines circonstances des estimations de paramètres plus exactes, mais au prix d'une plus grande complexité. La régression de Cox est un modèle simple et puissant pour étudier la survie. La différence entre la régression de Cox et l'analyse de Kaplan-Meier est que la première est précisément un modèle de régression, ce qui signifie que nous pouvons étudier comment différents prédicteurs influencent la survie. Comme la régression multiple classique, la régression de Cox peut inclure un ou plusieurs prédicteurs. La régression de Cox est en fait une variante du modèle linéaire, comme nous l'expliquons ci-dessous.
La régression de Cox étudie la relation entre les prédicteurs (covariables) et le survival time. Pour aboutir à l'équation de la régression de Cox, nous partons de la hazard function, h(t), et de la survival function, S(t).
- La hazard function, h(t), d'un événement au temps t (c'est-à-dire un instant quelconque) équivaut au event rate (la vitesse à laquelle les événements surviennent) chez les patients qui n'ont pas encore connu l'événement.
- La survival function, S(t), est la probabilité de ne pas encore (au temps t) avoir connu l'événement.
Il existe une relation mathématique entre h(t) et S(t), qui est la suivante :
La régression de Cox part de la hazard function et définit le modèle suivant :
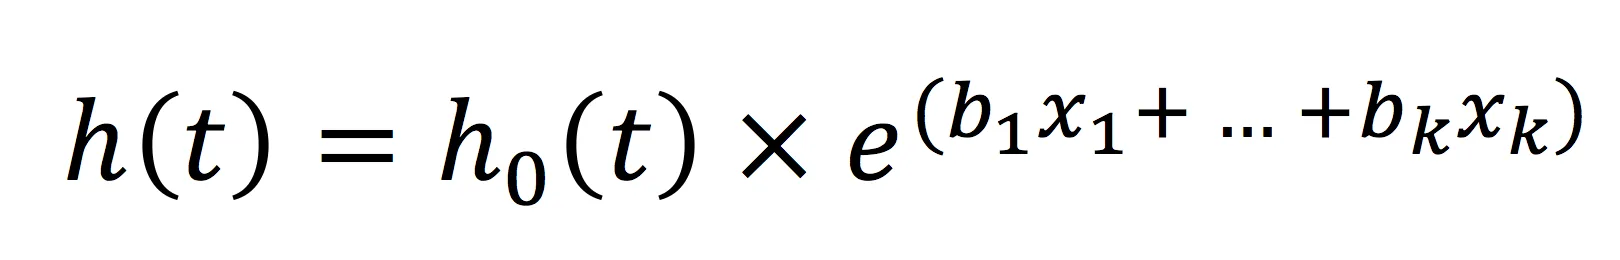
h0(t) est le baseline hazard (risque de base), et cette quantité peut être un peu délicate à saisir. Le baseline hazard est le risque de l'individu lorsque tous les prédicteurs valent 0. Voici deux exemples. (1) Imaginez que nous étudions comment l'âge influence la mortalité. Dans une régression de Cox où l'âge est le seul prédicteur, le baseline hazard serait le risque de l'être humain à l'âge de 0 an. Après la naissance, le risque augmente à mesure que l'âge avance. (2) Imaginez que nous étudions plutôt comment la pression artérielle influence la mortalité. Dans un tel modèle, le baseline hazard serait le risque de l'individu pour une pression artérielle de 0, ce qui n'a aucun sens biologique (aucune personne vivante n'a une pression artérielle de 0). Cela signifie que le baseline hazard est le risque de l'individu lorsque tous les prédicteurs sont fixés à 0, ce qui revient à un modèle sans prédicteurs. Le baseline hazard peut donc être considéré comme le risque dans la « situation de départ ».
x1, x2 ... xk sont les prédicteurs (covariables) utilisés pour modéliser la hazard function d'un individu. L'ensemble des prédicteurs ressemble ainsi à une régression multiple (linéaire) classique. Les prédicteurs peuvent être des variables continues ou catégorielles. Comme le montre la formule ci-dessus, l'ensemble des prédicteurs est placé en exposant (e).
Le modèle de Cox signifie donc que le hazard au temps t est le produit de h0(t) et de l'exponentielle (e) de l'effet cumulé des prédicteurs. À l'étape suivante, nous divisons les deux membres de l'équation par le baseline hazard et prenons en outre le logarithme des deux membres. Dans le membre de droite, h0(t) disparaît, de même que l'exponentielle. Dans le membre de gauche subsiste le logarithme naturel de h(t)/h0(t).
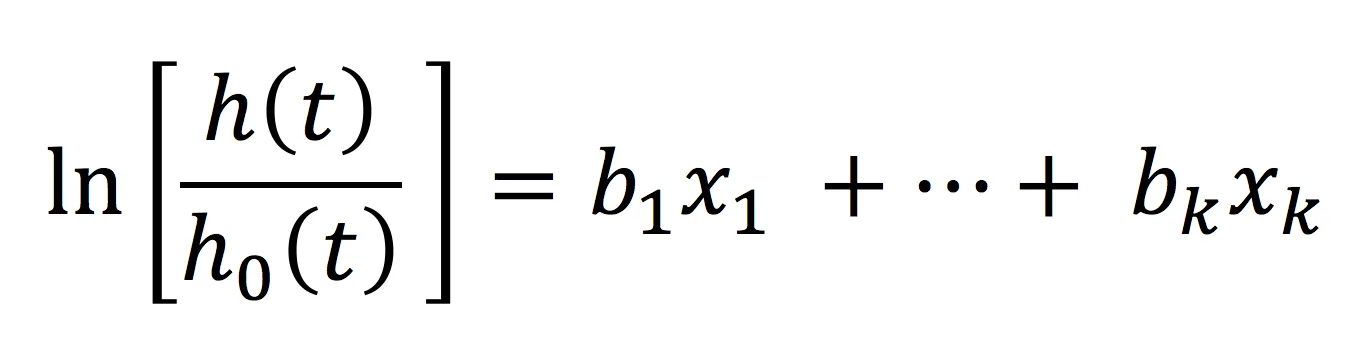
Le membre de gauche de l'équation est le hazard (risque) de l'individu et le membre de droite est une régression linéaire classique. Ce procédé est assez génial, car nous aboutissons maintenant à une équation qui nous permet d'étudier la survie comme une fonction linéaire des prédicteurs de l'individu. C'est Sir David Cox qui en a présenté les démonstrations mathématiques, et il a souligné que l'équation n'est valable que si les hazards sont proportionnels. Cox Proportional Hazards Model est synonyme de régression de Cox. Les risques proportionnels (proportional hazard) signifient que le rapport (ratio) entre les hazard functions de deux individus doit être constant au cours du temps. Cela vaut pour toutes les caractéristiques qui définissent les individus de l'étude. Voici un exemple. Si nous étudions la mortalité à Göteborg et incluons le diabète comme prédicteur dans le modèle, le rapport entre la hazard function des diabétiques et celle des non-diabétiques doit être constant pendant toute la durée du suivi. Si le risque de décès est multiplié par 3 chez les diabétiques au début du suivi, il doit rester aussi élevé (multiplié par 3) chez les diabétiques pendant toute la durée du suivi de l'étude. L'explication découle de l'équation suivante, dans laquelle on compare la hazard function de deux individus :
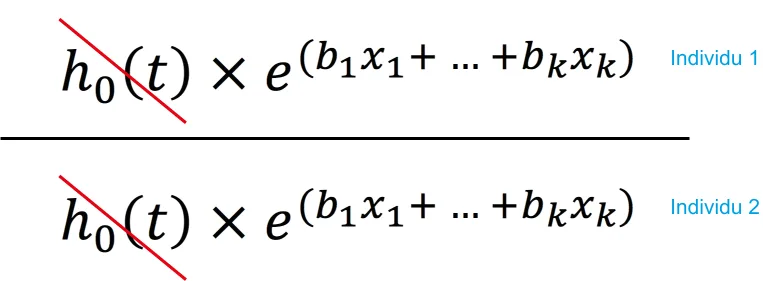
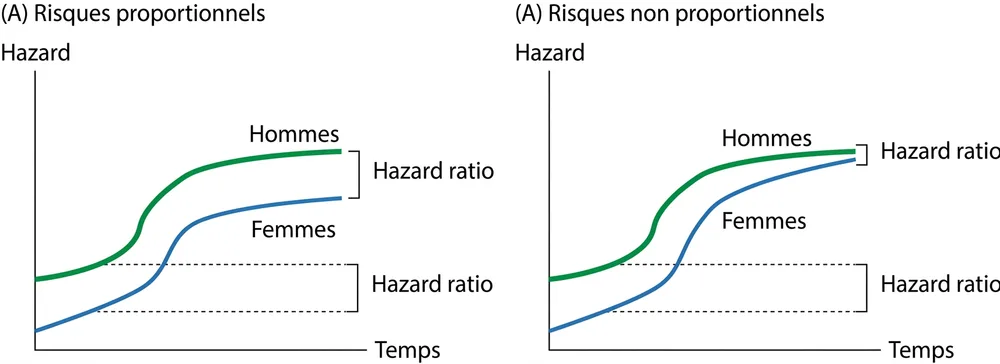
Ce rapport entre deux hazard functions est le hazard ratio (HR). Il s'agit donc de la différence relative de risque de l'individu 1 par rapport à l'individu 2. Comme h0(t) figure à la fois au numérateur et au dénominateur, il disparaît complètement. Le temps ne figure pas non plus dans l'équation. Ainsi, seules les valeurs des prédicteurs distinguent l'individu 1 de l'individu 2 ; ni le baseline hazard ni le temps ne peuvent influencer le hazard ratio, qui est donc constant entre l'individu 1 et l'individu 2. Cela signifie aussi que si l'un des prédicteurs (x1, x2 ... xk) avait un effet variable au cours du temps, l'hypothèse des proportional hazards ne serait pas satisfaite et le modèle deviendrait invalide. La Figure 4 illustre les proportional hazards et les non-proportional hazards.
Hazard ratio (rapport des risques instantanés)
Le hazard ratio se calcule en divisant le hazard d'un individu par le hazard d'un autre individu (voir la formule ci-dessus). Le hazard ratio est calculé lorsqu'un événement survient. Si un événement survient au temps t, le hazard ratio est calculé en divisant le hazard de l'individu qui a connu l'événement par le hazard des autres individus qui sont parvenus jusqu'au temps t sans connaître l'événement. Le baseline hazard disparaît (comme expliqué ci-dessus) du rapport ; de même, le moment est sans importance, puisque tous les individus sont comparés au même instant. Ce qui caractérise les individus, ce sont donc leurs prédicteurs (x1, x2 ... xk). L'effet des prédicteurs peut ainsi être analysé ! Dans une régression de Cox, on estime donc les coefficients des prédicteurs (x1, x2 ... xk), qui représentent l'effet de ces prédicteurs sur la survie. Le hazard ratio obtenu en divisant les hazards de deux individus est exprimé sur une échelle logarithmique, ce qui le rend aussi difficile à interpréter. Pour y remédier, on prend l'exponentielle du coefficient. Si le coefficient de régression vaut 0,5, le coefficient exponentié vaut e0,5 = 1,65. Lorsque nous employons le terme hazard ratio, nous faisons en réalité référence au coefficient exponentié !
Interprétation du hazard ratio
- Pour un prédicteur continu, le hazard ratio est l'augmentation ou la diminution du hazard qui accompagne une augmentation d'une unité du prédicteur X.
- Pour une variable catégorielle, le hazard ratio est la différence de hazard entre deux groupes (ou plus), l'un des groupes servant de groupe de référence.
Pour mieux comprendre, il nous faut un exemple, et nous allons le construire nous-mêmes dans R.
Code R
library(survival)
## Nous créons une régression de Cox qui étudie comment age, sex et meal.cal influencent la mortalité
modell2 <- coxph(Surv(time, status==2) ~ age + factor(sex) + meal.cal, data = lung)
## Nous installons et chargeons un package qui produit des tableaux élégants des résultats
install.packages("forestmodel")
library(forestmodel)
forest_model(modell2)
Résultats du modèle
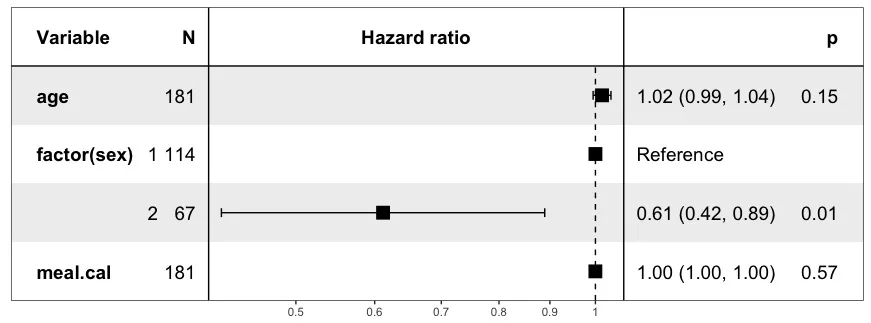
Ce modèle comporte donc trois prédicteurs : age, sex et meal.cal. Sex est un prédicteur catégoriel à deux niveaux, 1 (hommes) et 2 (femmes). Age et meal.cal sont des prédicteurs continus. Le hazard ratio est présenté à la fois sous forme graphique (au centre) et sous forme chiffrée (avant-dernière colonne). Notez que le hazard ratio est présenté avec son intervalle de confiance à 95 %. Par exemple, le hazard ratio pour sex est de 1,02, avec un intervalle de confiance à 95 % allant de 0,99 à 1,04. La dernière colonne contient la valeur p, qui indique si le prédicteur présente une association statistiquement significative avec la mortalité. Il s'agit d'une présentation typique d'une régression de Cox. La colonne « N » indique combien d'individus appartiennent à chaque catégorie (cette colonne peut être ignorée). Voici maintenant l'interprétation des résultats.
- Hazard ratio pour sex : dans le tableau, sex est présenté sur deux lignes. Cela tient au fait que sex est une variable catégorielle à deux niveaux. Nous n'obtenons aucun coefficient (hazard ratio) pour les hommes, car les hommes constituent la catégorie de référence. Pour toute variable catégorielle, il existe toujours une catégorie de référence à laquelle les autres catégories sont comparées. Nous obtenons donc le hazard ratio des femmes, qui est de 0,61, avec un intervalle de confiance allant de 0,42 à 0,89. Il s'agit du hazard ratio des femmes comparées aux hommes. Le hazard ratio est inférieur à 1, ce qui signifie que les femmes ont un risque plus faible que les hommes. Si l'on soustrait 1 à 0,61 et que l'on multiplie la différence par 100, on obtient la différence de risque en pourcentage : (0,61–1,0)×100 = –39 %. Par rapport aux hommes, les femmes ont un risque de décès inférieur de 39 %. Il s'agit donc de l'« estimation ponctuelle », qui comporte une certaine incertitude. C'est pourquoi nous obtenons aussi un intervalle de confiance à 95 %, qui indique que les femmes ont (avec une certitude de 95 %) un risque inférieur de 58 % à 11 % à celui des hommes.
- Si nous avions un prédicteur à plus de 2 niveaux, l'interprétation serait la même : une catégorie sert de référence et les autres catégories lui sont comparées.
- L'intervalle de confiance des femmes n'englobe pas la valeur 1,0. Si le hazard ratio vaut 1,0, le numérateur et le dénominateur du rapport sont égaux, ce qui signifie qu'il n'y a aucune différence entre les groupes. Il s'ensuit qu'un intervalle de confiance qui englobe 1,0 indique que l'on ne peut pas affirmer avec une certitude de 95 % qu'il existe une différence entre les groupes. Pour les femmes, 1,0 n'est pas inclus dans l'intervalle de confiance ; nous pouvons donc affirmer avec une certitude de 95 % qu'il existe une différence entre hommes et femmes. Cela est confirmé par la valeur p (0,01), qui indique que le sexe est un prédicteur statistiquement significatif.
- Ce modèle inclut donc aussi age et meal.cal, en plus de sex. L'effet de sex est alors ajusté sur l'effet des autres prédicteurs du modèle (les autres prédicteurs sont « maintenus constants »).
- Age (âge) est un prédicteur continu. Le hazard ratio s'interprète donc comme l'augmentation du hazard pour chaque unité d'augmentation de l'âge. Dans cette étude, l'âge était mesuré en années, si bien que le hazard ratio correspond à l'augmentation du hazard pour chaque année de vieillissement des participants. Le résultat était de 1,02, avec un intervalle de confiance de 0,99 à 1,04. Puisque le hazard ratio (l'estimation ponctuelle) est de 1,02, cela signifie que pour chaque année de vieillissement des participants, le risque de décès augmente de 2 %. On peut facilement calculer de combien le risque augmente sur 15 ans par le calcul 1,0215, ce qui donne un hazard ratio de 1,35 (soit un risque accru de 35 %). Dans ce cas, l'intervalle de confiance englobe toutefois 1,0, puisqu'il s'étend de 0,99 à 1,04, et nous ne pouvons donc pas affirmer avec certitude que l'âge a un effet. Cette affirmation est confirmée par la valeur p, qui est de 0,15 et donc non significative.
Dans la régression de Cox, la relation entre le prédicteur et le hazard est donc linéaire. Le modèle n'est cependant pas entièrement paramétrique, puisqu'il comporte un baseline hazard. La régression de Cox est donc un modèle semi-paramétrique.
Intervalles de confiance et valeurs p du hazard ratio
Dans R comme dans tout autre logiciel statistique, on obtient automatiquement l'erreur standard (SE), les valeurs p et les intervalles de confiance lors de la construction du modèle. L'intervalle de confiance est un intervalle dit de Wald, car on utilise directement les estimations du modèle pour calculer l'intervalle.
Borne inférieure : HR – 1,96×SE
Borne supérieure : HR + 1,96×SE
Où HR est le hazard ratio et SE l'erreur standard (standard error).
Précisions sur les risques proportionnels
Les proportional hazards peuvent aussi s'expliquer par des interactions entre un prédicteur et le temps. Si un prédicteur satisfait au critère des proportional hazards, il ne doit exister aucune interaction statistiquement significative entre ce prédicteur et la durée de suivi (survival time). On peut ainsi créer un terme d'interaction (prédicteur×durée de suivi) et évaluer s'il est statistiquement significatif. Si l'interaction n'est pas significative, cela signifie que le prédicteur exerce le même effet sur la hazard function pour toutes les valeurs de t (durée de suivi), et le critère des proportional hazards est alors satisfait. Si, en revanche, l'interaction est significative, cela signifie que l'effet du prédicteur varie au cours du temps, et cette variable enfreint alors l'hypothèse des proportional hazards. Il existe d'autres façons d'évaluer les proportional hazards, à savoir :
- L'évaluation des résidus de Schoenfeld
- La représentation graphique de log(-log S(t)) en fonction de t
En réalité, il faut préférer ces deux dernières méthodes aux termes d'interaction. R dispose de fonctions simples qui présentent à la fois les résidus de Schoenfeld et les graphiques de log(-log S(t)) en fonction de t.
Stratification (le modèle de Cox stratifié)
La régression de Cox offre la possibilité d'ajuster sur des variables qui ne sont pas incluses dans le modèle, et cela se fait par stratification. Il ne faut pas confondre la stratification en régression de Cox avec la stratification en régression linéaire (multiple) classique.
En régression linéaire (multiple) classique, la stratification consiste à construire des modèles distincts selon une variable catégorielle. Voici un exemple. Supposons que nous étudions comment l'âge influence la pression artérielle et que nous disposons aussi d'informations sur le poids. Si nous voulons savoir comment l'âge influence la pression artérielle dans différentes catégories de poids, nous pouvons stratifier l'analyse en réalisant une régression pour les personnes de poids normal, une régression pour les personnes en surpoids et une régression pour les personnes obèses. Il s'agit donc de trois modèles distincts, qui fournissent des coefficients distincts pour l'âge.
En régression de Cox, la stratification peut être traitée différemment. Le modèle de Cox nous permet de stratifier les données (les patients) selon une variable catégorielle. Le baseline hazard peut varier entre ces strates. Le modèle peut ensuite estimer un effet global (cumulé) de l'âge dans toutes les strates. Nous n'obtenons alors qu'un seul coefficient pour l'âge, au lieu de coefficients distincts dans chaque strate. On peut dire que l'effet de l'âge est « poolé » (combiné) sur l'ensemble des strates.
Il existe plusieurs situations dans lesquelles il est judicieux de stratifier le modèle. Voici un exemple. Si une variable enfreint l'hypothèse des proportional hazards, on peut la catégoriser en deux niveaux appropriés ou plus et stratifier le modèle sur cette variable. On a alors ajusté sur la variable et l'on n'a pas à craindre qu'elle enfreigne l'hypothèse des proportional hazards. L'inconvénient est que l'on n'obtient aucun coefficient de régression pour cette variable (mais si elle ne présente de toute façon pas d'intérêt pour l'analyse, ce n'est pas un inconvénient majeur.