
Mesures de la capacité prédictive
angl. performance metrics, evaluation metrics
Dans plusieurs des chapitres précédents, le terme précision a été employé régulièrement pour désigner la capacité prédictive des modèles. C'est en réalité inexact, car la précision est une mesure spécifique de la capacité prédictive. Il existe un grand nombre de mesures qui décrivent différentes nuances de la capacité prédictive. Ces mesures servent à évaluer et à comparer des modèles (par exemple lors de la validation croisée). La mesure optimale dépend de la question posée et de la situation.
De ce point de vue, il existe trois types de modèles :
- Modèles de classification (classification).
- Modèles de régression (régression).
- Modèles de survie (analyse de survie).
Dans ce contexte, régression ne désigne pas le modèle classique de régression linéaire, mais tous les modèles qui prédisent des critères de jugement continus (que ce soit au moyen de modèles de régression classiques, de machine learning, d'apprentissage profond ou de toute autre méthode). Par régression, on entend ici un modèle dont le critère de jugement est continu.
La classification désigne tous les modèles, quel que soit leur type, qui prédisent un critère de jugement catégoriel. Dans la plupart des cas, le critère de jugement est binaire (oui/non, malade/sain, décédé/vivant, etc), mais il peut être multinomial (>2 catégories).
Le troisième type de modèle est l'analyse de survie, dans laquelle le critère de jugement est le délai jusqu'à la survenue d'un événement. L'analyse de survie occupe une place à part, car le critère de jugement est continu (le temps), mais en règle générale, tous les participants ne présentent pas l'événement étudié. Ceux qui ne présentent pas l'événement pendant la période d'observation de l'étude sont censurés. Le modèle n'est donc pas un modèle de classification ordinaire, et des mesures spécifiques de la capacité prédictive sont nécessaires.
Classification
Matrice de confusion (Confusion matrix)
La matrice de confusion est fondamentale pour évaluer les modèles de classification. Ce simple tableau croisé contient plusieurs mesures importantes. Le tableau croisé ci-dessous présente une matrice de confusion. La matrice se lit comme suit :
- True positive (TP) : le modèle et la réalité indiquent tous deux un résultat positif.
- True negative (TN) : le modèle et la réalité indiquent tous deux un résultat négatif.
- False positive (FP) : le modèle prédit un résultat positif, mais le résultat était en réalité négatif.
- etc.
| Prédit positif (PP) | Prédit négatif (PN) | |
|---|---|---|
| Réellement positif (P) | True positive (TP) | False negative (FN) |
| Réellement négatif (N) | False positive (FP) | True negative (TN) |
Confusion matrix (matrice de confusion).
À partir d'une matrice de confusion, on peut calculer les paramètres suivants :
- Accuracy : la proportion de positifs classés comme positifs.
- Sensibilité :
- Formule :
- Signification : proportion de positifs classés comme positifs.
- Synonymes : Recall, True Positive Rate, Hit Rate.
- Spécificité :
- Formule :
- Signification : proportion de négatifs classés comme négatifs.
- Synonyme : True Negative Rate
- Positive Predictive Value (PPV) :
- Formule :
- Signification : probabilité d'un résultat positif lorsque la prédiction est positive.
- Synonyme : Precision
- Negative Predictive Value (NPV) :
- Formule :
- Signification : probabilité d'un résultat négatif lorsque la prédiction est négative.
- F-score :
- Formule :
ROC et AUC-ROC
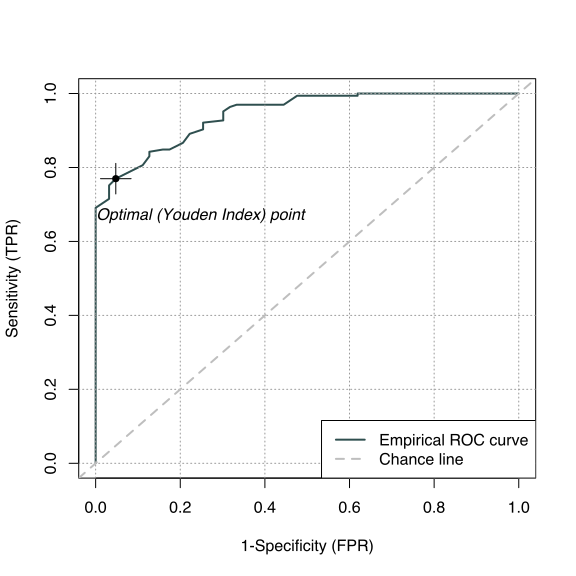
Une courbe ROC est une représentation graphique de la capacité prédictive d'un modèle de classification à critère de jugement binaire. Elle illustre comment la capacité prédictive évolue lorsque le seuil de décision est ajusté. Le seuil de décision est la valeur limite (de probabilité) à partir de laquelle un cas est classé comme positif. Si le modèle prédit que la probabilité d'un résultat positif est supérieure au seuil de décision, il prédit un résultat positif. Si le seuil de décision est fixé à une probabilité de 50 % et qu'un cas a une probabilité prédite de 49 % de résultat positif, le modèle prédira un résultat négatif. Si, en revanche, le cas a une probabilité prédite de 51 % de résultat positif, le modèle prédira un résultat positif. Si le seuil de décision est abaissé de 50 % à 10 %, beaucoup plus de cas seront classés comme positifs ; la sensibilité augmente, mais la spécificité diminue. La courbe ROC est construite en traçant la sensibilité en fonction du FPR (false positive rate, qui équivaut à 1-spécificité) pour toutes les valeurs du seuil de décision. Voici un exemple de courbe ROC.
Aire sous la courbe ROC (AUC-ROC)
Observez la ligne diagonale en pointillés sur la courbe ROC ci-dessus. L'aire sous la ligne en pointillés est de 0,5 (l'aire n'a pas d'unité). Une courbe ROC qui se confond avec la ligne diagonale n'a aucune capacité prédictive. La capacité prédictive du modèle équivaut alors au hasard. Un modèle dont la courbe ROC se situe au-dessus de la ligne fait mieux que le hasard. L'aire sous la courbe ROC permet donc de résumer la qualité du modèle. Des courbes ROC proches de 1 s'observent très rarement ; les analyses PCR virales sont un exemple d'analyses dont l'AUC-ROC est proche de 1,0. Les modèles de prédiction clinique ont en règle générale une AUC-ROC comprise entre 0,6 et 0,9. Les modèles utilisés en finance, en psychologie et dans d'autres domaines obtiennent des résultats ROC similaires.
Concordance index (C-index)
Le C-index est une généralisation de la courbe ROC. Le C-index tient compte de la censure, ce qui est indispensable pour pouvoir l'utiliser en analyse de survie. Le C-index représente la capacité globale du modèle à prédire le temps de survie.
Formule du C-index :
\begin{equation} \text{C-index} = \frac{ \sum_{i, j} \mathbb{1}_{T_j < T_i} \cdot \mathbb{1}_{\eta_j > \eta_i} \cdot \delta_j }{\sum_{i, j} \mathbb{1}_{T_j < T_i}\cdot \delta_j } \end{equation}
La régression de Cox et les autres modèles qui utilisent la fonction de perte de Cox (Cox loss) sont évalués à l'aide du C-index.
Le C-index s'interprète de manière analogue à la ROC. Un C-index de 1,0 signifie que le modèle est parfait. Un C-index de 0,5 signifie que le modèle ne fait pas mieux que le hasard.
Pour approfondir : Uno et al.
Brier score
Le Brier score sert à évaluer la capacité prédictive d'un modèle de survie au temps . Le Brier score indique donc la capacité du modèle à un instant donné. Le Brier score varie entre 0 et 1. Le Brier score est la distance quadratique moyenne entre la survie observée et la survie réelle ; une valeur de 0 signifie que le modèle est optimal, puisqu'il n'existe aucune différence entre la prédiction et l'observation.
Brier score intégré
Le Brier score intégré fournit une mesure globale du Brier score sur l'ensemble des valeurs du temps de survie (survival time).
Régression
Les mesures suivantes servent à évaluer des modèles dont le critère de jugement est continu. L'erreur (error), utilisée dans plusieurs de ces mesures, est la différence entre la valeur réelle et la valeur prédite de .
R2
Le R2 est la part de variance expliquée par le modèle. Cette mesure est très répandue pour évaluer les modèles dont le critère de jugement est continu. Le R2 prend une valeur comprise entre 0 et 1, où 0 signifie que le modèle n'explique aucune variance (c'est-à-dire que le modèle n'a aucun pouvoir explicatif) et 1 que le modèle explique toute la variance.
\begin{equation} {R}^{2} = 1 - \frac { \sum_{i=1}^{n} (\ y_i -\hat{y_i} )^{2} } { \sum_{i=1}^{n} (\ y_i -\bar{y_i} )^{2} } \end{equation}
MAE (Mean Absolute Error)
La MAE est la moyenne de l'erreur absolue. Les erreurs ne sont pas élevées au carré, ce qui rend la mesure moins sensible aux valeurs aberrantes isolées (valeurs extrêmes).
\begin{equation} MAE = \frac{1}{n} \sum_{i=1}^{n} |{y_i}-\hat{y_i}| \end{equation}
MAPE (Mean Absolute Percent Error)
La MAPE est la MAE exprimée en pourcentage, une mesure facile à comprendre. L'inconvénient de la MAPE est que, si l'erreur = 0, la MAPE ne peut pas être calculée, car une division (pour calculer le pourcentage) par 0 donne un nombre infini. De plus, la MAPE a tendance à favoriser les modèles qui prédisent des valeurs de Y inférieures aux valeurs réelles.
\begin{equation} MAPE = \frac{1}{n} \sum_{i=1}^{n} {\left|\frac{{y_i}-\hat{y_i}}{y_i}\right|} \end{equation}
RMSE (Root Mean Squared Error)
La RMSE est la racine carrée de la moyenne des erreurs au carré. La RMSE indique à quelle distance les prédictions se situent de la valeur réelle, dans la même unité que Y. Comme l'erreur est élevée au carré, les valeurs aberrantes isolées (valeurs extrêmes) ont une plus grande influence sur la RMSE que sur la MAE et la MAPE.
\begin{equation} RMSE = \sqrt{\frac{1}{n} \sum_{i=1}^{n} ({y_i}-\hat{y_i}){^2}}\end{equation}