
Régression de Cox
La régression de Cox est pratiquement synonyme d'analyse de survie, en raison des nombreux avantages de la méthode par rapport aux autres modèles de régression. Les alternatives à la régression de Cox, par exemple la régression de Weibull, produisent dans certaines circonstances des modèles plus exacts, au prix d'une complexité accrue. La régression de Cox est un modèle simple et puissant pour étudier la survie. La différence entre la régression de Cox et l'estimateur de Kaplan-Meier tient au fait que la première est un modèle de régression, ce qui signifie que l'on peut étudier l'influence de plusieurs prédicteurs sur la survie. Comme la régression multiple classique, la régression de Cox peut inclure un ou plusieurs prédicteurs.
Il est conseillé de lire les chapitres Analyse de survie et Estimateur de Kaplan-Meier avant celui-ci. Il n'est pas nécessaire de comprendre toutes les formules ci-dessous pour utiliser la régression de Cox. La discussion mathématique est suivie d'explications et d'exemples pratiques sur la réalisation et l'interprétation des régressions de Cox.
La régression de Cox permet d'étudier la relation entre des prédicteurs (covariables) et le temps de survie (survival time, durée d'observation). Pour comprendre la régression de Cox, on part de la fonction de risque instantané (hazard function), , et de la fonction de survie (survival function), .
- : la fonction de survie (survival function) est la probabilité qu'une personne soit encore en vie après l'instant .
- Interprétation : Quelle est la probabilité que je sois en vie dans 1 an ?
- : la fonction de risque instantané (hazard function, hazard rate) est le risque (la probabilité) instantané que l'événement survienne à l'instant , à condition que la personne ait survécu jusqu'à .
- Interprétation : Quelle est la probabilité que je décède dans 1 an, sachant que j'ai survécu jusqu'à maintenant ?
et possèdent des propriétés qui les rendent adaptées à l'étude de la survie. Cela ressort notamment des questions pertinentes auxquelles ces fonctions répondent (voir l'interprétation ci-dessus).
Le temps de survie (survival time, T) est une variable continue (souvent exprimée en nombre de jours) et peut donc être décrit par une fonction de répartition (cumulative distribution function, CDF) :
décrit la probabilité que soit inférieur ou égal à . Le temps de survie est noté et peut lui aussi être décrit par une fonction de répartition :
décrit la probabilité que l'événement survienne au plus tard à l'instant . La probabilité qu'un nouveau-né décède à l'âge de 90 ans est d'environ 1 %, mais si l'enfant atteint l'âge de 89 ans, la probabilité de décéder le jour de ses 90 ans est de 10 %. À partir de , on peut estimer , c'est-à-dire la probabilité que l'individu survive au-delà de l'instant :
est la probabilité de survivre au-delà de l'instant .
La fonction de risque instantané (hazard function) a la formule suivante :
signifie que le rapport s'applique lorsque le risque (hazard) est étudié sur une période très courte, c'est-à-dire lorsque (la variation de ) tend vers . Le numérateur de contient |, ce qui signifie qu'il s'agit d'une probabilité conditionnelle. Le numérateur décrit la probabilité que l'événement survienne pendant un petit intervalle de temps compris entre et , conditionnellement au fait que l'individu ait survécu jusqu'à . Le dénominateur indique la longueur de l'intervalle de temps (). La fonction de risque instantané () équivaut donc au taux d'événements (event rate, la vitesse à laquelle les événements surviennent) chez les individus qui n'ont pas encore présenté l'événement.
Le numérateur de correspond au rapport entre la probabilité que T se situe dans l'intervalle à et , ce dernier terme étant équivalent à , tandis que le premier peut se reformuler en pour de petites valeurs de . En divisant ce rapport par , on obtient la formule suivante :
Il s'agit de la fonction de risque instantané sous sa forme simple. Elle indique que la vitesse à laquelle les événements surviennent à l'instant équivaut à la densité (en anglais density) des événements à l'instant , divisée par la probabilité de survivre jusqu'à l'instant sans présenter l'événement. Le numérateur est une fonction de densité (probability density function, PDF). Comme est la dérivée de , la formule peut s'écrire comme suit :
Si on l'intègre de à , avec , on peut utiliser la formule suivante pour décrire la probabilité de survivre jusqu'à l'instant en fonction du risque instantané à tous les instants jusqu'à .
L'intégrale ci-dessus est le risque cumulé (cumulative hazard, cumulative risk) et se formule comme suit :
Le risque cumulé est le risque accumulé par un individu lorsqu'il passe de à .
À partir de , on peut toujours calculer et obtenir ainsi . À partir de , on peut toujours calculer le risque cumulé et en prendre l'exponentielle pour obtenir .
Un individu qui a survécu jusqu'à l'instant s'intéresse en général davantage à sa probabilité conditionnelle de survie qu'à sa probabilité non conditionnelle. En pratique, cela signifie qu'un individu qui a survécu jusqu'à l'instant après un diagnostic de cancer s'intéresse davantage à sa survie attendue à partir de l'instant . De plus, la fonction de risque instantané constitue un calcul simple et pragmatique lorsque les observations sont censurées à droite.
Régression de Cox
Dans la régression de Cox, le risque instantané d'un individu présentant les prédicteurs (covariables) est décrit comme suit :
Où est le risque de base (baseline hazard), c'est-à-dire le risque de l'individu lorsque toutes les variables valent 0 (pour les variables continues) ou se trouvent à leur niveau de référence (pour les variables catégorielles), et correspond aux prédicteurs exponentiés. La seule quantité ci-dessus qui dépend de est le risque de base. Comme on le verra ci-dessous, le risque de base s'élimine automatiquement, de sorte que le risque instantané devient indépendant de .
Si tous les prédicteurs valent 0, l'exposant entier disparaît et la formule devient :
.
Cette formule est la définition du risque de base, c'est-à-dire le risque instantané lorsque tous les prédicteurs valent 0. Le risque de base ne présente pas d'intérêt en régression de Cox. Aucune hypothèse n'est faite à son sujet et il peut varier librement. L'explication est que la régression de Cox vise à comparer des expositions (par exemple des traitements, des interventions, etc.) et que, lorsque deux individus sont comparés, leurs risques de base s'annulent mutuellement, comme le montre la démonstration ci-dessous.
Si l'on prend le logarithme des deux membres de l'équation, on obtient un modèle dans lequel les effets des prédicteurs sont additifs (c'est-à-dire qu'ils exercent une influence indépendante sur le critère de jugement étudié) et linéaires, ce qui rappelle la régression linéaire classique.
Supposons que l'on étudie l'association entre le prédicteur sexe et la survie. Le sexe est défini comme suit :
Pour cette variable, les hommes constituent le groupe de référence. La régression de Cox pour ce modèle s'écrit comme suit :
Risque instantané chez les hommes :
Risque instantané chez les femmes :
Hazard ratio (HR, rapport des risques instantanés)
Le hazard ratio (HR) se calcule comme le rapport entre les risques instantanés des groupes, le groupe de référence (les hommes) constituant le dénominateur :
L'effet de est le même pour toutes les valeurs de . La formule suppose, et n'est valable que si, le hazard ratio ne varie pas au cours du temps. C'est pour cette raison que le modèle de Cox est aussi appelé modèle à risques proportionnels de Cox (Cox proportional hazards model).
La régression de Cox signifie donc que le risque instantané (hazard) à l'instant est le produit du risque de base et de l'exponentielle de l'effet combiné des prédicteurs.
La régression de Cox en pratique
Le risque de base dans la régression de Cox
est le risque de base (baseline hazard), une quantité qui peut être difficile à comprendre. Le risque de base est le risque que présente l'individu lorsque tous les prédicteurs valent 0. Voici deux exemples :
- Supposons que l'on étudie l'influence de l'âge sur la mortalité. Dans une régression de Cox où l'âge est le seul prédicteur, le risque de base serait le risque d'un être humain à l'âge de 0 an. Après la naissance, le risque augmente à mesure que l'âge augmente.
- Supposons que l'on étudie l'influence de la pression artérielle sur la mortalité. Dans un tel modèle, le risque de base serait le risque de l'individu pour une pression artérielle égale à 0, ce qui n'a pas de sens biologique (aucune personne vivante n'a une pression artérielle de 0). Cela signifie que le risque de base est le risque de l'individu lorsque tous les prédicteurs sont fixés à 0, ce qui revient à un modèle sans prédicteurs.
Prédicteurs (covariables) dans la régression de Cox
sont les prédicteurs (covariables) utilisés pour modéliser la fonction de risque instantané d'un individu. L'ensemble des prédicteurs ressemble donc à une régression multiple (linéaire) classique. Les prédicteurs peuvent être des variables continues ou catégorielles. Les prédicteurs exercent un effet additif, ce qui signifie que chaque prédicteur a un effet sur le critère de jugement () indépendant des autres prédicteurs. Par ailleurs, la relation entre les prédicteurs et le critère de jugement est linéaire. Les hypothèses d'additivité et de linéarité peuvent être modifiées (voir ci-dessous).
Risques proportionnels (proportional hazards)
Comme indiqué plus haut, le risque instantané (hazard) à l'instant est le produit du risque de base et de l'exponentielle de l'effet combiné des prédicteurs. Cela est vrai sous l'hypothèse que les risques instantanés sont proportionnels au cours du temps. Les risques proportionnels signifient que le rapport entre les fonctions de risque instantané de deux individus doit être constant au cours du temps. Cela s'applique à toutes les caractéristiques qui définissent les individus. En voici un exemple.
Si l'on étudie la mortalité chez des personnes avec ou sans diabète, le rapport entre la fonction de risque instantané des diabétiques et celle des non-diabétiques doit être constant pendant toute la durée du suivi. Si le risque de décès est multiplié par 2 chez les diabétiques au début du suivi, il doit rester aussi élevé (multiplié par 2) chez les diabétiques pendant toute la durée du suivi de l'étude.
Le rapport entre deux fonctions de risque instantané est le hazard ratio (HR). Il s'agit donc de la différence relative de risque entre deux individus. Comme figure à la fois au numérateur et au dénominateur, il s'élimine. Le temps n'apparaît pas non plus dans l'équation. Seules les valeurs des prédicteurs distinguent donc l'individu 1 de l'individu 2 ; ni le risque de base ni le temps ne peuvent influencer le hazard ratio, qui est par conséquent constant entre l'individu 1 et l'individu 2. Cela signifie aussi que si l'un des prédicteurs () avait un effet variable au cours du temps, la condition des risques proportionnels ne serait pas remplie et le modèle deviendrait invalide.
Hazard ratio (rapport des risques instantanés)
Le hazard ratio se calcule en divisant le risque instantané d'un individu par le risque instantané d'un autre individu (voir la formule ci-dessus). Le hazard ratio est calculé lorsqu'un événement survient. Si un événement survient à l'instant t, le hazard ratio est calculé en divisant le risque instantané de l'individu qui a présenté l'événement par le risque instantané des autres individus parvenus jusqu'à l'instant t sans présenter l'événement. Le risque de base disparaît du rapport (voir ci-dessus) ; de même, l'instant considéré est sans importance puisque tous les individus sont comparés au même instant. Ce qui caractérise les individus, ce sont donc leurs prédicteurs (x1, x2 … xk). On peut ainsi analyser l'effet des prédicteurs.
Une régression de Cox estime donc les coefficients des prédicteurs (), qui représentent l'influence de ces prédicteurs sur la survie. Le hazard ratio obtenu en divisant les risques instantanés de deux individus est sur l'échelle logarithmique, ce qui le rend difficile à interpréter. Pour y remédier, on prend l'exponentielle du coefficient. Si le coefficient de régression vaut 0,5, le coefficient exponentié vaut e0,5 = 1,65. Lorsque l'on emploie le terme hazard ratio, on désigne en réalité le coefficient exponentié.
Interprétation du hazard ratio
- Pour un prédicteur continu, le hazard ratio correspond à l'augmentation ou à la diminution du risque instantané associée à une augmentation d'une unité du prédicteur .
- Pour une variable catégorielle, le hazard ratio correspond à la différence de risque instantané entre deux groupes (ou plus), l'un des groupes servant de groupe de référence.
Pour mieux comprendre, il nous faut un exemple, que nous allons construire nous-mêmes dans R.
Exemple de régression de Cox dans R
Nous utiliserons les données d'un essai clinique sur le cancer du côlon. Ces données se trouvent dans le package survival, qui contient également de nombreuses fonctions importantes pour l'analyse de survie.
## Charger tidyverse
library(tidyverse)

## Charger le package survival
library(survival)

## Importer les données d'exemple
data(cancer)
## Inspecter les premières lignes
head(colon)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1Nous recodons certaines variables afin qu'elles soient correctement traitées comme catégorielles :
## Recoder certaines variables catégorielles
colon <- colon |>
  mutate(sex = recode_factor(sex, '1'='Man', '0'='Kvinna'),
         perfor = recode_factor(perfor, '1'='Yes', '0'='No'),
         obstruct = recode_factor(obstruct, '1'='Yes', '0'='No'))
Nous construisons maintenant une régression de Cox à l'aide de la fonction coxph(). Le résultat est enregistré dans l'objet min_modell. Notez qu'il faut spécifier un objet de survie à l'aide de la fonction Surv(). Dans Surv(), nous indiquons quelles variables correspondent à la durée d'observation (time) et au critère de jugement (status). Ici, nous précisons avec status==1 quelle valeur de status signifie que l'événement est survenu.
min_modell <- coxph(Surv(time, status==1) ~ sex + age + nodes + perfor + obstruct, data=colon)

## Afficher le résultat
summary(min_modell)Call:
coxph(formula = Surv(time, status == 1) ~ sex + age + nodes +
perfor + obstruct, data = colon)
n= 1822, number of events= 897
(36 observations deleted due to missingness)
coef exp(coef) se(coef) z Pr(>|z|)
sexKvinna 0.057961 1.059674 0.067077 0.864 0.38753
age 0.001363 1.001364 0.002822 0.483 0.62911
nodes 0.088342 1.092362 0.006342 13.929 < 2e-16 ***
perforNo -0.223009 0.800107 0.181919 -1.226 0.22025
obstructNo -0.249065 0.779529 0.082675 -3.013 0.00259 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
exp(coef) exp(-coef) lower .95 upper .95
sexKvinna 1.0597 0.9437 0.9291 1.2086
age 1.0014 0.9986 0.9958 1.0069
nodes 1.0924 0.9154 1.0789 1.1060
perforNo 0.8001 1.2498 0.5601 1.1429
obstructNo 0.7795 1.2828 0.6629 0.9167
Concordance= 0.635 (se = 0.009 )
Likelihood ratio test= 145.1 on 5 df, p=<2e-16
Wald test = 202.8 on 5 df, p=<2e-16
Score (logrank) test = 206.2 on 5 df, p=<2e-16Cette sortie est certes informative, mais il y manque certaines informations et elle n'est pas assez soignée sur le plan esthétique pour figurer dans un rapport. Le package gtsummary permet de produire un tableau esthétique et facile à modifier. Les fonctions de gtsummary fonctionnent comme les autres fonctions du tidyverse : on ajoute progressivement des couches de composants, comme ci-dessous. Vous devinerez sans doute ce que chacune des fonctions ajoute au tableau.
library(gtsummary)

min_modell |>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()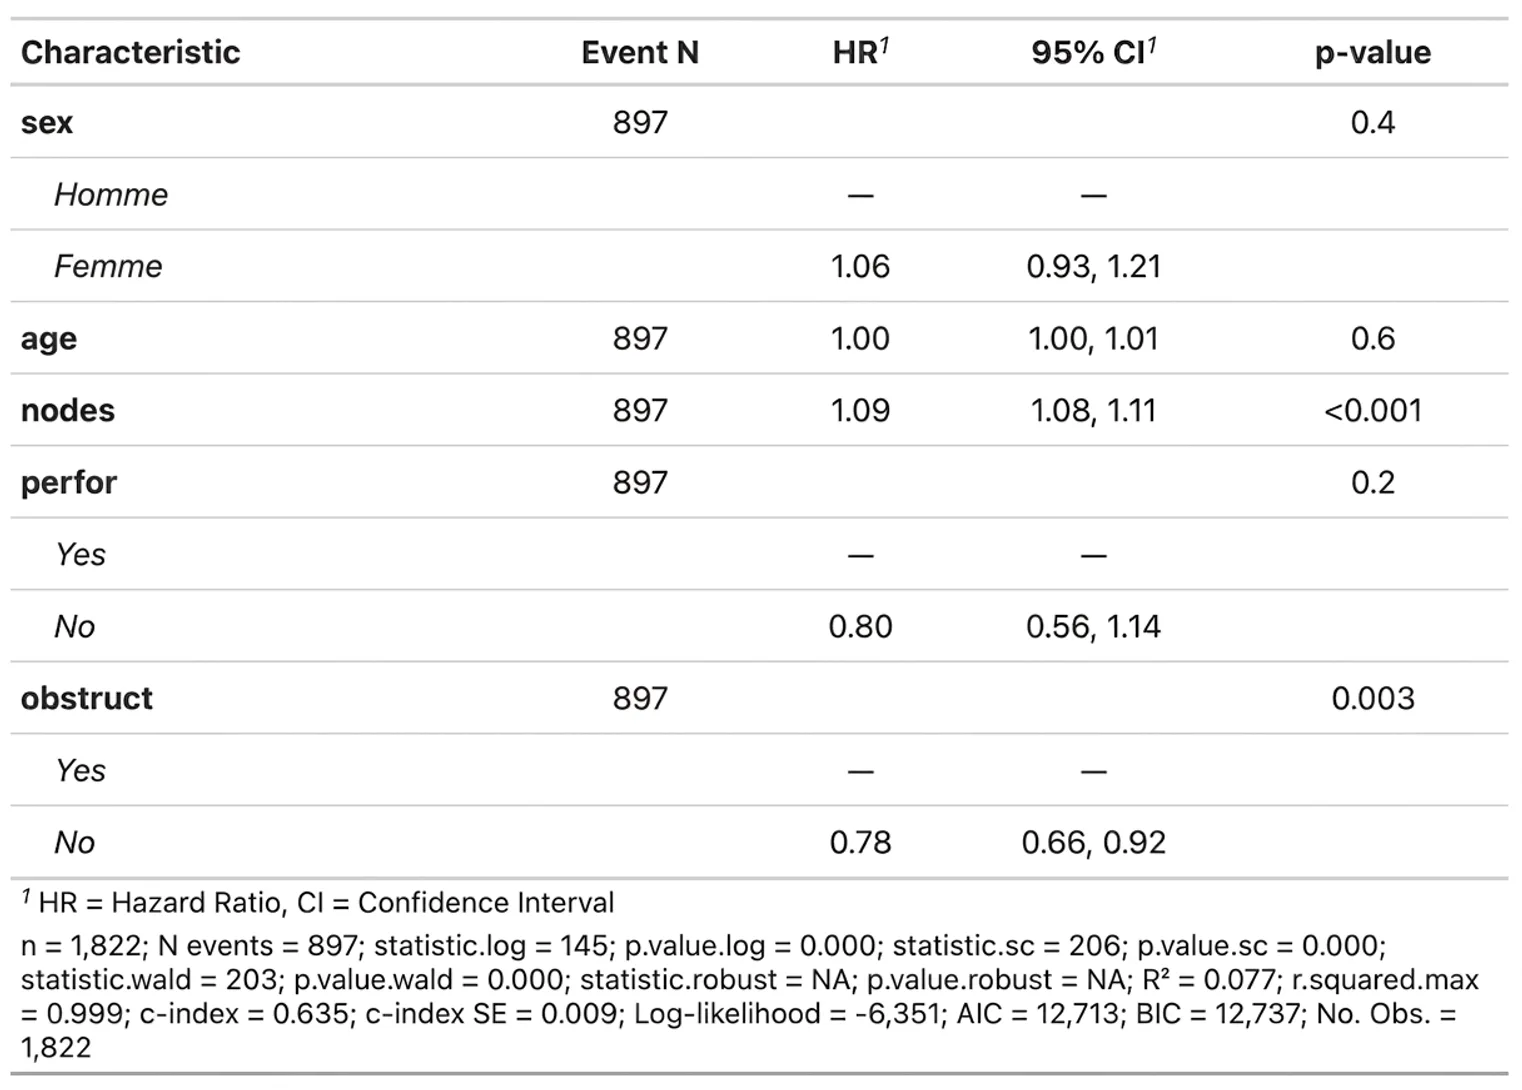
Interprétation de la régression de Cox
Le modèle ci-dessus comporte cinq prédicteurs : sex, age, nodes, perfor et obstruct. Sex est un prédicteur catégoriel à deux niveaux, Man (homme) et Kvinna (femme). Age et nodes sont des prédicteurs continus. Le hazard ratio (HR) est présenté avec un intervalle de confiance à 95 % (IC à 95 %). Les hazard ratios ci-dessus s'interprètent comme suit :
- Aucun hazard ratio n'est indiqué pour les hommes. Cela tient au fait que les hommes constituent le niveau de référence de la variable sex. Toute variable catégorielle possède un niveau de référence auquel les autres niveaux sont comparés.
- Le hazard ratio pour les femmes est de 1,06, ce qui signifie que le risque relatif est 1,06 fois plus élevé (soit 6 % plus élevé) chez les femmes que chez les hommes. L'intervalle de confiance va de 0,93 à 1,21. Cela signifie qu'avec une probabilité de 95 %, le vrai risque chez les femmes se situe entre 0,93 (soit un risque inférieur de 7 % chez les femmes par rapport aux hommes) et 1,21 (soit un risque supérieur de 21 % chez les femmes par rapport aux hommes). Cet intervalle de confiance inclut donc la valeur 1,0, ce qui signifie qu'un risque aussi bien plus faible que plus élevé chez les femmes par rapport aux hommes est possible. C'est pourquoi la variable sex n'est pas statistiquement significative. C'est également ce qu'indique la valeur p, qui est de 0,4.
- Il s'ensuit que si un intervalle de confiance inclut la valeur 1,0, le prédicteur n'est pas statistiquement significatif.
- Il s'ensuit également qu'un prédicteur catégoriel doit avoir un niveau de référence auquel les autres niveaux sont comparés.
- Pour la variable age, le hazard ratio est de 1,00 et l'intervalle de confiance inclut lui aussi 1,00, de sorte que la variable n'est pas un prédicteur statistiquement significatif.
- Pour la variable nodes, le hazard ratio est de 1,09, ce qui signifie qu'à chaque augmentation d'une unité de nodes, le risque de l'événement (décès) augmente de 9 %. L'intervalle de confiance va de 1,08 à 1,11, ce qui signifie qu'avec une probabilité de 95 %, la vraie valeur correspond à une augmentation du risque de l'événement comprise entre 8 % et 11 % pour chaque augmentation d'une unité de nodes. La valeur p est < 0,001, ce qui est nettement significatif.
- Pour chaque prédicteur du modèle, le hazard ratio est ajusté sur les autres variables du modèle. L'effet d'une augmentation d'une unité de nodes est de 1,09 (risque augmenté de 9 %), après ajustement sur les autres prédicteurs du modèle.
- Ce modèle inclut donc aussi age et meal.cal, en plus de sex. L'effet de sex est alors ajusté sur l'effet des autres prédicteurs du modèle (les autres prédicteurs sont « maintenus constants »).
L'intervalle de confiance dans la régression de Cox
On utilise le plus souvent l'intervalle de confiance de Wald, qui se calcule simplement à partir de l'erreur type (standard error, SE) :
Borne inférieure : HR − 1,96×SE
Borne supérieure : HR + 1,96×SE
Où HR est le hazard ratio et SE l'erreur type.
Compléments sur les risques proportionnels (PH)
Les risques proportionnels peuvent aussi s'expliquer par des interactions entre un prédicteur et le temps (durée de suivi). Si un prédicteur satisfait au critère des risques proportionnels, il ne doit pas exister d'interaction statistiquement significative entre ce prédicteur et la durée de suivi (survival time). On peut donc créer un terme d'interaction (prédicteur × durée de suivi) et évaluer s'il est statistiquement significatif. Si l'interaction n'est pas significative, cela signifie que le prédicteur exerce le même effet sur la fonction de risque instantané pour toutes les valeurs de t (durée de suivi), et le critère des risques proportionnels est alors rempli. Si en revanche l'interaction est significative, cela signifie que l'effet du prédicteur varie au cours du temps, et cette variable enfreint alors l'hypothèse des risques proportionnels. Il existe d'autres manières d'évaluer les risques proportionnels, à savoir :
- Évaluation des résidus de Schoenfeld
- Représentation graphique de log(-log S(t)) en fonction de t
En réalité, il convient de préférer ces deux dernières méthodes aux termes d'interaction. R propose des fonctions simples qui présentent à la fois les résidus de Schoenfeld et les graphiques de log(-log S(t)) en fonction de t.
Pour évaluer l'hypothèse des PH, on peut utiliser le code suivant :
library(survminer)

cox_ph <- cox.zph(min_modell)

ggcoxzph(cox_ph)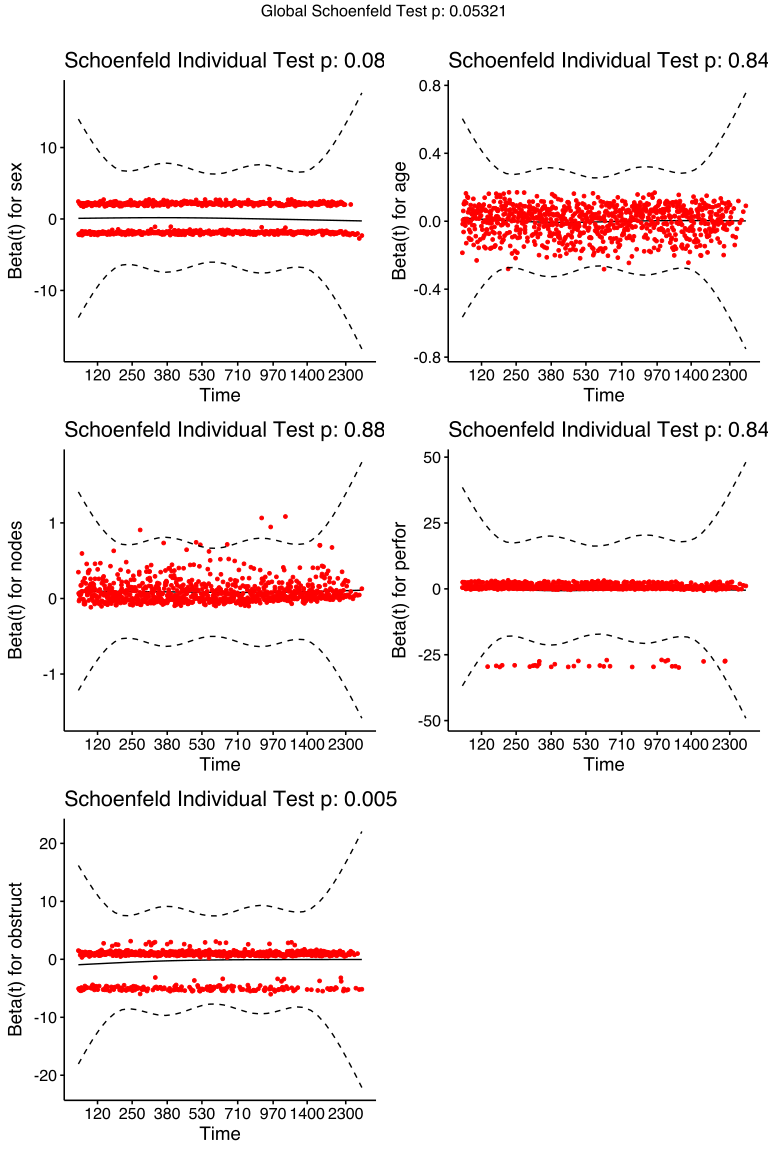
Les graphiques ci-dessus montrent comment varie au cours du temps pour chaque prédicteur. Il ne doit y avoir ni pente ni tendance systématique s'écartant de la ligne horizontale. Si tel est le cas, l'effet de est constant au cours du temps et l'hypothèse des risques proportionnels est remplie.
Si une variable enfreint l'hypothèse des PH, on peut y remédier de l'une des manières suivantes :
- Inclure dans le modèle une interaction entre la variable et le temps.
- Stratifier sur la variable qui enfreint l'hypothèse des PH. L'inconvénient est que l'on n'obtient pas de hazard ratio pour une variable utilisée pour stratifier. Ce n'est toutefois un problème que si l'on s'intéresse précisément au hazard ratio de cette variable.
Régression de Cox stratifiée
La régression de Cox offre la possibilité d'ajuster sur des variables qui ne figurent pas dans le modèle, et cela se fait par stratification. Il ne faut pas confondre la stratification en régression de Cox avec la stratification en régression linéaire (multiple) classique.
En régression linéaire (multiple) classique, stratifier signifie construire des modèles distincts selon une variable catégorielle. Supposons que l'on étudie l'influence de l'âge sur la pression artérielle et que l'on dispose aussi d'informations sur le poids. Si l'on veut savoir comment l'âge influence la pression artérielle selon la catégorie de poids, on peut stratifier l'analyse en réalisant une régression pour les personnes de poids normal, une régression pour les personnes en surpoids et une régression pour les personnes obèses. Il s'agit donc de trois modèles distincts, qui fournissent des coefficients distincts pour l'âge.
En régression de Cox, la stratification peut être traitée différemment. La régression de Cox permet de stratifier les données (les observations) selon une variable catégorielle. Le risque de base peut varier d'une strate à l'autre. Le modèle peut ensuite estimer un effet global (cumulé) de l'âge sur l'ensemble des strates. On obtient alors un seul coefficient pour l'âge, au lieu de coefficients distincts dans chaque strate. On peut dire que l'effet de l'âge est « poolé » (combiné) sur l'ensemble des strates.
Il existe plusieurs situations dans lesquelles il est judicieux de stratifier le modèle. Si une variable enfreint l'hypothèse des risques proportionnels, on peut la catégoriser en deux niveaux appropriés ou plus et stratifier le modèle sur cette variable. On a alors ajusté sur la variable, sans avoir à se préoccuper du fait qu'elle enfreint l'hypothèse des risques proportionnels. L'inconvénient est que l'on n'obtient aucun coefficient de régression pour cette variable (mais si elle ne présente de toute façon pas d'intérêt pour l'analyse, ce n'est pas un inconvénient majeur.
Le code suivant stratifie la régression de Cox sur le sexe (sex) :
min_modell <- coxph(Surv(time, status==1) ~ strata(sex) + age + nodes + perfor + obstruct, data=colon)Nous affichons le résultat avec la fonction tbl_regression(), comme suit :
min_modell|>
  tbl_regression(exponentiate = TRUE) |>
  add_global_p() |>
  bold_labels() |>
  italicize_levels() |>
  add_nevent() |>
  add_glance_source_note()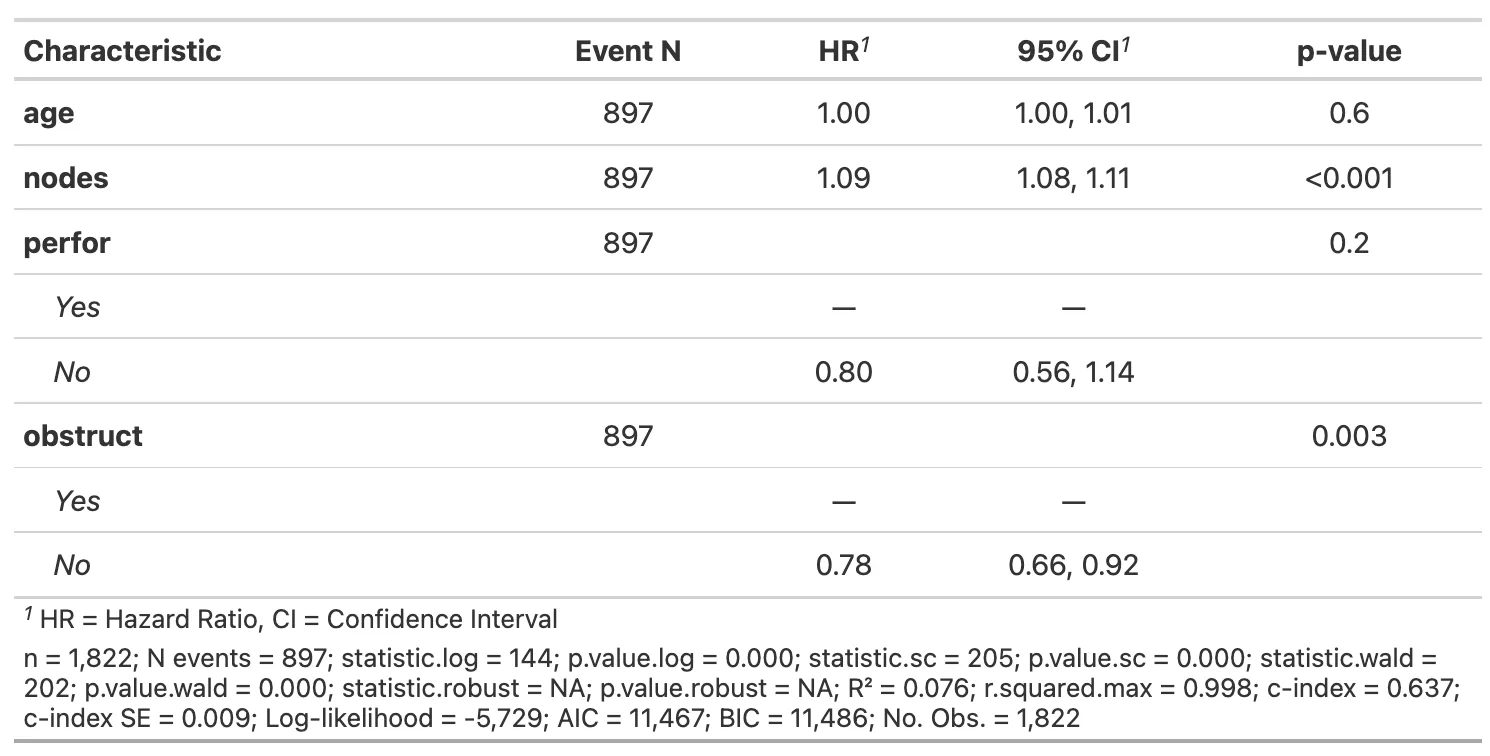
Comme on le voit ci-dessus, la stratification n'a pas modifié les hazard ratios des autres prédicteurs du modèle.
Références
Germán Rodríguez, Survival Models, Princeton university.
Cox DR and Oakes D (1984). Analysis of Survival Data. Chapman and Hall, New York.
Kalbfleisch JD and Prentice RL (2002). The Statistical Analysis of Failure Time Data. Second Edition. Wiley, New York.
Klein and Moeschberger (1997). Survival Analysis: Techniques for Censored and Truncated Data. Springer-Verlag, New York.
Lagakos SW (1979). General right censoring and its impact on the analysis of survival data, Biometrics 35:139-156.
Lawless JF (2003). Statistical Models and Methods for Lifetime Data. Wiley, New York.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part I: Basic concepts and first analyses. 232-238. ISSN 0007-0920.
M J Bradburn, T G Clark, S B Love, & D G Altman. (2003). Survival Analysis Part II: Multivariate data analysis – an introduction to concepts and methods. British Journal of Cancer, 89(3), 431-436.
Bradburn, M., Clark, T., Love, S., & Altman, D. (2003). Survival analysis Part III: Multivariate data analysis – choosing a model and assessing its adequacy and fit. 89(4), 605-11.
Clark, T., Bradburn, M., Love, S., & Altman, D. (2003). Survival analysis part IV: Further concepts and methods in survival analysis. 781-786. ISSN 0007-0920.