Dans ce chapitre, nous utilisons tidymodels pour créer et comparer différents modèles au sein d'un flux de travail (workflow). Comme dans le chapitre précédent, nous optimiserons les modèles par validation croisée. Voici ce que nous allons faire :
- Tous les modèles sont évalués par rééchantillonnage (validation croisée).
- Deux recettes différentes sont évaluées.
- Trois modèles différents sont évalués.
- Deux des modèles font l'objet d'une optimisation des hyperparamètres. Pour l'un d'eux, celle-ci repose sur la définition manuelle d'une grid (combinaison d'hyperparamètres). Pour l'autre, nous laissons R générer la grid.
Nous commençons par charger les packages nécessaires ainsi que les données d'une étude portant sur des patients atteints d'un cancer du côlon.
library(tidyverse) # pour la manipulation des données
library(tidymodels) # package de base pour la modélisation prédictive
library(dials) # pour optimiser les hyperparamètres
library(finetune) # fonctions supplémentaires pour optimiser les hyperparamètres
Les données de cet exercice proviennent du package survival, qui met à disposition des données sur des patients atteints d'un cancer du côlon. Nous chargeons survival et tous les jeux de données issus d'études sur le cancer. Nous inspectons ensuite colon, le jeu de données avec lequel nous allons travailler.
library(survival)
data(cancer) # charger tous les jeux de données des études sur le cancer
head(colon, 10) # inspecter les 10 premières lignes de l'étude sur le cancer du côlon
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1Dans colon, la colonne status correspond au critère de jugement de l'étude. La valeur 1 indique que le patient est décédé et la valeur 0 qu'il a survécu. Comme dans le chapitre précédent, nous allons modifier les données colon selon les étapes suivantes :
- Nous recodons
status1enYeset0enNo, et transformons la variable en facteur avec la fonctionrecode_factor(). - Nous recodons
sexafin qu'il indique Kvinna et Man au lieu de 0 et 1 respectivement. - Nous supprimons les colonnes
time,idetstudy, car nous ne les utiliserons pas dans notre modèle. - Les variables codées
0/1sont recodées enNo/Yesde manière astucieuse avecmutate(across()). Notez qu'avecacross(), nous pouvons sélectionner plusieurs colonnes auxquelles appliquer la fonctionrecode_factor(); la colonne est ensuite représentée par.xdans la fonction. Voir la ligne 5 ci-dessous.
colon2 <- colon |>
  mutate(status = recode_factor(status, "1"="Yes", "0"="No"),
         sex = recode_factor(sex, "0"="Kvinna", "1"="Man")) |>
  select(-time, -id, -study) |>
  mutate(across(c(obstruct, adhere, perfor, surg, node4), ~recode_factor(.x, "0"="No", "1"="Yes")))

## Inspecter les données
head(colon2, 10)
rx sex age obstruct perfor adhere nodes status differ extent surg node4 etype
1 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 2
2 Lev+5FU Man 43 No No No 5 Yes 2 3 No Yes 1
3 Lev+5FU Man 63 No No No 1 No 2 3 No No 2
4 Lev+5FU Man 63 No No No 1 No 2 3 No No 1
5 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 2
6 Obs Kvinna 71 No No Yes 7 Yes 2 2 No Yes 1
7 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 2
8 Lev+5FU Kvinna 66 Yes No No 6 Yes 2 3 Yes Yes 1
9 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 2
10 Obs Man 69 No No No 22 Yes 2 3 Yes Yes 1Cartographier et imputer les données manquantes
Nous poursuivons en examinant la présence de données manquantes dans colon2. Pour cela, nous utilisons la fonction vis_miss() du package visdat, comme suit :
library(visdat)
vis_miss(colon2)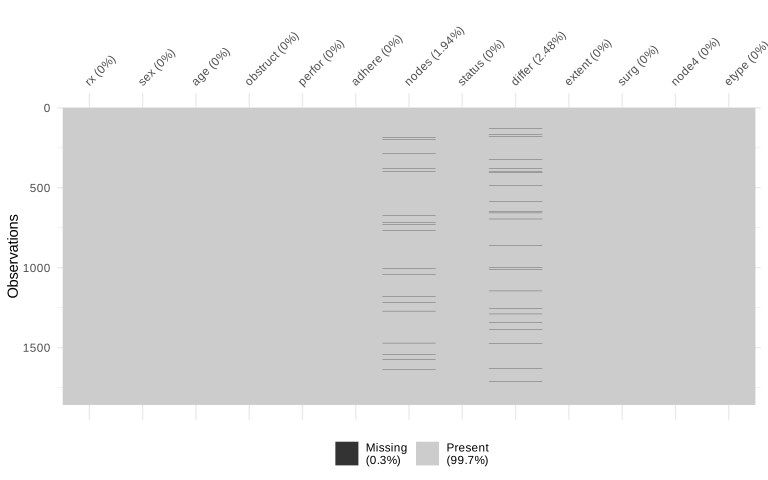
Comme le montre le résultat ci-dessus, nous obtenons une figure dans laquelle les colonnes et les lignes de colon2 sont représentées sous forme de rectangle. On constate qu'au total 0,3 % de l'ensemble des valeurs de colon2 sont manquantes. Bien que ce chiffre soit inhabituellement faible, nous choisissons tout de même d'imputer ces valeurs avec la fonction missRanger(), disponible dans le package du même nom. Le résultat est enregistré dans colon3, qui est désormais un data frame sans données manquantes (toutes les valeurs manquantes ont été imputées).
library(missRanger)
colon3 <- missRanger(data=colon2, maxiter=10, pmm.k = 5)

vis_miss(colon3)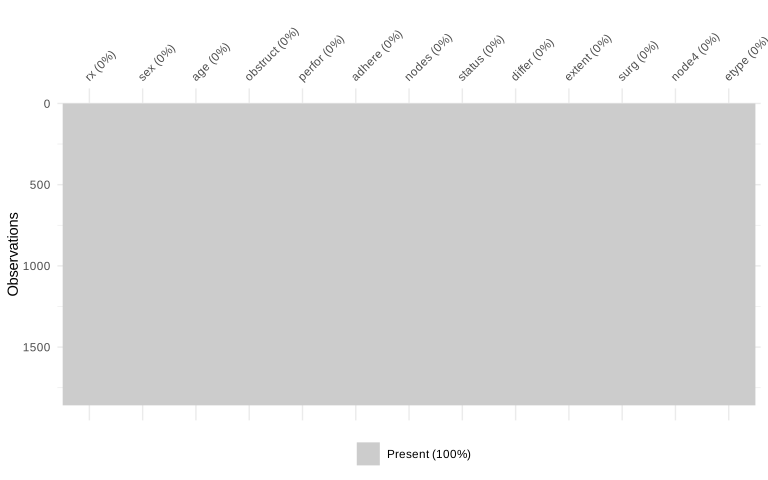
Créer les données d'entraînement, les données de test et le rééchantillonnage (validation croisée)
Nous divisons à présent colon3 en données d'entraînement (70 % des données) et données de test (30 %). Comme l'étude vise à examiner l'événement décès, nous choisissons de stratifier la partition sur le critère de jugement (strata=status), afin que la proportion de décès soit identique dans les données d'entraînement et les données de test.
## Crée les données d'entraînement et de test, avec set.seed() en premier
set.seed(1)

colon_split <- initial_split(colon3, strata=status, prop=0.7)
colon_train <- training(colon_split)
colon_test  <- testing(colon_split)

## Crée la validation croisée sur les données d'entraînement
my_cross_validation <- vfold_cv(colon_train,
                                v = 5,
                                repeats=10,
                                strata = status)
Notez que nous avons indiqué set.seed(1), ce qui élimine l'effet du hasard lors de la génération des données de test et d'entraînement. Nous pouvons ainsi obtenir exactement les mêmes observations dans les données d'entraînement et de test à chaque utilisation de initial_split(). Cela peut être souhaitable pour obtenir des résultats exactement reproductibles.
Créer les recettes
Nous créons deux recettes. La première s'appelle base_recept. Consultez les commentaires du code ci-dessous pour voir quelles étapes de prétraitement sont effectuées. La seconde s'appelle extended_recipe ; elle repose sur base_recept mais comporte en plus step_pca(). Si la méthode ACP (PCA) ne vous est pas familière, retenez simplement pour l'instant que l'ACP est une méthode qui réduit le nombre de prédicteurs numériques, ce qui conduit parfois à de meilleurs modèles.
## Recette de base
base_recipe <- recipe(status ~ ., data=colon_train) |>
  # Normalisation des prédicteurs numériques
  step_normalize(all_numeric()) |>
  # Crée des variables indicatrices (dummy) à partir des variables catégorielles
  step_dummy(all_nominal_predictors()) |>
  # Assure la tolérance aux nouveaux niveaux de variables dans les données de test
  step_novel(all_nominal_predictors())

## Recette étendue fondée sur base_recipe
extended_recipe <-
  base_recipe |>
  step_pca(all_numeric_predictors())
Créer les modèles
Nous créons trois modèles avec les paramètres suivants :
Régression logistique.
- Hyperparamètres : aucun.
- Méthode : GLM (régression logistique classique)
Random forest.
Hyperparamètres : 2. Nous créons notre grid manuellement avec la fonction
crossing().Méthode : package ranger.
Xtreme gradient boosting.
- Hyperparamètres : 8. Nous créons notre grid avec la fonction
grid_latin_hypercube()., qui, en fonction du nombre de combinaisons autorisées (size=n), optimise le choix des combinaisons examinées. - Méthode : package ranger.
- Hyperparamètres : 8. Nous créons notre grid avec la fonction
## 1. RÉGRESSION LOGISTIQUE =====================================
glm_spec <-
  logistic_reg() %>%
  set_engine('glm') %>%
  set_mode('classification')

## 2. RANDOM FOREST ============================================
rf_spec <- rand_forest(mtry = tune(),
                       trees = tune()) |>
  set_engine("ranger") |>
  set_mode("classification")

## La fonction crossing() permet de créer une grid manuellement.
## Indiquer manuellement les valeurs à tester pour chaque paramètre
rf_grid <- crossing(mtry = c(3, 6, 9),
                    trees=c(100, 200))

## 3. XTREME GRADIENT BOOSTING ================================
## Définir le modèle
xgb_spec <-
  boost_tree(tree_depth = tune(),
             mtry = tune(),
             trees = tune(),
             learn_rate = tune(),
             min_n = tune(),
             loss_reduction = tune(),
             sample_size = tune(),
             stop_iter = tune()) %>%
  set_engine('xgboost') %>%
  set_mode('classification')

## Créer une grid avec grid_latin_hypercube()
xgb_grid <- grid_latin_hypercube(
  trees(),
  min_n(),
  learn_rate(),
  loss_reduction(),
  tree_depth(),
  sample_prop(),
  stop_iter(),
  finalize(mtry(), colon_train),
  size = 10)
Créer le workflow
Nous créons maintenant un ensemble de workflows avec la fonction workflow_set(). Deux listes y sont définies. La première, preproc, contient les recettes. L'argument suivant, models, contient les modèles. L'argument cross est fixé à TRUE, car tous les modèles doivent être testés avec toutes les recettes.
Nous devons ajouter nos grids à notre workflow avec la fonction option_add(). On y précise quelle grid doit être ajoutée à quel workflow. Comme on le voit ci-dessous, le nom de chaque workflow est constitué de son préprocesseur et de son modèle, séparés par un tiret bas (par exemple base_xgb).
my_wf <-
   workflow_set(
      preproc = list(base = base_recipe,
                     extended = extended_recipe),
      models = list(glm = glm_spec,
                    rf = rf_spec,
                    xgb = xgb_spec),
      cross = TRUE
   ) %>%
   # Ajoute une grid search spécifique à un workflow spécifique
   option_add(id = "base_xgb",     grid = xgb_grid) %>%
   option_add(id = "extended_xgb", grid = xgb_grid) %>%
   option_add(id = "base_rf",      grid = rf_grid) %>%
   option_add(id = "extended_rf",  grid = rf_grid)
Exécuter les modèles
Pour exécuter les modèles, nous recourons à la parallélisation, c'est-à-dire que nous exploitons plusieurs cœurs de l'ordinateur lorsque c'est possible. La parallélisation nécessite les packages doParallel et parallel. Le package tictoc sert à mesurer le temps nécessaire à l'exécution de l'ensemble des modèles.
Veillez à ne pas utiliser tous les cœurs de votre ordinateur. Laissez toujours 2 cœurs libres pour les autres processus. Dans l'exemple ci-dessous, l'ordinateur dispose de 8 cœurs ; 6 cœurs sont donc utilisés pour les calculs. Le nombre de cœurs est défini avec la fonction makePSOCKcluster().
library(doParallel)
library(parallel)
library(tictoc)

## Démarrer la parallélisation
mitt_kluster <- makePSOCKcluster(6)
registerDoParallel(mitt_kluster)
tic()

## Exécuter les modèles
my_wf_results <-
   workflow_map(object=my_wf,
                "tune_grid",
                seed = 1,
                resamples = my_cross_validation,
                metrics = yardstick::metric_set(roc_auc),
                verbose = TRUE,
                control   = control_grid(save_pred = TRUE,
                           parallel_over = "everything",
                           save_workflow = TRUE)
                )

## Arrêter la parallélisation
stopCluster(mitt_kluster)
toc()
i No tuning parameters. `fit_resamples()` will be attempted
i 1 of 6 resampling: base_glm
✔ 1 of 6 resampling: base_glm (24.4s)
i 2 of 6 tuning: base_rf
✔ 2 of 6 tuning: base_rf (2m 52.9s)
i 3 of 6 tuning: base_xgb
✔ 3 of 6 tuning: base_xgb (6m 40.6s)
i No tuning parameters. `fit_resamples()` will be attempted
i 4 of 6 resampling: extended_glm
✔ 4 of 6 resampling: extended_glm (11.6s)
i 5 of 6 tuning: extended_rf
✔ 5 of 6 tuning: extended_rf (3m 51.6s)
i 6 of 6 tuning: extended_xgb
✔ 6 of 6 tuning: extended_xgb (17m 25.1s)
1893.746 sec elapsedL'exécution a duré 1893 secondes.
Comparer les modèles
La fonction autoplot() donne un aperçu rapide de la capacité des modèles à prédire le critère de jugement, d'après la mesure de performance choisie (AUC ROC).
autoplot(my_wf_results)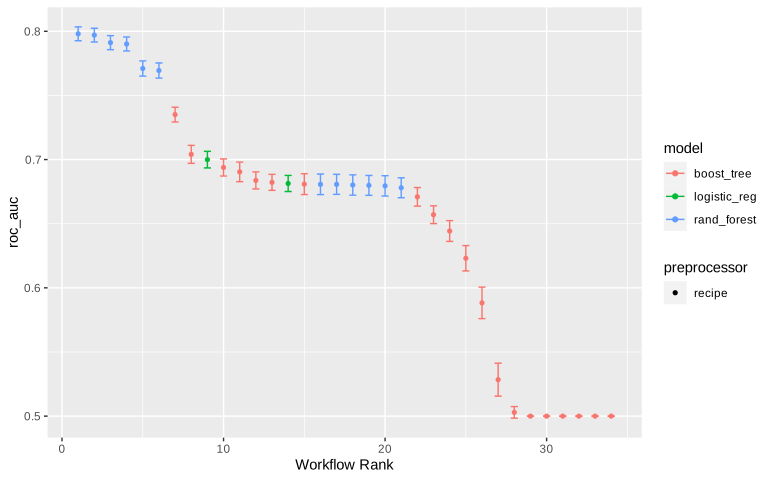
Nous pouvons extraire les meilleurs modèles avec le code suivant
rank_results(my_wf_results,
             rank_metric = "roc_auc",
             select_best = TRUE) %>%
   select(rank, mean, model, wflow_id, .config)
rank mean model wflow_id .config
<int> <dbl> <chr> <chr> <chr>
1 1 0.798 rand_forest base_rf Preprocessor1_Model6
2 2 0.735 boost_tree base_xgb Preprocessor1_Model01
3 3 0.700 logistic_reg base_glm Preprocessor1_Model1
4 4 0.694 boost_tree extended_xgb Preprocessor1_Model02
5 5 0.681 logistic_reg extended_glm Preprocessor1_Model1
6 6 0.681 rand_forest extended_rf Preprocessor1_Model1Le meilleur modèle est la random forest avec la recette de base (base_rf). La meilleure configuration s'appelle Preprocessor1_Model6.
Pour voir de quelle configuration il s'agit, nous écrivons :
best_model <- my_wf_results %>%
  extract_workflow_set_result("base_rf") %>%
  select_best(metric = "roc_auc")

best_model
mtry trees .config
9 200 Preprocessor1_Model6Le modèle a mtry = 9 et trees = 200.
Rappelons que l'entraînement a été réalisé par validation croisée, si bien que le modèle n'a jamais été entraîné sur l'ensemble des données d'entraînement (un fold a servi à tester le modèle, voir Validation croisée). Le meilleur modèle est donc entraîné une dernière fois sur la totalité des données d'entraînement :
my_finalized_wf <-
  my_wf_results |>
  extract_workflow("base_rf") |>
  finalize_workflow(best_model) |>
  last_fit(split = colon_split,
           metrics = yardstick::metric_set(roc_auc))
L'objet my_finalized_wf contient le modèle final. La fonction collect_metrics() permet d'extraire des informations sur la performance du modèle sur les données de test. Notez qu'il n'est pas nécessaire de spécifier les données de test, car tidymodels les utilise automatiquement (l'objet my_finalized_wf y a accès puisque nous avons spécifié split=colon_split ci-dessus).
collect_metrics(my_finalized_wf) .metric .estimator .estimate .config
roc_auc binary 0.792 Preprocessor1_Model1L'aire sous la courbe ROC est de 0,793.
Nous pouvons maintenant examiner les prédictions elles-mêmes à l'aide de la fonction collect_predictions() :
pred_data <- collect_predictions(my_finalized_wf## A tibble: 558 × 6
id .pred_Yes .pred_No .row status .config
<chr> <dbl> <dbl> <int> <fct> <chr>
1 train/test split 0.873 0.127 2 Yes Preprocessor1_Model1
2 train/test split 0.0959 0.904 4 No Preprocessor1_Model1
3 train/test split 0.559 0.441 8 Yes Preprocessor1_Model1
4 train/test split 0.578 0.422 13 Yes Preprocessor1_Model1
5 train/test split 0.560 0.440 14 Yes Preprocessor1_Model1
6 train/test split 0.327 0.673 20 No Preprocessor1_Model1
7 train/test split 0.292 0.708 21 No Preprocessor1_Model1
8 train/test split 0.333 0.667 22 No Preprocessor1_Model1
9 train/test split 0.454 0.546 30 No Preprocessor1_Model1
10 train/test split 0.605 0.395 32 Yes Preprocessor1_Model1La courbe ROC est générée avec le code suivant :
pred_data %>%
  roc_curve(status, .pred_Yes) %>%
  ggplot(aes(x = 1 - specificity, y = sensitivity)) +
  geom_path() +
  geom_abline(lty = 3) +
  coord_equal() +
  theme_bw()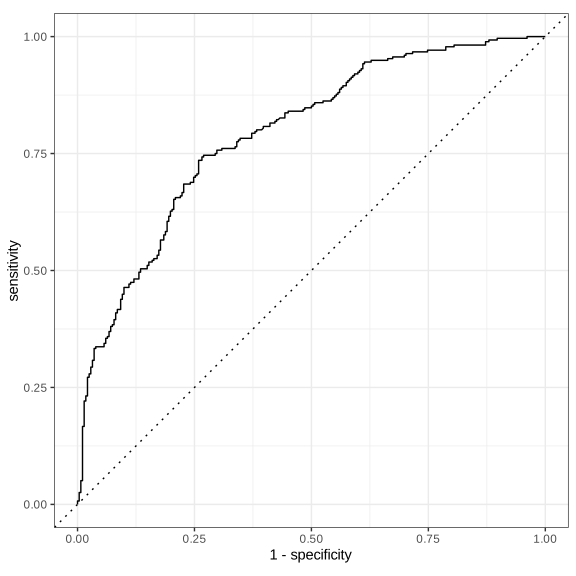
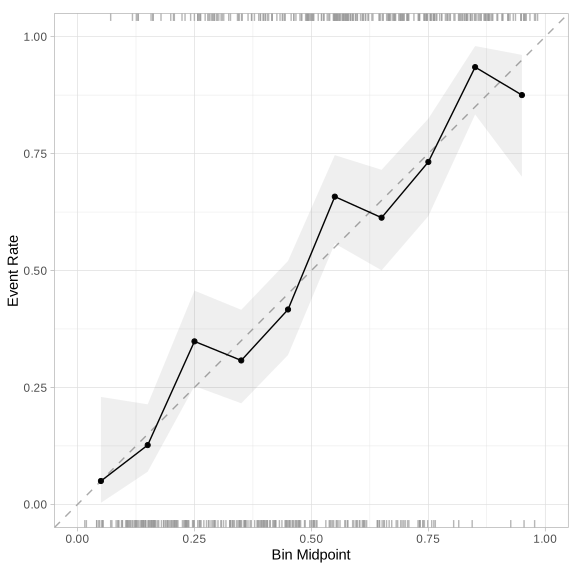
Pour déterminer si le modèle est bien calibré, nous utilisons la fonction cal_plot_breaks() du package probably. Notez que cette fonction nécessite l'installation de la version de développement de probably. Elle s'installe avec la commande suivante :
install.packages("remotes")
remotes::install_github("tidymodels/probably")
library(probably)

pred_data %>%
  cal_plot_breaks(status, .pred_Yes)