
L'apprentissage automatique automatisé (automated machine learning, Auto ML) consiste à laisser l'ordinateur construire un grand nombre de modèles différents et les évaluer à votre place. L'Auto ML peut être réalisé dans Tidymodels grâce aux packages complémentaires agua et h2o. L'Auto ML représente probablement l'avenir de la modélisation prédictive. À mesure que les processeurs (la puissance de calcul) gagnent en performance, l'Auto ML deviendra de plus en plus utile, car la méthode exige de tester un grand nombre de modèles, ce qui est coûteux en temps et en ressources informatiques. Lorsqu'une puissance de calcul importante est disponible et que les bonnes mesures de performance (performance metrics) ont été choisies, l'Auto ML est une méthode très puissante.
Nous commençons cet exemple en installant mlbench afin d'accéder aux données de 768 individus appartenant à la population des Indiens Pima. Nous copions les données dans l'objet pima, puis nous recodons la colonne diabetes en Yes et No au lieu de pos et neg, respectivement.
## Installer et activer mlbench pour
install.packages("mlbench")
library(mlbench)

## Activer les données
data(PimaIndiansDiabetes)

## Copier les données dans l'objet pima
pima <- PimaIndiansDiabetes

## Recoder la variable diabetes en Yes et No au lieu de pos et neg
pima$diabetes = recode_factor(pima$diabetes,
                              'pos'='Yes',
                              'neg'='No')

head(pima)
pregnant glucose pressure triceps insulin mass pedigree age diabetes
1 6 148 72 35 0 33.6 0.627 50 Yes
2 1 85 66 29 0 26.6 0.351 31 No
3 8 183 64 0 0 23.3 0.672 32 Yes
4 1 89 66 23 94 28.1 0.167 21 No
5 0 137 40 35 168 43.1 2.288 33 Yes
6 5 116 74 0 0 25.6 0.201 30 NoNous utilisons ensuite la fonction initial_split() pour créer des données d'entraînement et des données de test. Nous indiquons prop=0.7 afin que 70 % des données servent à l'entraînement. Les fonctions training() et testing() permettent ensuite d'extraire les données d'entraînement et les données de test dans des fichiers distincts. Notez l'argument strata=diabetes, qui signifie que la partition est stratifiée sur la colonne diabetes : la proportion de Yes et de No est ainsi identique dans les données d'entraînement et dans les données de test. C'est souhaitable, afin que la proportion de personnes atteintes de diabète soit la même dans les données d'entraînement et dans les données de test.
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test <- testing(pima_split)
À l'étape suivante, nous installons les packages agua et h2o. Le package agua assure la communication entre Tidymodels et h2o. Les calculs sont effectués dans h2o, qui doit être démarré à l'aide de la fonction h2o_start() :
## Installer les packages
install.packages("agua")
install.packages("h2o")

## Activer les packages
library(agua)
library(h2o)

## Démarrer un serveur h2o
h2o_start()
Nous spécifions ensuite un modèle avec la fonction auto_ml(), en utilisant la méthode h2o. Nous indiquons également max_runtime_secs=300, ce qui signifie que nous sommes prêts à attendre 200 secondes pour construire et comparer les modèles (dans des situations réelles, ce paramètre peut être porté à un ou plusieurs jours).
Pour utiliser h2o, une instance h2o doit être démarrée, ce qui se fait avec la fonction h2o_start(). Cela lance une instance h2o sur l'ordinateur et doit être fait à chaque démarrage de R. h2o utilisera tous les cœurs de votre ordinateur (h2o parallélise automatiquement tous les calculs). Si vous souhaitez limiter le nombre de cœurs, utilisez l'argument nthreads. Le serveur h2o est arrêté lorsque vous quittez R. Pour arrêter h2o manuellement, utilisez la fonction h2o_end().
## Spécifier le modèle et la durée d'attente acceptée
h2o_mod <-
  auto_ml() |>
  set_engine("h2o",
             max_runtime_secs=200,
             exclude_algos = c("StackedEnsemble")) |>
  set_mode("classification") |>
  fit(diabetes ~ ., data = pima_train)
H2o exige que les variables catégorielles (character, factor) soient converties en variables numériques. parsnip s'en charge automatiquement si nous utilisons fit() pour créer le modèle (voir ci-dessus). Notez également que nous avons indiqué que les modèles de type StackedEnsemble ne doivent pas être créés.
Les autres arguments importants de set_engine() sont les suivants :
max_modelsindique le nombre maximal de modèles testés.exclude_algosetinclude_algosindiquent les types de modèles à inclure ou à exclure. Les modèles suivants sont disponibles :DRF(comprend à la fois les modèles Random Forest et Extremely Randomized Trees (XRT))GLMXGBoost(XGBoost GBM)GBM(H2O GBM)DeepLearning(réseau de neurones artificiels multicouche entièrement connecté)StackedEnsemble, qui est une fusion des algorithmes d'ensemble ci-dessus.
validation: un entier compris entre 0 et 1 qui indique la proportion des données d'entraînement à utiliser comme données de validation. h2o s'en sert pour évaluer la précision des modèles et interrompre la construction des modèles peu performants.
Le résultat est enregistré dans l'objet h2o_mod. Plusieurs fonctions peuvent être appliquées à cet objet ; elles sont illustrées ci-dessous.
La fonction rank_results() classe la performance de chaque modèle (par validation croisée) pour chaque mesure. Plus le rang est faible, meilleur est le modèle : le rang 1 désigne le meilleur modèle. Ci-dessous, nous extrayons le classement de tous les modèles selon l'AUC.
rank_results(h2o_mod) |>
  filter(.metric=="auc") |>
  arrange(rank)
## A tibble: 48 × 5
id algorithm .metric mean rank
<chr> <chr> <chr> <dbl> <int>
1 GBM_4_AutoML_1_20221226_215511 gradient boosting auc 0.831 1
2 GBM_grid_1_AutoML_1_20221226_215511_model_4 gradient boosting auc 0.827 2
3 GLM_1_AutoML_1_20221226_215511 glm auc 0.827 3
4 XGBoost_grid_1_AutoML_1_20221226_215511_model_9 xgboost auc 0.826 4
5 GBM_grid_1_AutoML_1_20221226_215511_model_3 gradient boosting auc 0.825 5
6 XGBoost_grid_1_AutoML_1_20221226_215511_model_5 xgboost auc 0.825 6
7 XGBoost_grid_1_AutoML_1_20221226_215511_model_2 xgboost auc 0.824 7
8 XGBoost_grid_1_AutoML_1_20221226_215511_model_4 xgboost auc 0.823 8
9 DeepLearning_grid_1_AutoML_1_20221226_215511_model_1 neural nets auc 0.823 9
10 GBM_5_AutoML_1_20221226_215511 gradient boosting auc 0.822 10
11 XGBoost_grid_1_AutoML_1_20221226_215511_model_3 xgboost auc 0.821 11
12 XGBoost_grid_1_AutoML_1_20221226_215511_model_1 xgboost auc 0.820 12
13 GBM_grid_1_AutoML_1_20221226_215511_model_13 gradient boosting auc 0.820 13
14 GBM_grid_1_AutoML_1_20221226_215511_model_6 gradient boosting auc 0.819 14
15 DeepLearning_grid_1_AutoML_1_20221226_215511_model_7 neural nets auc 0.819 15
16 DeepLearning_grid_1_AutoML_1_20221226_215511_model_10 neural nets auc 0.818 16
17 GBM_1_AutoML_1_20221226_215511 gradient boosting auc 0.818 17
18 XGBoost_grid_1_AutoML_1_20221226_215511_model_10 xgboost auc 0.817 18
19 DRF_1_AutoML_1_20221226_215511 random forests auc 0.817 19
20 XGBoost_grid_1_AutoML_1_20221226_215511_model_7 xgboost auc 0.815 20
21 GBM_grid_1_AutoML_1_20221226_215511_model_2 gradient boosting auc 0.815 21
22 XRT_1_AutoML_1_20221226_215511 random forests auc 0.815 22
23 GBM_grid_1_AutoML_1_20221226_215511_model_11 gradient boosting auc 0.815 23
24 GBM_grid_1_AutoML_1_20221226_215511_model_9 gradient boosting auc 0.813 24
25 XGBoost_grid_1_AutoML_1_20221226_215511_model_12 xgboost auc 0.813 25
26 XGBoost_grid_1_AutoML_1_20221226_215511_model_13 xgboost auc 0.812 26
27 XGBoost_2_AutoML_1_20221226_215511 xgboost auc 0.812 27
28 XGBoost_1_AutoML_1_20221226_215511 xgboost auc 0.811 28
29 DeepLearning_grid_1_AutoML_1_20221226_215511_model_2 neural nets auc 0.811 29
30 GBM_3_AutoML_1_20221226_215511 gradient boosting auc 0.811 30
31 GBM_grid_1_AutoML_1_20221226_215511_model_10 gradient boosting auc 0.810 31
32 XGBoost_grid_1_AutoML_1_20221226_215511_model_6 xgboost auc 0.809 32
33 GBM_grid_1_AutoML_1_20221226_215511_model_12 gradient boosting auc 0.809 33
34 DeepLearning_grid_1_AutoML_1_20221226_215511_model_5 neural nets auc 0.808 34
35 GBM_grid_1_AutoML_1_20221226_215511_model_5 gradient boosting auc 0.806 35
36 XGBoost_grid_1_AutoML_1_20221226_215511_model_11 xgboost auc 0.806 36
37 GBM_2_AutoML_1_20221226_215511 gradient boosting auc 0.806 37
38 XGBoost_grid_1_AutoML_1_20221226_215511_model_8 xgboost auc 0.805 38
39 GBM_grid_1_AutoML_1_20221226_215511_model_1 gradient boosting auc 0.804 39
40 DeepLearning_grid_1_AutoML_1_20221226_215511_model_9 neural nets auc 0.802 40
41 GBM_grid_1_AutoML_1_20221226_215511_model_8 gradient boosting auc 0.797 41
42 XGBoost_3_AutoML_1_20221226_215511 xgboost auc 0.797 42
43 GBM_grid_1_AutoML_1_20221226_215511_model_7 gradient boosting auc 0.796 43
44 DeepLearning_grid_1_AutoML_1_20221226_215511_model_6 neural nets auc 0.792 44
45 DeepLearning_grid_1_AutoML_1_20221226_215511_model_4 neural nets auc 0.785 45
46 DeepLearning_1_AutoML_1_20221226_215511 neural nets auc 0.779 46
47 DeepLearning_grid_1_AutoML_1_20221226_215511_model_8 neural nets auc 0.777 47
48 DeepLearning_grid_1_AutoML_1_20221226_215511_model_3 neural nets auc 0.714 48D'après ce qui précède, 48 modèles ont été créés en 300 secondes. Le meilleur modèle a une ROC AUC de 0,831 et s'appelle GBM_4_AutoML_1_20221226_215511.
La fonction collect_metrics() calcule la valeur moyenne de chaque mesure de performance pour chaque modèle.
collect_metrics(h2o_mod, summarize = T) id algorithm .metric mean std_err n
1 GBM_4_AutoML_1_20221226_215511 gradient boosting accuracy 0.775 0.0186 5
2 GBM_4_AutoML_1_20221226_215511 gradient boosting auc 0.831 0.0132 5
3 GBM_4_AutoML_1_20221226_215511 gradient boosting err 0.225 0.0186 5
4 GBM_4_AutoML_1_20221226_215511 gradient boosting err_count 24.2 1.96 5
5 GBM_4_AutoML_1_20221226_215511 gradient boosting f0point5 0.677 0.0266 5
6 GBM_4_AutoML_1_20221226_215511 gradient boosting f1 0.698 0.0151 5
7 GBM_4_AutoML_1_20221226_215511 gradient boosting f2 0.724 0.00764 5
8 GBM_4_AutoML_1_20221226_215511 gradient boosting lift_top_group 2.29 0.346 5
9 GBM_4_AutoML_1_20221226_215511 gradient boosting logloss 0.480 0.0178 5
10 GBM_4_AutoML_1_20221226_215511 gradient boosting max_per_class_error 0.279 0.0127 5
## … with 952 more rowsLa fonction tidy() calcule la performance moyenne de chaque modèle. Cet objet est utile si l'objectif est de prédire à l'aide de chacun des modèles.
tidy(h2o_mod) id algorithm .metric .model
1 GBM_4_AutoML_1_20221226_215511 gradient boosting <tibble [6 × 2]> <fit[+]>
2 GBM_grid_1_AutoML_1_20221226_215511_model_3 gradient boosting <tibble [6 × 2]> <fit[+]>
3 GLM_1_AutoML_1_20221226_215511 glm <tibble [6 × 2]> <fit[+]>
4 GBM_grid_1_AutoML_1_20221226_215511_model_4 gradient boosting <tibble [6 × 2]> <fit[+]>
5 XGBoost_grid_1_AutoML_1_20221226_215511_model_9 xgboost <tibble [6 × 2]> <fit[+]>
6 GBM_grid_1_AutoML_1_20221226_215511_model_13 gradient boosting <tibble [6 × 2]> <fit[+]>
7 GBM_5_AutoML_1_20221226_215511 gradient boosting <tibble [6 × 2]> <fit[+]>
8 XGBoost_grid_1_AutoML_1_20221226_215511_model_2 xgboost <tibble [6 × 2]> <fit[+]>
9 DeepLearning_grid_1_AutoML_1_20221226_215511_model_1 neural nets <tibble [6 × 2]> <fit[+]>
10 XGBoost_grid_1_AutoML_1_20221226_215511_model_5 xgboost <tibble [6 × 2]> <fit[+]>
## … with 38 more rowsPour prédire avec chacun des modèles sur les 10 premières personnes de pima_test, on utilise le code ci-dessous. Notez que la fonction slice(pima_test, 1:10) extrait les 10 premiers individus.
tidy(h2o_mod) %>%
  mutate(.predictions = map(.model, predict, new_data = slice(pima_test, 1:10)))
La fonction extract_fit_engine() extrait un seul modèle de l'objet. Si l'argument id n'est pas indiqué, c'est le meilleur modèle (« leader model ») qui est extrait. Les id des modèles figurent dans la colonne id des résultats (voir par exemple la sortie de rank_results()).
extract_fit_engine(h2o_mod)Model Details:
==============
H2OBinomialModel: gbm
Model ID: GBM_4_AutoML_1_20221226_215511
Model Summary:
number_of_trees number_of_internal_trees model_size_in_bytes min_depth max_depth mean_depth min_leaves max_leaves
1 29 29 13560 8 10 9.31034 27 35
mean_leaves
1 32.37931
H2OBinomialMetrics: gbm
** Reported on training data. **
MSE: 0.05725762
RMSE: 0.2392857
LogLoss: 0.2300623
Mean Per-Class Error: 0.0376547
AUC: 0.9922995
AUCPR: 0.9856815
Gini: 0.9845989
R^2: 0.7477261
Confusion Matrix (vertical: actual; across: predicted) for F1-optimal threshold:
No Yes Error Rate
No 333 17 0.048571 =17/350
Yes 5 182 0.026738 =5/187
Totals 338 199 0.040968 =22/537
Maximum Metrics: Maximum metrics at their respective thresholds
metric threshold value idx
1 max f1 0.392466 0.943005 180
2 max f2 0.377527 0.962145 183
3 max f0point5 0.555395 0.947368 151
4 max accuracy 0.439211 0.959032 175
5 max precision 0.948979 1.000000 0
6 max recall 0.259765 1.000000 220
7 max specificity 0.948979 1.000000 0
8 max absolute_mcc 0.392466 0.912150 180
9 max min_per_class_accuracy 0.439211 0.957219 175
10 max mean_per_class_accuracy 0.392466 0.962345 180
11 max tns 0.948979 350.000000 0
12 max fns 0.948979 186.000000 0
13 max fps 0.019980 350.000000 399
14 max tps 0.259765 187.000000 220
15 max tnr 0.948979 1.000000 0
16 max fnr 0.948979 0.994652 0
17 max fpr 0.019980 1.000000 399
18 max tpr 0.259765 1.000000 220
Gains/Lift Table: Extract with `h2o.gainsLift(<model>, <data>)` or `h2o.gainsLift(<model>, valid=<T/F>, xval=<T/F>)`
H2OBinomialMetrics: gbm
** Reported on cross-validation data. **
** 5-fold cross-validation on training data (Metrics computed for combined holdout predictions) **
MSE: 0.1568414
RMSE: 0.396032
LogLoss: 0.474387
Mean Per-Class Error: 0.2495187
AUC: 0.8318411
AUCPR: 0.7182069
Gini: 0.6636822
R^2: 0.3089657
Confusion Matrix (vertical: actual; across: predicted) for F1-optimal threshold:
No Yes Error Rate
No 224 126 0.360000 =126/350
Yes 26 161 0.139037 =26/187
Totals 250 287 0.283054 =152/537
Maximum Metrics: Maximum metrics at their respective thresholds
metric threshold value idx
1 max f1 0.243135 0.679325 240
2 max f2 0.096600 0.802792 323
3 max f0point5 0.568206 0.705968 105
4 max accuracy 0.568206 0.780261 105
5 max precision 0.956189 1.000000 0
6 max recall 0.028299 1.000000 389
7 max specificity 0.956189 1.000000 0
8 max absolute_mcc 0.491770 0.501248 130
9 max min_per_class_accuracy 0.352644 0.727273 189
10 max mean_per_class_accuracy 0.243135 0.750481 240
11 max tns 0.956189 350.000000 0
12 max fns 0.956189 186.000000 0
13 max fps 0.016039 350.000000 399
14 max tps 0.028299 187.000000 389
15 max tnr 0.956189 1.000000 0
16 max fnr 0.956189 0.994652 0
17 max fpr 0.016039 1.000000 399
18 max tpr 0.028299 1.000000 389
Gains/Lift Table: Extract with `h2o.gainsLift(<model>, <data>)` or `h2o.gainsLift(<model>, valid=<T/F>, xval=<T/F>)`
Cross-Validation Metrics Summary:
mean sd cv_1_valid cv_2_valid cv_3_valid cv_4_valid cv_5_valid
accuracy 0.774559 0.041612 0.796296 0.814815 0.794392 0.757009 0.710280
auc 0.831481 0.029510 0.852256 0.852256 0.847876 0.820849 0.784170
err 0.225441 0.041612 0.203704 0.185185 0.205607 0.242991 0.289720
err_count 24.200000 4.381781 22.000000 20.000000 22.000000 26.000000 31.000000
f0point5 0.676793 0.059588 0.710526 0.741758 0.696517 0.644444 0.590717
f1 0.698472 0.033793 0.710526 0.729730 0.717949 0.690476 0.643678
f2 0.724003 0.017082 0.710526 0.718085 0.740741 0.743590 0.707071
lift_top_group 2.293599 0.774065 2.842105 2.842105 1.445946 2.891892 1.445946
logloss 0.479799 0.039779 0.439568 0.452327 0.474039 0.491787 0.541276
max_per_class_error 0.278724 0.028374 0.289474 0.289474 0.243243 0.257143 0.314286
mcc 0.525621 0.065505 0.553383 0.589539 0.558669 0.504708 0.421806
mean_per_class_accuracy 0.767549 0.027921 0.776692 0.790977 0.785521 0.763320 0.721236
mean_per_class_error 0.232451 0.027921 0.223308 0.209023 0.214479 0.236680 0.278765
mse 0.157833 0.015036 0.144910 0.144622 0.153228 0.167321 0.179083
pr_auc 0.713002 0.081285 0.787191 0.812500 0.665643 0.669870 0.629805
precision 0.664095 0.075733 0.710526 0.750000 0.682927 0.617021 0.560000
r2 0.304361 0.068720 0.364576 0.365836 0.322660 0.260363 0.208372
recall 0.743670 0.032205 0.710526 0.710526 0.756757 0.783784 0.756757
rmse 0.396927 0.018757 0.380670 0.380292 0.391444 0.409049 0.423182
specificity 0.791429 0.075997 0.842857 0.871429 0.814286 0.742857 0.685714Dans l'exemple ci-dessus, aucun modèle de type StackedEnsemble n'a été créé. Si c'est le cas, la fonction member_weights() permet de déterminer quel modèle pèse le plus dans l'ensemble. Cela n'est pas illustré ici.
Nous poursuivons en effectuant une prédiction avec notre meilleur modèle. Comme d'habitude, cela se fait avec la fonction predict(). Parsnip utilisera automatiquement le meilleur modèle pour la prédiction. Nous envoyons le résultat de la prédiction dans pima_test, où nous créons la colonne predicted. Comme d'habitude, celle-ci est composée de deux colonnes imbriquées (regroupées), ce que nous corrigeons à l'aide de la fonction unnest().
pima_test$predicted <- predict(h2o_mod, new_data = pima_test, type="prob")

## Nous désimbriquons la colonne predicted en deux colonnes distinctes
pima_test <- unnest(pima_test, predicted)

head(pima_test)
pregnant glucose pressure triceps insulin mass pedigree age diabetes .pred_No .pred_Yes
1 3 78 50 32 88 31 0.248 26 Yes 0.937 0.0632
2 10 115 0 0 0 35.3 0.134 29 No 0.306 0.694
3 10 168 74 0 0 38 0.537 34 Yes 0.0737 0.926
4 10 139 80 0 0 27.1 1.44 57 No 0.839 0.161
5 5 166 72 19 175 25.8 0.587 51 Yes 0.401 0.599
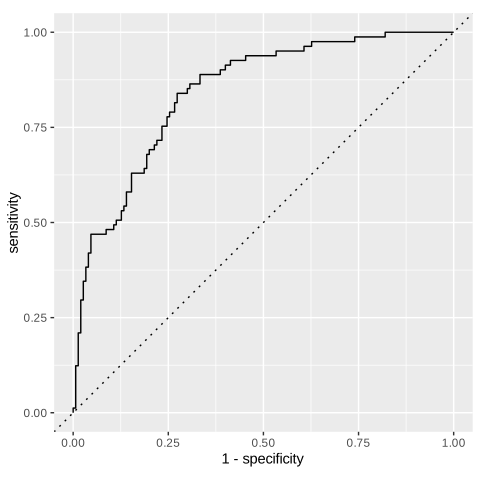
6 0 118 84 47 230 45.8 0.551 31 Yes 0.517 0.483## ROC AUC
resultat %>%
roc_auc(diabetes, .pred_Yes)
## Courbe ROC
resultat |>
roc_curve(diabetes, .pred_Yes) |>
ggplot(aes(x = 1 - specificity, y = sensitivity)) +
geom_path() +
geom_abline(lty = 3) +
coord_equal()AUC : 0,834
Auto ML avec une recette
Nous refaisons maintenant les modèles avec une recette (recipe). Une recette permet d'introduire un prétraitement (pre-processing) à l'aide des fonctions step. Il existe un grand nombre de fonctions step (voir la documentation ici) qui facilitent le prétraitement. Voici quelques exemples de fonctions step :
[step_impute_bag()](https://recipes.tidymodels.org/reference/step_impute_bag.html)impute les données manquantes à l'aide d'arbres ensachés (bagged trees).- step_BoxCox() transforme les données par une transformation de Box-Cox.
- step_mutate() crée de nouvelles variables avec la syntaxe dplyr.
- step_dummy() convertit les variables catégorielles en variables indicatrices (dummy variables).
[step_center()](https://recipes.tidymodels.org/reference/step_center.html)centre les variables numériques.[step_normalize()](https://recipes.tidymodels.org/reference/step_normalize.html)centre et réduit les variables numériques.[step_nzv()](https://recipes.tidymodels.org/reference/step_nzv.html)supprime les variables de variance quasi nulle (near zero variance).[step_rm()](https://recipes.tidymodels.org/reference/step_rm.html)supprime les variables sélectionnées.[step_select()](https://recipes.tidymodels.org/reference/step_select.html)sélectionne des variables avec la syntaxe dplyr.[step_zv()](https://recipes.tidymodels.org/reference/step_zv.html)supprime les variables de variance nulle (zero variance).
Il existe bien d'autres fonctions step.
Nous démarrons d'abord h2o, puis nous créons les données d'entraînement et les données de test :
## Activer h2o
h2o_start()

## Partitionner les données en données d'entraînement et données de test
## Nous fixons une graine (seed) pour obtenir les mêmes données de test et d'entraînement à chaque fois
set.seed(1)
pima_split <- initial_split(pima, strata=diabetes, prop=0.7)
pima_train <- training(pima_split)
pima_test <- testing(pima_split)
À l'étape suivante, nous spécifions qu'un modèle de classification doit être créé avec h2o. La durée totale de construction des modèles ne doit pas dépasser 600 secondes. L'argument seed = 1 permet d'obtenir les mêmes résultats à chaque création des modèles (ce qui est souhaitable lorsque les résultats doivent pouvoir être reproduits à l'identique).
## run for a maximum of 120 seconds
my_auto_ml_model <-
  auto_ml() %>%
  set_engine("h2o", max_runtime_secs = 60*10, seed = 1) %>%
  set_mode("classification")
Nous créons ensuite une recette dans laquelle nous indiquons la formule et au moins une fonction step.
## Nous créons maintenant une recette dans laquelle les variables continues sont normalisées
my_recipe <-
  recipe(diabetes ~ ., data = pima_train) %>%
  step_normalize(all_predictors())
À l'étape suivante, nous créons un workflow (flux de travail). Il est nécessaire parce que nous avons une recette : pour combiner une recette et un modèle, il faut un workflow, comme suit :
## Comme nous avons créé une recette, un workflow (flux de travail) est nécessaire
my_workflow <-
  workflow() %>%
  add_model(my_auto_ml_model) %>%
  add_recipe(my_recipe)
À la dernière étape, les modèles sont créés à l'aide de la commande suivante :
## Lorsque nous utilisons fit(), les modèles sont exécutés
my_fit <- fit(my_workflow,
              data = pima_train)
Le résultat est obtenu avec la commande suivante :
extract_fit_parsnip(my_fit)parsnip model object
═════════════════════════════════ H2O AutoML Summary: 77 models ═════════════════════════════════
Leader Algorithm: stackedensemble
Leader ID: StackedEnsemble_BestOfFamily_6_AutoML_2_20221226_230058
═════════════════════════════════ Leaderboard ═════════════════════════════════
model_id auc logloss aucpr mean_per_class_error
1 StackedEnsemble_BestOfFamily_6_AutoML_2_20221226_230058 0.8504125 0.4579039 0.7076490 0.2135829
2 StackedEnsemble_BestOfFamily_7_AutoML_2_20221226_230058 0.8499847 0.4598350 0.7029424 0.2158900
3 StackedEnsemble_BestOfFamily_1_AutoML_2_20221226_230058 0.8496791 0.4587145 0.6915028 0.2157830
4 GBM_grid_1_AutoML_2_20221226_230058_model_4 0.8495875 0.4573177 0.7095222 0.2173950
5 StackedEnsemble_BestOfFamily_4_AutoML_2_20221226_230058 0.8492284 0.4587871 0.7102592 0.2176471
6 StackedEnsemble_AllModels_1_AutoML_2_20221226_230058 0.8488694 0.4601824 0.6896033 0.2151948Au total, 77 modèles ont été créés ; le meilleur a pour id StackedEnsemble_BestOfFamily_6_AutoML_2_20221226_230058, avec une AUC de 0,850 (non évaluée sur les données de test).
À l'heure actuelle, l'Auto ML sert à obtenir une indication des modèles qui conviennent bien à une tâche donnée. L'Auto ML ne garantit pas l'obtention du meilleur modèle. Un réglage manuel minutieux des hyperparamètres (hyperparameter tuning, optimisation des hyperparamètres) permet le plus souvent de construire des modèles meilleurs que ceux créés par Auto ML.