
Sélection de variables : inclure les bonnes variables
L'objectif d'un modèle de prédiction peut être soit (1) d'estimer l'effet (l'association) entre un ou plusieurs prédicteurs () et le critère de jugement , soit (2) de construire un modèle doté d'une capacité prédictive maximale. Dans le premier cas, c'est-à-dire lorsque l'objectif est d'estimer les effets des prédicteurs, le résultat final est bien entendu un modèle de prédiction, mais celui-ci n'a probablement pas une capacité prédictive maximale. Pour estimer des effets, un modèle n'a pas besoin d'une capacité prédictive maximale ; l'accent doit plutôt être mis sur l'obtention de résultats faciles à interpréter et fiables. Dans ce cas, la sélection des variables peut se fonder sur la connaissance du domaine. Grâce à l'expertise du domaine, on peut construire un modèle qui inclut les covariables nécessaires et spécifier le modèle de manière judicieuse. Autrement dit, la sélection des variables peut reposer sur l'expertise du domaine lorsque l'objectif du modèle est l'estimation d'effets. Dans le second cas, c'est-à-dire lorsque l'objectif est une capacité prédictive maximale, la sélection des variables est un peu plus complexe, et ce chapitre porte principalement sur ce type de modèles.
Les modèles de prédiction doivent présenter une capacité prédictive élevée tout en restant économes quant au nombre de variables nécessaires. Le terme anglais désignant un modèle économe (en nombre de prédicteurs) est the parsimonious model (modèle parcimonieux). Plus un modèle contient de prédicteurs, plus il est difficile à utiliser par d'autres, en particulier s'il comprend des prédicteurs difficiles à obtenir. En outre, un surajustement (overfitting) peut survenir si les prédicteurs sont trop nombreux.
La sélection de variables (angl. variable selection, feature selection) consiste à éliminer de manière méthodique les variables superflues. On part d'un nombre plus important de variables, appelées variables candidates (angl. candidate predictors), que l'on élimine progressivement jusqu'à ce que seules les plus importantes subsistent. Il existe plusieurs méthodes de sélection de variables, présentées ci-dessous.
Sélection de variables pas à pas : backward & forward stepwise selection
La sélection de variables pas à pas (stepwise) est un processus automatisé dans lequel le logiciel décide quelles variables doivent figurer dans un modèle de régression. Elle peut se faire soit par forward stepwise selection (sélection ascendante), soit par backward stepwise selection (sélection descendante).
- Forward stepwise selection : le modèle part de 0 (zéro) variable, puis on ajoute une variable à la fois. La variable ajoutée est conservée dans le modèle si elle conduit à un meilleur modèle.
- Backward stepwise selection : toutes les variables candidates figurent dans le modèle dès le départ. On élimine ensuite une variable à la fois. La variable dont l'élimination affecte le moins le modèle est exclue (puisque son élimination a le moins d'influence sur le modèle). On répète l'opération jusqu'à ce qu'aucune variable ne puisse plus être éliminée sans que le modèle devienne significativement moins bon.
- Bidirectional stepwise elimination (élimination pas à pas bidirectionnelle) est une combinaison des deux approches ci-dessus.
Pour juger si le modèle s'améliore ou se dégrade, il faut recourir à un critère. Dans la plupart des cas, on utilise le critère d'information d'Akaike (AIC, Akaike information criterion). L'AIC mesure l'équilibre entre la complexité du modèle (nombre de prédicteurs) et la qualité d'ajustement (goodness-of-fit, capacité prédictive). Plus l'AIC est faible, meilleur est le modèle.
Ces méthodes ne devraient en principe jamais être utilisées. Elles contreviennent en effet à plusieurs principes de l'inférence statistique. Les conséquences de la sélection pas à pas sont les suivantes (Harrell) :
- Les valeurs de R2 sont biaisées (trop élevées).
- La sélection des variables elle-même repose sur des valeurs de P (tests de significativité), ce qui exige en réalité une hypothèse prédéfinie.
- L'erreur standard (SE) est biaisée (trop petite).
- Les intervalles de confiance sont biaisés (trop étroits).
- Les valeurs de P sont faussement petites et il se pose un problème de tests multiples.
- Les coefficients de régression sont biaisés (les coefficients, et donc l'effet, sont faussement élevés).
Nous allons malgré tout montrer comment réaliser une sélection de variables pas à pas dans R. Commencez par installer le package olsrr puis chargez-le. Dans l'exemple ci-dessous, nous construisons un modèle linéaire avec les données mpg. Nous prédisons hwy en spécifiant hwy ~., où . signifie « toutes les variables » de mpg. Vous pouvez ensuite utiliser la fonction tidy() du package broom pour afficher le résultat. On utilise ensuite ols_step_forward_aic() pour effectuer la forward stepwise selection. Le résultat est ensuite représenté graphiquement. Nous affichons également les résultats afin d'obtenir les informations sur le . La fonction correspondante pour la backward stepwise selection est ols_step_backward_aic().
library(olsrr)
library(broom)
library(tidyverse)

## Crée le modèle
model <- lm(hwy ~., data = mpg)

## Afficher les résultats du modèle avant la forward stepwise selection
tidy(model)

## Forward stepwise selection
forward<-ols_step_forward_aic(model)

plot(forward) + theme_bw()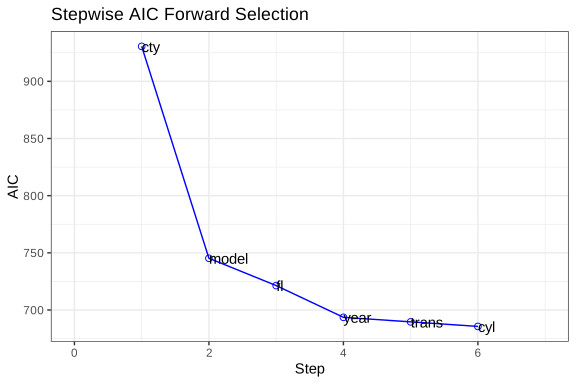
print(forward) Selection Summary
-------------------------------------------------------------------
Variable AIC Sum Sq RSS R-Sq Adj. R-Sq
-------------------------------------------------------------------
cty 930.567 7549.302 712.360 0.91378 0.91340
model 745.249 8026.474 235.189 0.97153 0.96598
fl 721.367 8056.430 205.232 0.97516 0.96970
year 693.609 8080.938 180.724 0.97812 0.97317
trans 689.636 8097.136 164.526 0.98009 0.97436
cyl 685.650 8101.292 160.370 0.98059 0.97487
-------------------------------------------------------------------Sélection univariée (univariate screening)
De nombreux chercheurs recourent à la sélection univariée pour décider quelles variables doivent entrer dans le modèle. On teste alors une variable à la fois et, si elle est statistiquement significative, elle est incluse dans le modèle final. Cette approche est elle aussi erronée, car la sélection des variables ne doit pas reposer sur des valeurs de P. En outre, elle peut conduire à exclure des variables qui ne sont significatives qu'en présence d'autres variables. On risque ainsi de perdre des prédicteurs importants avec cette méthode.
LASSO (least absolute shrinkage and selection operator)
Le LASSO est un modèle de régression qui peut servir à sélectionner des variables. Le LASSO fonctionne en calculant le paramètre , qui pénalise les modèles plus complexes, ce qui permet d'exclure des variables.
Dans R, on utilise le package glmnet() pour réaliser un LASSO. Ce package n'accepte pas de data frame : il exige que le critère de jugement et les prédicteurs soient spécifiés dans deux matrices distinctes (voir ci-dessous). Toutes les variables de type character doivent être converties en factor. Il faut ensuite appliquer un one-hot encoding aux facteurs, ce qui signifie qu'un facteur à 4 niveaux est converti en 4 variables binaires distinctes (une pour chaque niveau de la variable d'origine). Suivez les commentaires du code ci-dessous pour comprendre les différentes étapes.
## Charger mltools pour avoir accès à la fonction one_hot()
library(mltools)
## Charger data.table pour avoir accès à la fonction as.data.table()
library(data.table)
## Charger glmnet qui contient lasso()
library(glmnet)

## Convertit toutes les variables character en factor
mpg <- mpg %>% mutate_if(is.character, as.factor)

## One-hot encoding
mpg <- one_hot(as.data.table(mpg))

## Tous les prédicteurs sont placés dans une matrice
x <- as.matrix(select(mpg, -hwy))

## Le critère de jugement est placé dans une autre matrice
y <- as.matrix(select(mpg, hwy))

my_lasso <- glmnet(x,y)
print(my_lasso)
Le résultat est le suivant (tronqué). DF (degrees of freedom) correspond au nombre de degrés de liberté, c'est-à-dire au nombre de prédicteurs. %Dev est comparable au R2 (c'est-à-dire une mesure de la capacité prédictive).
Call:  glmnet(x = x, y = y)

   Df  %Dev Lambda
1   0  0.00 5.6800
2   1 15.51 5.1750
3   1 28.39 4.7160
4   1 39.09 4.2970
5   1 47.97 3.9150
6   1 55.34 3.5670
7   1 61.46 3.2500
..................
80 63 98.07 0.0037
81 63 98.07 0.0033
82 63 98.07 0.0030
83 63 98.07 0.0028
84 63 98.07 0.0025
85 64 98.07 0.0023
Pour un donné, on peut voir quelles variables figurent dans le modèle avec la commande suivante :
coef(my_lasso, 1)83 x 1 sparse Matrix of class "dgCMatrix"
s1
(Intercept) 6.1476740
drv_4 -0.8684261
cty 1.0483884On peut représenter graphiquement les prédicteurs du meilleur modèle avec la fonction plot_glmnet() du package plotmo. Si vous n'avez pas plotmo, vous devez d'abord l'installer (install.packages("plotmo")). Ci-dessous, nous représentons les 5 meilleurs prédicteurs.
library(plotmo)
plot_glmnet(my_lasso, label=5)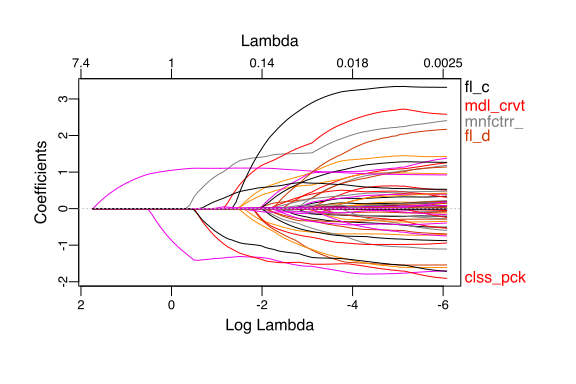
Le LASSO devrait en réalité être réalisé avec une validation croisée (cross validation). Pour répéter le processus avec une validation croisée à 5 blocs (folds), on utilise la commande suivante :
cv_lasso_fit <- cv.glmnet(x = x, y = y,
                          alpha = 1,
                          nfolds = 5)
On peut représenter graphiquement le résultat du LASSO comme suit :
plot(cv_lasso_fit)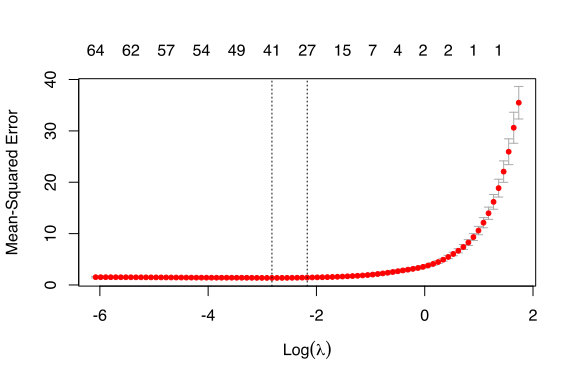
Le graphique ci-dessus montre le MSE (erreur quadratique moyenne) en ordonnée et log() en abscisse, avec un intervalle de confiance pour chaque modèle. Il comporte deux lignes verticales (pointillées). La ligne de gauche indique l'emplacement du MSE le plus faible. La ligne de droite se situe 1 erreur standard plus haut (en MSE) et indique le lambda d'un modèle plus régularisé. Un modèle régularisé présente moins de surajustement et prédit mieux sur les données de test.
On peut extraire le du modèle ayant le MSE le plus faible avec la commande suivante :
cv_lasso_fit$lambda.min[1] 0.0213847On peut extraire le lambda du modèle dont le MSE est supérieur de 1 erreur standard :
cvdata$lambda.1se[1] 0.071673Pour obtenir la liste de ces variables, on écrit :
coef(cv_lasso_fit, cv_lasso_fit$lambda.1se)83 x 1 sparse Matrix of class "dgCMatrix"
s1
(Intercept) -64.0455866216
manufacturer_audi 1.5005369115
manufacturer_jeep -0.1174150053
manufacturer_land rover 0.1612552376
manufacturer_nissan -0.1059190236
manufacturer_pontiac 0.8169337991
model_4runner 4wd -0.5598256719
model_a4 quattro 0.5838794421
model_c1500 suburban 2wd -0.2756224964
model_caravan 2wd -0.3546136186
model_corvette 1.5663555709
model_f150 pickup 4wd -0.2270155529
model_forester awd 0.6830388254
model_grand prix 0.0193951129
model_maxima -0.6714694460
model_new beetle 0.2395820131
model_passat 0.2035794420
model_range rover 0.0072253567
model_toyota tacoma 4wd -0.1979795939
year 0.0353436525
cyl -0.0568519000
trans_auto(av) -0.4658374498
trans_auto(l3) -0.8101522067
trans_auto(l4) -0.0860617303
trans_auto(l5) 0.1494574949
trans_auto(s5) 0.5779641947
drv_4 -1.5127151569
drv_f 0.0009265857
cty 1.0643633366
fl_c 2.5131385470
fl_d 0.5011373754
fl_e -0.8901996792
class_2seater 0.0315777873
class_compact 0.0529440191
class_midsize 0.6824124438
class_pickup -1.4729080052
class_suv -1.2054913050Machine learning pour la sélection de variables
Le machine learning (apprentissage automatique), en particulier les forêts aléatoires (random forest), peut également servir à identifier les variables importantes. Le machine learning (random forest) dispose d'un moyen naturel de quantifier la force de chaque prédicteur, ce qui permet de classer tous les prédicteurs selon leur capacité prédictive. Cette approche est de plus en plus courante dans les études cliniques ; son avantage est que ces méthodes peuvent traiter un très grand nombre de variables candidates (des milliers de variables ne posent aucun problème). D'autres méthodes, comme l'analyse en composantes principales (ACP, principal component analysis), peuvent aussi être utilisées, mais les forêts aléatoires présentent plusieurs avantages par rapport à celles-ci. Ces méthodes sont abordées dans les chapitres correspondants.