
Un ensemble fait de la meilleure musique. Mille modèles de prédiction valent mieux qu'un seul.
L'être humain a tendance à structurer sa pensée et ses décisions. Une structure que nous utilisons souvent, consciemment comme inconsciemment, est la hiérarchie. Vous créez et utilisez des hiérarchies tous les jours. Imaginez que vous êtes dans un magasin et que vous essayez de décider si vous allez acheter un ordinateur. Pour prendre une décision judicieuse, vous commencez par vous demander : « Ai-je les moyens d'acheter un nouvel ordinateur ? ». Si la réponse à cette question est « non », vous renoncerez probablement à acheter l'ordinateur. Si la réponse est « oui », vous passerez sans doute à la question suivante : « Ai-je besoin d'un nouvel ordinateur ? ». Si la réponse est « non », vous renoncerez probablement à l'achat. Si la réponse est « oui », vous vous demanderez peut-être : « Est-ce le bon ordinateur pour moi ? ». Autrement dit, vous avez tenté de prendre une décision en vous posant une série de questions organisées de façon hiérarchique. Comme le montre la figure X, ce type de cheminement décisionnel ressemble à un arbre renversé, et on l'appelle un arbre de décision (angl. decision tree).
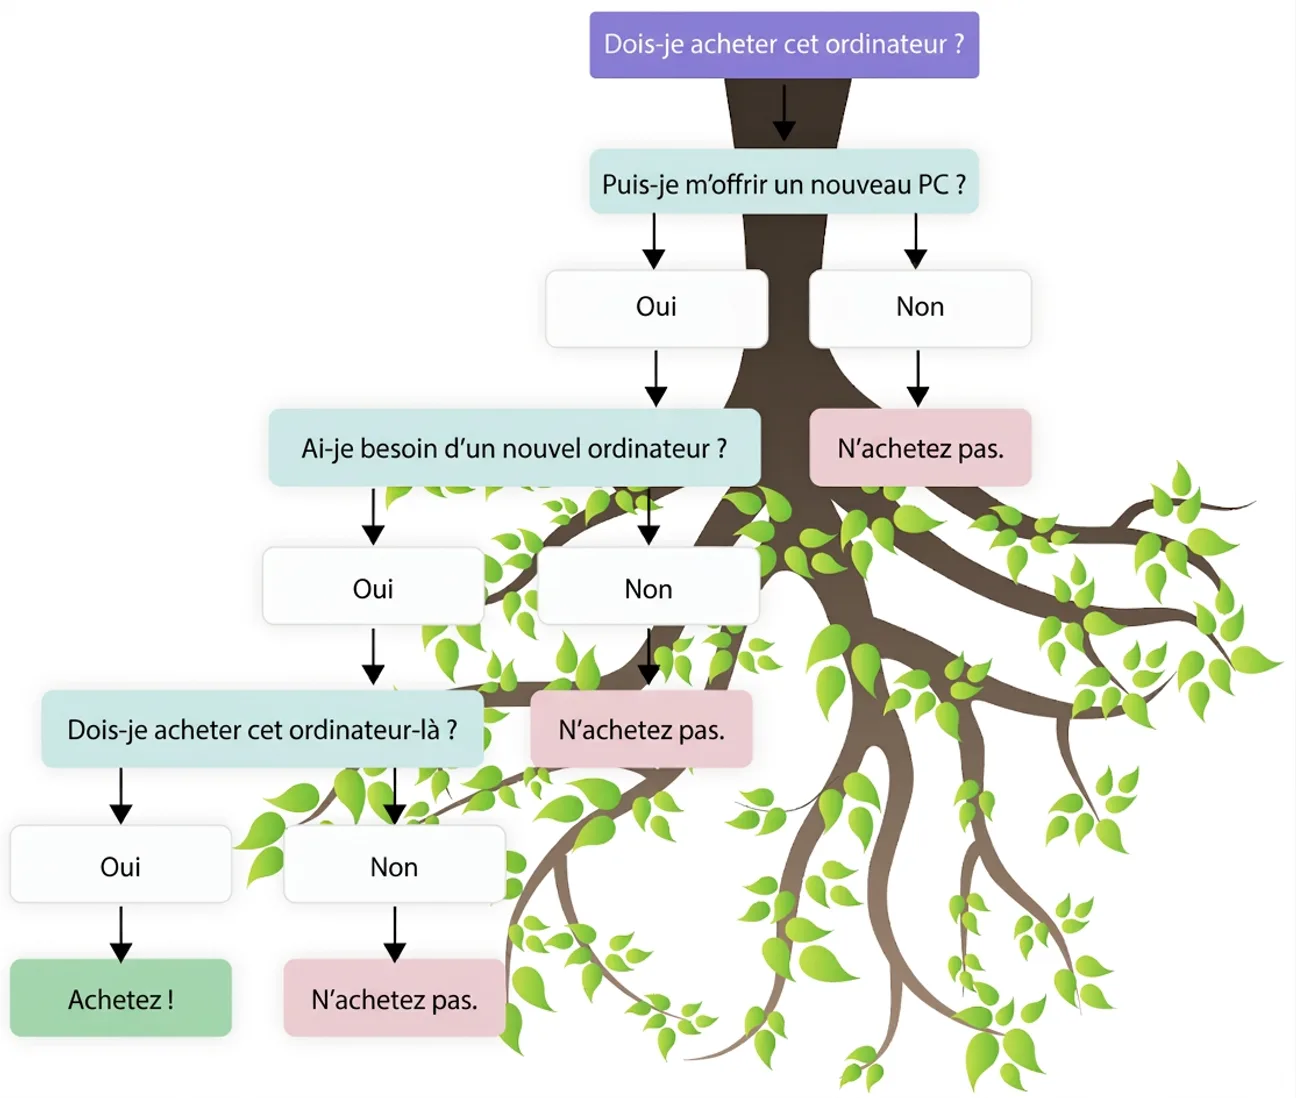
Les arbres de décision : une idée brillante
Aujourd'hui, les arbres de décision dominent presque tout l'apprentissage automatique (machine learning) appliqué aux données structurées (c'est-à-dire des données présentées en lignes et en colonnes). Sur Kaggle (www.kaggle.com), des milliers d'experts s'affrontent pour créer les meilleurs modèles de prédiction, et les résultats de ces compétitions montrent que les arbres de décision obtiennent le plus souvent de meilleures performances que tout autre modèle sur des données structurées. En fait, vous utilisez déjà des arbres de décision chaque jour, par exemple lorsque vous utilisez le moteur de recherche de Google ou votre messagerie électronique. La raison pour laquelle les arbres de décision peuvent servir à la prédiction est simple : dans l'exemple ci-dessus, vous pouvez appliquer l'algorithme de décision à un autre ordinateur et évaluer si vous devriez plutôt acheter celui-là.
Avec l'apprentissage automatique moderne, on construit les arbres de décision de manière très sophistiquée. On utilise une procédure d'apprentissage générale qui, à partir des motifs présents dans les données, crée des règles et construit ainsi l'arbre. La structure de l'arbre, et donc le modèle de prédiction, est ainsi guidée par les données (voir la discussion précédente). Nous allons maintenant voir précisément comment ces arbres sont construits et comment ils sont utilisés.
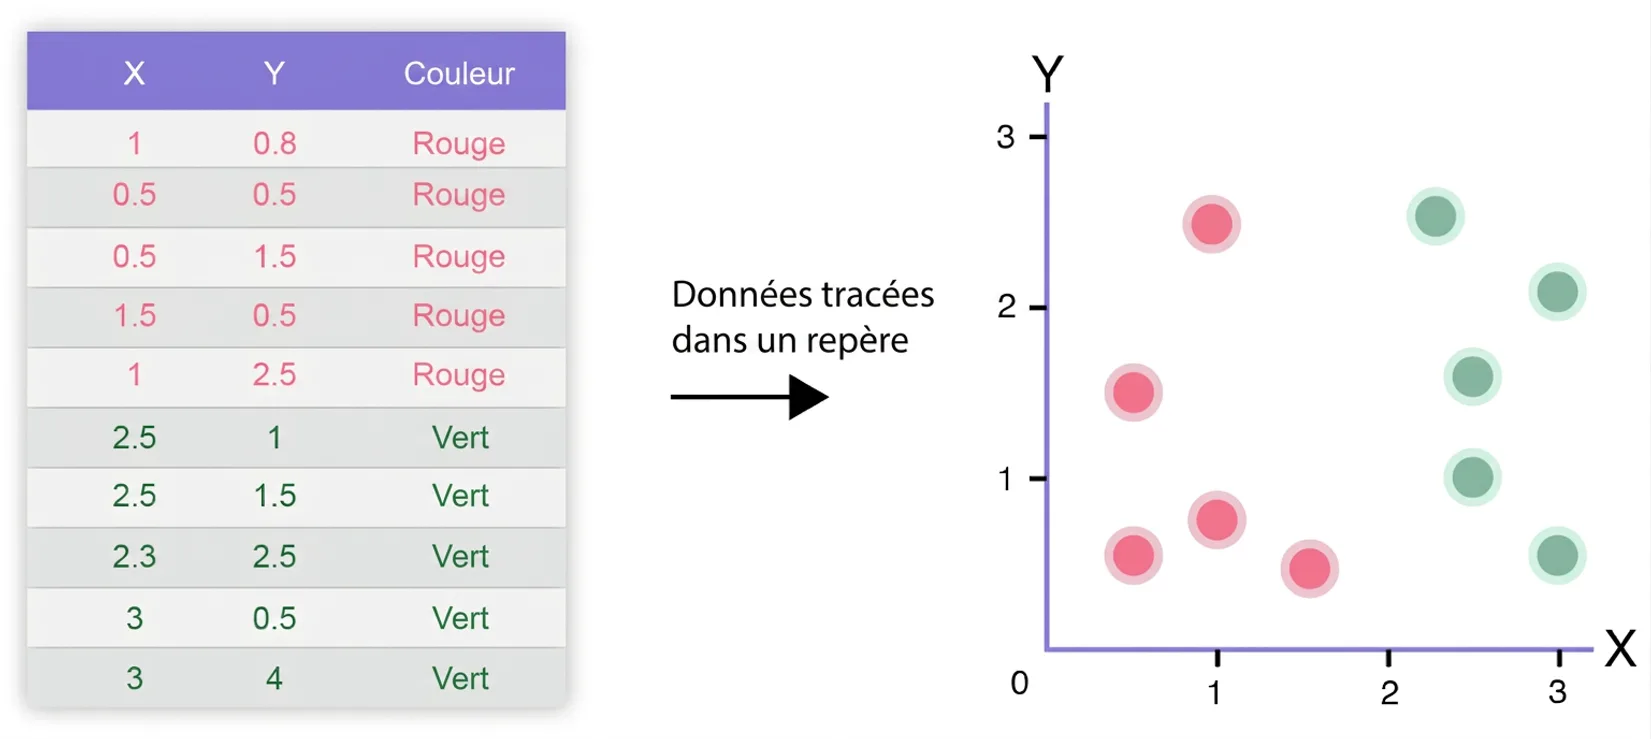
Dans la figure ci-dessous, les mêmes données sont présentées dans le tableau et dans le repère. Imaginez que nous devions ajouter un point au repère et que l'abscisse de ce point soit 2,0. Quelle couleur pensez-vous que ce point aura ? Probablement verte, et vous venez ainsi de construire et d'évaluer un arbre de décision dans votre tête ! La structure de l'arbre de décision apparaît dans la figure suivante.
Dans cet arbre de décision, une seule règle fondée sur la valeur de x est utilisée. Si x est inférieur à 2, nous prenons la branche de gauche, où les valeurs semblent être rouges. Si x est supérieur ou égal à 2, nous prenons la branche de droite, où les observations semblent être vertes. Chaque observation sera donc testée pour savoir si x est inférieur à 2, puis une décision sera prise quant à la branche à suivre. Ce point où les données doivent être séparées s'appelle un nœud. La division elle-même s'appelle un split.
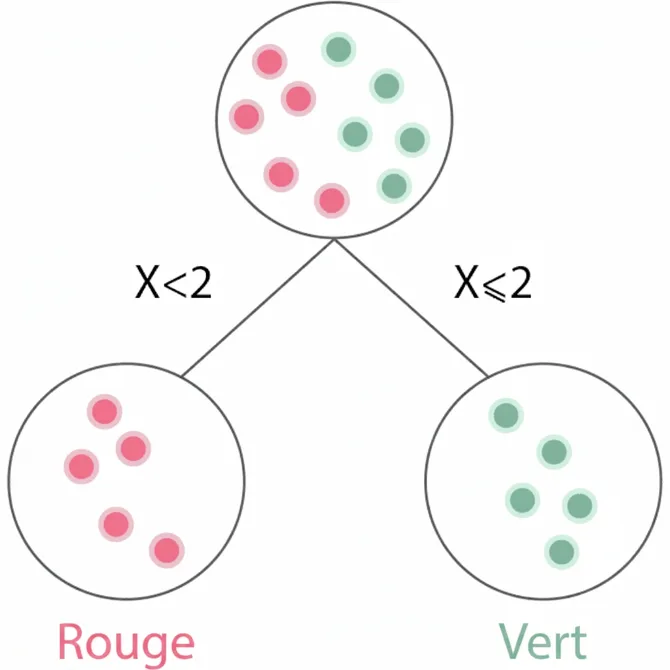
Cet arbre de décision peut donc servir à deviner la couleur d'une observation à partir de sa valeur de x. Nous pouvons ainsi prédire la couleur à partir de l'une des variables. On dit que l'arbre de décision peut servir à classer les observations (comme vertes ou rouges).
Dans le repère suivant, les observations présentent maintenant trois couleurs différentes. Essayons d'utiliser notre premier arbre de décision. Les valeurs de x supérieures ou égales à 2 seront toujours classées comme vertes, mais les valeurs inférieures à 2 ne peuvent pas être classées correctement à chaque fois, car certaines observations sont bleues. Il nous faut donc un nœud supplémentaire !
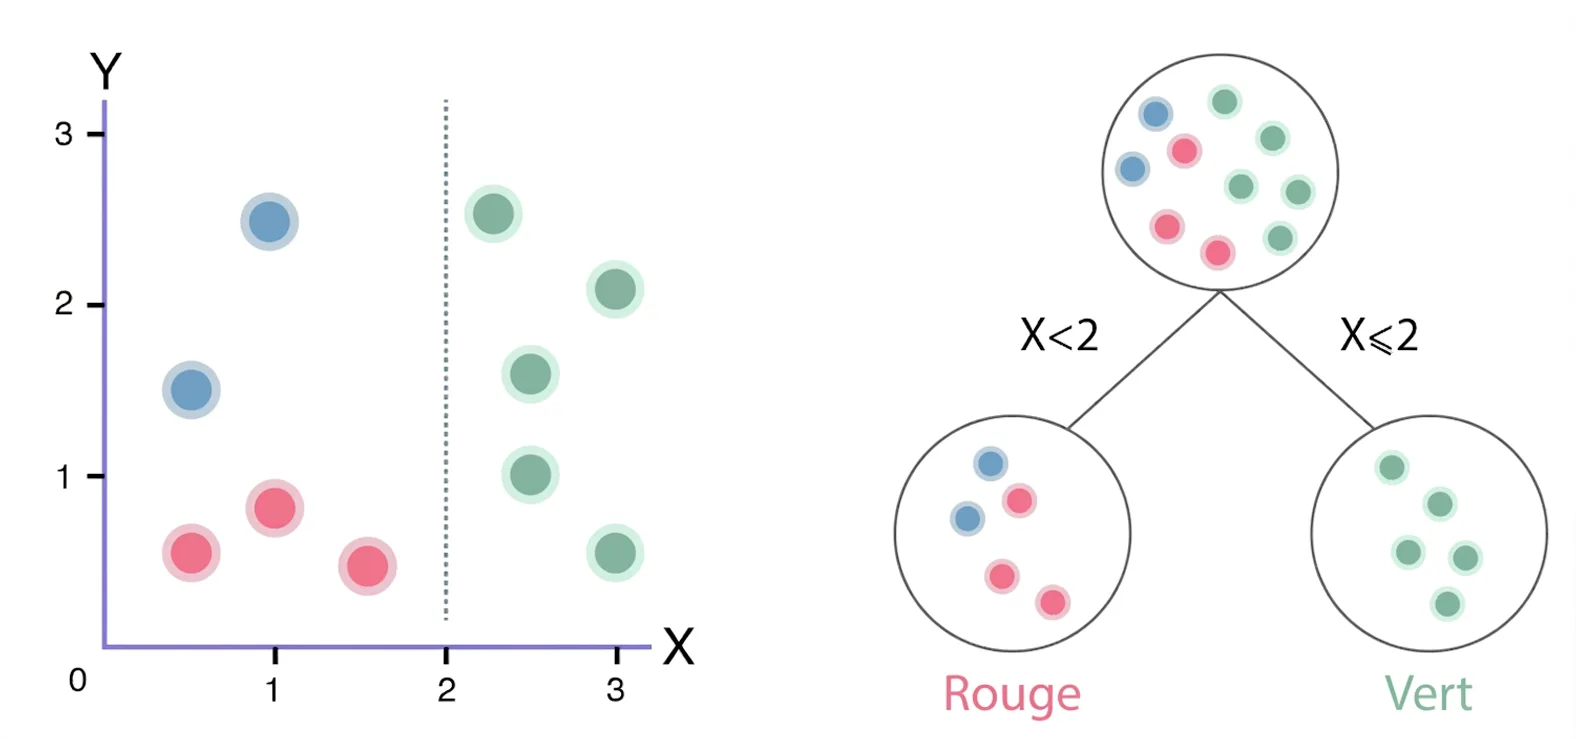
Nous créons maintenant un nœud supplémentaire, avec une nouvelle règle fondée sur la valeur de y. Si la valeur de y est inférieure à 1, nous classons l'observation comme rouge, sinon comme bleue, de la façon suivante :
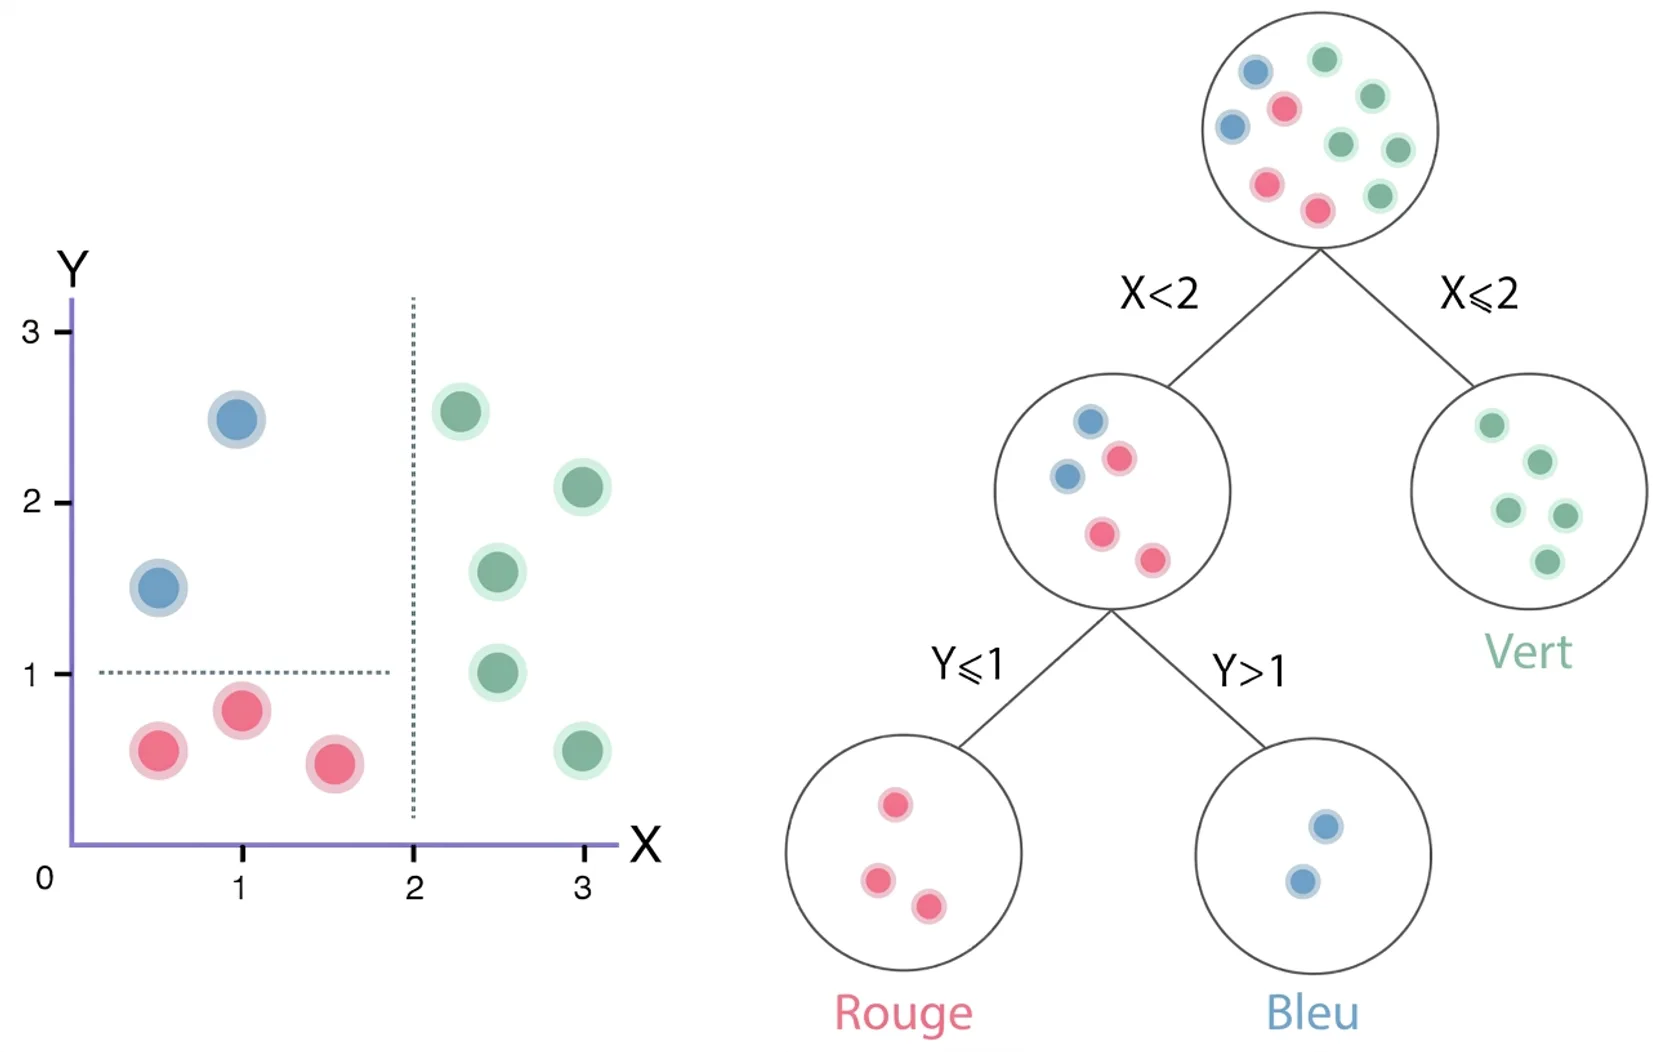
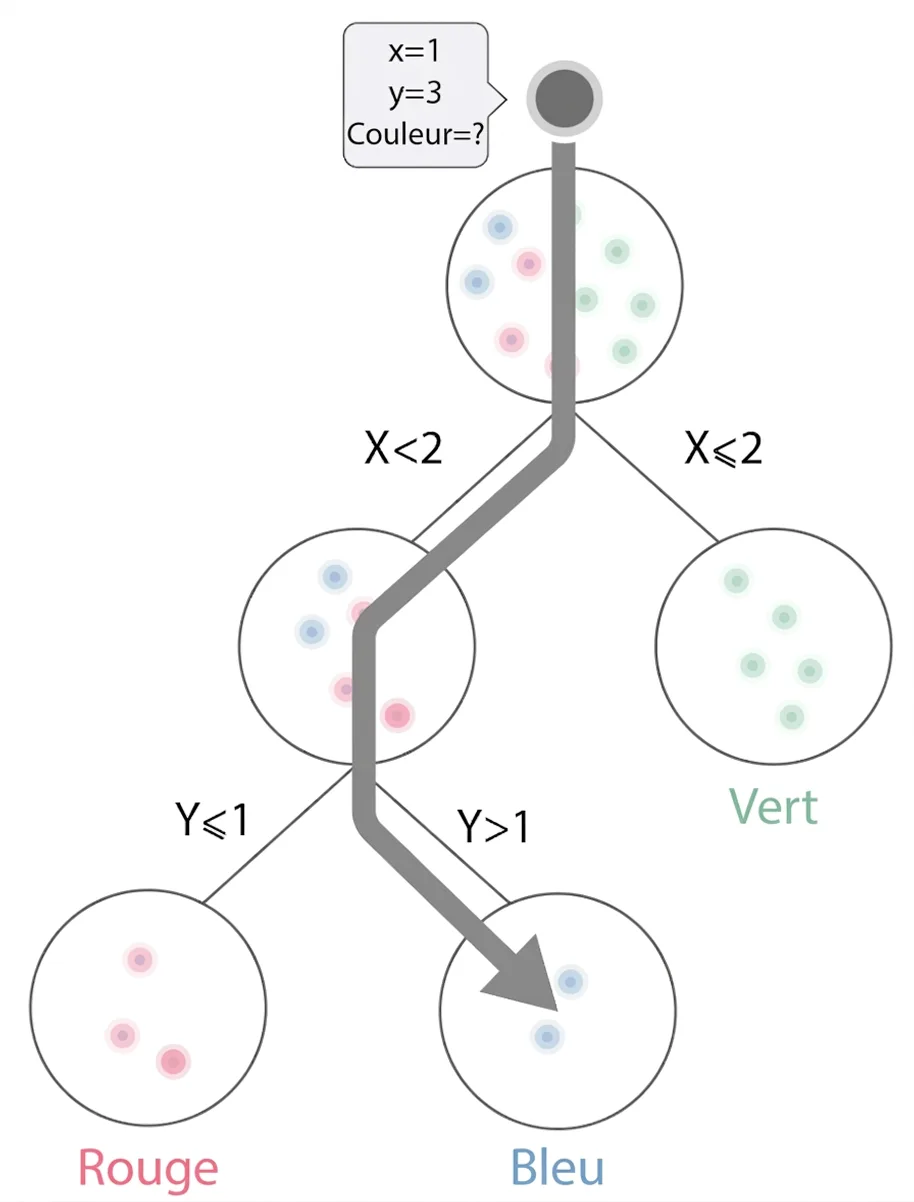
C'est en fait là tout le principe de la construction des arbres de décision. Comme le montre cette discussion, nous pouvons maintenant utiliser notre arbre de décision pour prédire la couleur qu'aura une nouvelle observation, à partir de ses valeurs de x et de y. L'arbre peut donc être utilisé comme modèle de prédiction. Vous en voyez un exemple dans la figure suivante, où nous faisons parcourir l'arbre de décision à une observation entièrement nouvelle pour finalement deviner la couleur qu'elle a probablement.
L'apprentissage automatique avec des arbres de décision
Chaque arbre individuel est un modèle de prédiction. Le principe de l'apprentissage automatique avec des arbres de décision consiste à créer des centaines, voire des milliers d'arbres, et à utiliser leur ensemble pour prédire. On utilise donc un jeu de données pour créer des centaines ou des milliers d'arbres, qui servent ensuite à prédire. Comme pour les réseaux de neurones, les arbres doivent être entraînés et évalués, ce qui se fait selon les mêmes principes. Comme ces modèles de prédiction sont constitués de nombreux modèles individuels (c'est-à-dire d'arbres individuels), on les appelle aussi méthodes ensemblistes (angl. ensemble methods), ce qui signifie que l'on utilise un ensemble de modèles de prédiction. On emploie parfois aussi le terme de méthode à base d'arbres (angl. tree-based method).
Construire de nombreux arbres
En règle générale, on construit donc plusieurs centaines ou milliers d'arbres de décision lorsqu'on fait de l'apprentissage automatique avec des arbres de décision. Ces arbres sont créés à partir du même jeu de données. Si, par exemple, vous étudiez les visiteurs d'un site web et disposez de données sur 1000 visiteurs, c'est ce jeu de données qui sert à construire tous les arbres. Pour cela, chaque arbre n'a le droit d'utiliser qu'une petite fraction (le plus souvent un tiers) de l'ensemble des données. Cette fraction doit en outre être sélectionnée de façon entièrement aléatoire. Le premier arbre analyse ainsi un tiers des visiteurs tiré au sort. L'arbre suivant reçoit un nouveau tiers des visiteurs, lui aussi tiré au sort, et se construit à partir de leurs informations. Il en va de même pour le troisième, le quatrième, le cinquième et tous les arbres suivants. Chaque arbre est donc construit à partir d'un sous-ensemble des données sélectionné au hasard. De cette façon, chaque arbre est unique.
Trouver les nœuds et les splits optimaux
Les repères suivants montrent le même jeu de données avec différentes règles pour séparer les points. À gauche, on voit des splits qui parviennent à distinguer toutes les couleurs les unes des autres. À droite, on voit que les critères (les règles) ne permettent pas de séparer complètement les points. Pour que la prédiction de l'arbre soit bonne, celui-ci doit trouver des règles capables de distinguer les observations les unes des autres. Pour y parvenir, l'ordinateur doit évaluer chaque split. Un bon split se définit par le fait que les groupes ainsi créés diffèrent autant que possible quant à ce qui est étudié, c'est-à-dire ici la couleur.
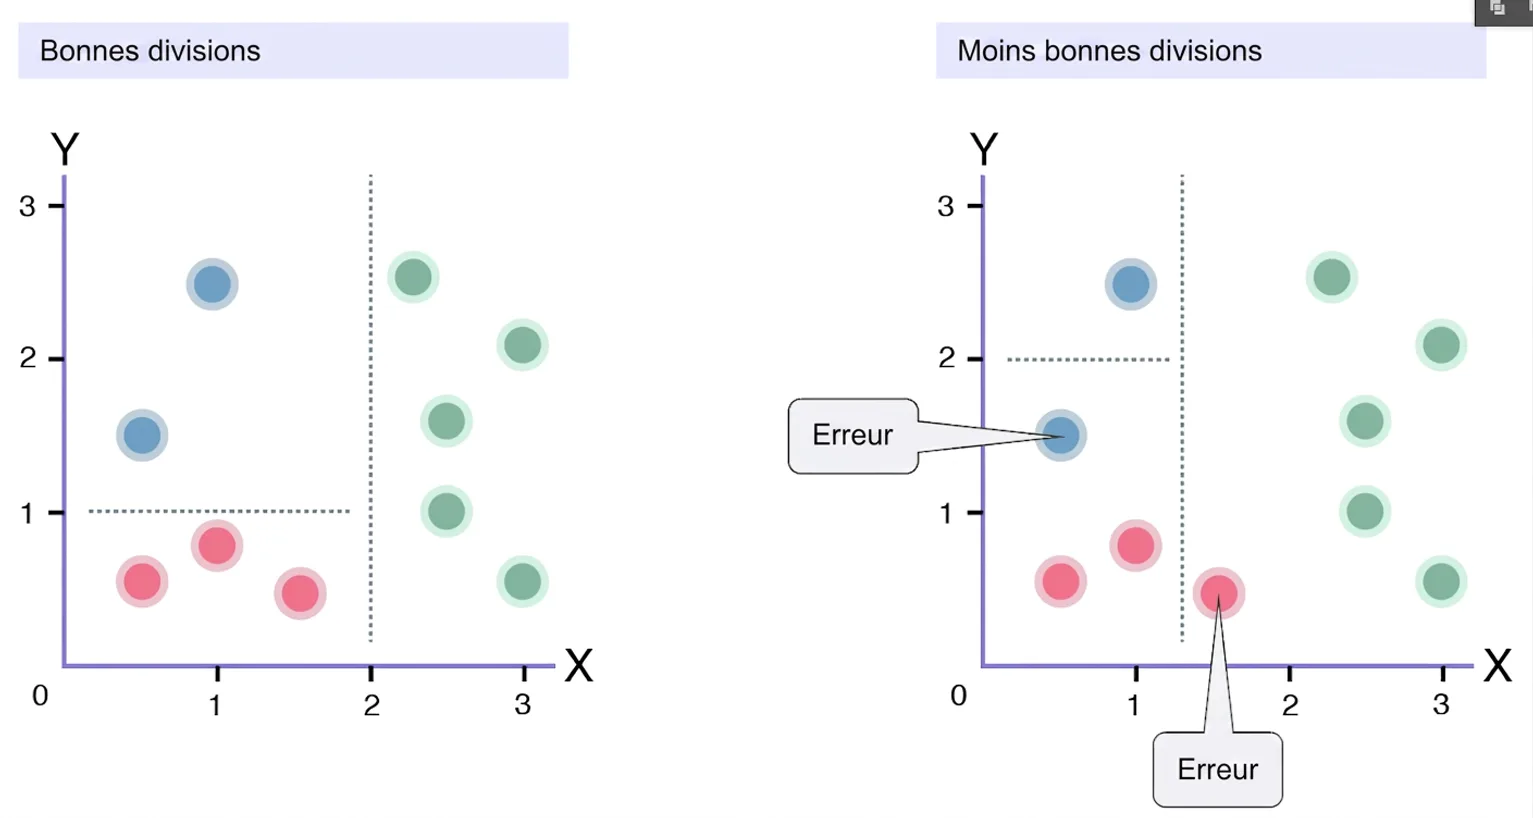
Il existe plusieurs variantes pour réaliser cette évaluation. Toutes fonctionnent en calculant dans quelle mesure différents splits parviennent à séparer les couleurs les unes des autres. L'ordinateur peut donc procéder par essais successifs pour déterminer quel split offre la séparation maximale des observations selon leur couleur.
Cette méthode de recherche des splits optimaux est générale et peut s'appliquer à tous les types de données structurées, c'est-à-dire des données sous forme de tableau (colonnes et lignes). Peu importe que l'on étudie des patients atteints de cancer, les visiteurs d'une boutique en ligne, des rayons de soleil ou des batteries de voiture. Les arbres de décision sont extrêmement puissants et peuvent prédire sur tous les types de données structurées. La raison en est la procédure d'apprentissage générale, c'est-à-dire le calcul effectué pour créer chaque split. Cette manière d'« apprendre » ressemble d'ailleurs à la façon dont l'être humain pense, et elle reçoit ici une fonction mathématique exacte.