Le « learning » du machine learning (apprentissage automatique)
L'être humain possède une remarquable capacité à créer des représentations simples d'informations complexes. Nous apprenons par nos sens (vue, ouïe, goût, etc.), qui sont capables de construire des représentations utiles à partir de l'ensemble des impressions sensorielles. Lorsque nous regardons la photo d'une forêt, nous reconnaissons immédiatement qu'il s'agit d'une forêt ; nul besoin d'analyser la couleur exacte des arbres ou l'aspect des feuilles. Notre cerveau extrait de l'image l'information nécessaire pour déterminer s'il s'agit ou non d'une forêt. De la même manière, nous pouvons dire si la photo contient un vélo. Le cerveau recherchera deux objets ronds (les roues) fixés sur une structure triangulaire (le cadre). Vous rechercherez les structures caractéristiques d'un vélo : roues, cadre, selle, guidon. Ces composants sont des représentations de l'ensemble plus vaste : le vélo.
Le principe du machine learning, et en particulier du deep learning, est exactement le même : chercher des représentations dans les données. Dans la grande majorité des cas, on utilise des données d'entraînement (voir plus haut) pour lesquelles une classification cible est connue. En voici un exemple :
Vous souhaitez développer un logiciel capable de distinguer les chiens des chats sur des photos. Pour cette tâche, vous avez rassemblé 5 000 photos, dont environ la moitié représente des chiens. Toutes les photos ont été évaluées et classées (par un humain) comme « chien » ou « chat ». L'ordinateur va analyser l'ensemble des photos afin de trouver des représentations propres au chien et au chat respectivement.
Le fondement de l'intelligence artificielle, et donc du deep learning, consiste à trouver de bonnes représentations des données. Pour qu'un ordinateur crée des représentations, il doit transformer (remodeler) les données. Le but de la transformation est de distiller l'information, c'est-à-dire d'éliminer le bruit et de concentrer et renforcer l'information utile. En deep learning, les données sont généralement transformées en plusieurs étapes et, à chaque transformation, l'ordinateur tente de créer des représentations informatives du contenu. Une fois qu'un nombre suffisant de transformations a été effectué, l'ordinateur a appris quelles représentations sont caractéristiques du chat et du chien respectivement.
Une bonne représentation se caractérise par deux éléments : (1) elle contient une information utile et (2) elle est reproductible. Sur la photo du vélo, les structures rondes (les roues) sont très informatives et il est essentiel de les repérer. Il importe en outre de repérer les roues chaque fois qu'elles figurent sur la photo, quels que soient l'environnement du vélo, les couleurs et l'emplacement du vélo sur la photo.
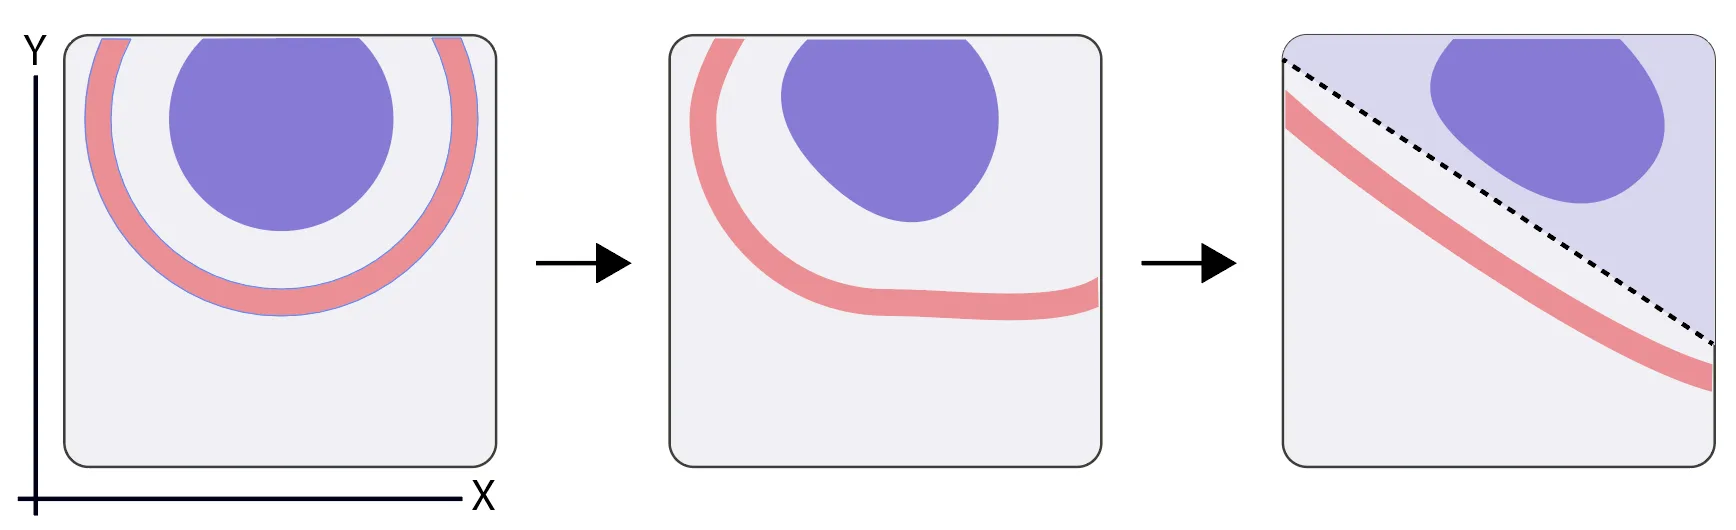
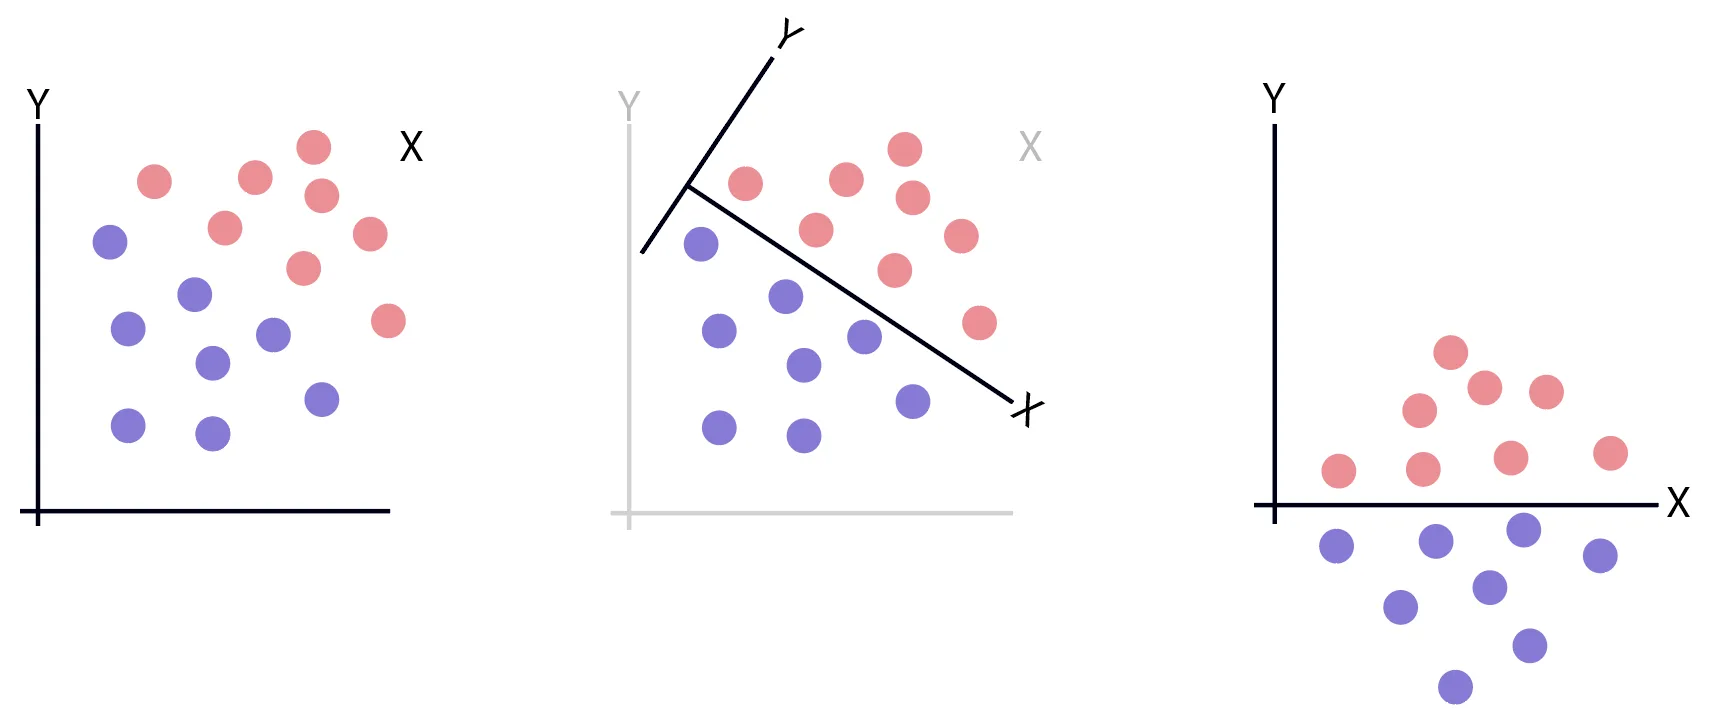
Le machine learning permet de trouver des représentations automatiquement. À l'aide de différents algorithmes, on recherche des transformations utiles. Les représentations sont obtenues au moyen d'opérations mathématiques relativement élémentaires. Ces opérations peuvent par exemple consister, pour la machine, à éliminer toutes les valeurs supérieures à X, ou à modifier toutes les coordonnées d'une certaine manière (voir les exemples des figures 1 et 2). Même si les transformations sont simples, elles peuvent se révéler extrêmement efficaces lorsque la machine reçoit la bonne rétroaction (feedback). De fait, si la machine reçoit une rétroaction adéquate sur ses transformations, celles-ci peuvent servir à résoudre des tâches très complexes, comme traduire un texte, conduire une voiture, interpréter des images, etc.
Rétroaction (feedback)
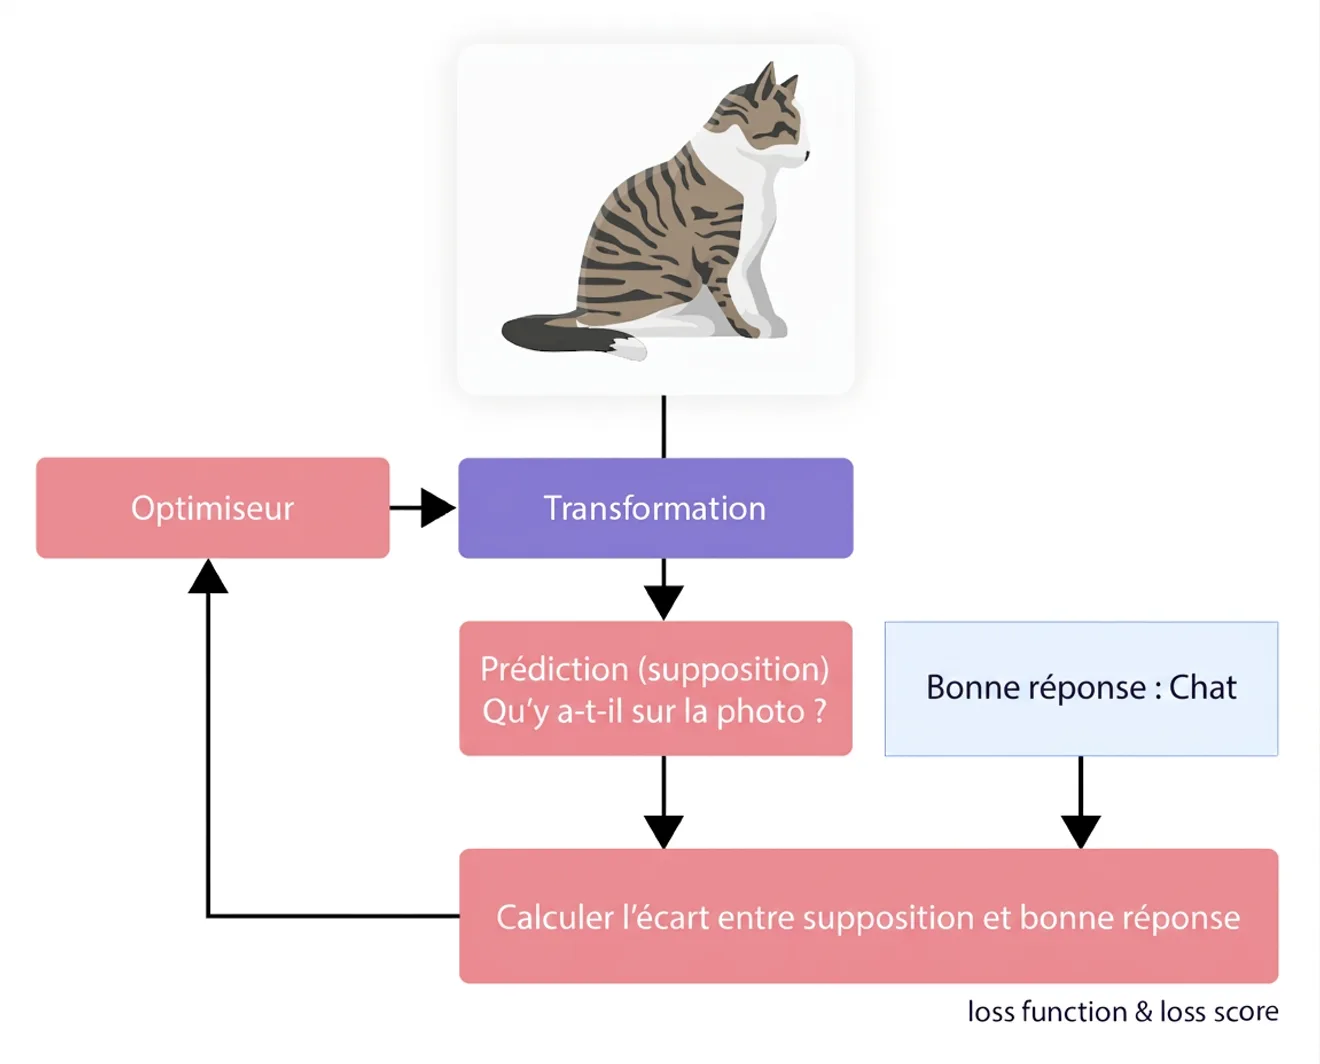
Supposons que nous disposions de 5 000 photos de chiens et de chats. Notre objectif est de créer un programme capable de déterminer si la photo montre un chien ou un chat. Nous nous appuyons pour cela sur un algorithme de machine learning capable de trouver de nouvelles représentations dans les données. La machine transforme les données et cherche des représentations caractéristiques des chats et des chiens respectivement. Elle teste ces représentations en essayant de deviner quel animal figure sur la photo. Comme la machine dispose du corrigé (la bonne réponse), elle peut juger si sa prédiction était bonne ou mauvaise. Il s'agit d'une étape décisive dans tout machine learning. La machine apprend en effet en évaluant la qualité de ses prédictions, et l'écart entre la prédiction de la machine et la bonne réponse est calculé par une fonction de perte (en anglais, loss function). L'écart entre la prédiction et la bonne réponse est exprimé sous forme de score de perte (loss score). La machine transmet le score de perte à un optimiseur, qui peut ajuster la transformation dans le but d'obtenir une transformation qui réduit le score de perte. Plus le score de perte est faible, plus la prédiction est proche de la bonne réponse. Le machine learning peut ainsi être guidé vers des représentations permettant d'établir ce que contient la photo.