
Apprentissage profond (deep learning)
Le deep learning est une forme de machine learning. Lorsqu'on parle d'intelligence artificielle, on fait le plus souvent référence à diverses applications du deep learning. Le principe du deep learning est très simple : il construit des représentations en plusieurs étapes. Ces étapes sont appelées couches (en anglais layers), et l'objectif est d'obtenir une meilleure représentation à chaque couche. Il n'est pas rare d'utiliser plusieurs centaines de couches.
En deep learning, ces couches sont organisées en réseaux de neurones (en anglais neural networks). Le terme est emprunté aux cellules nerveuses du cerveau humain (les neurones). Les réseaux de neurones du deep learning s'inspirent des neurones cérébraux, ce qui ne signifie pas pour autant qu'ils fonctionnent comme eux. En réalité, il existe très peu de ressemblances entre le deep learning et la manière dont les neurones apprennent. La présentation grand public du deep learning comme une version numérique du cerveau est donc erronée. Les réseaux de neurones comportant de nombreuses couches sont appelés deep neural networks (DNN), ou plus généralement deep learning.
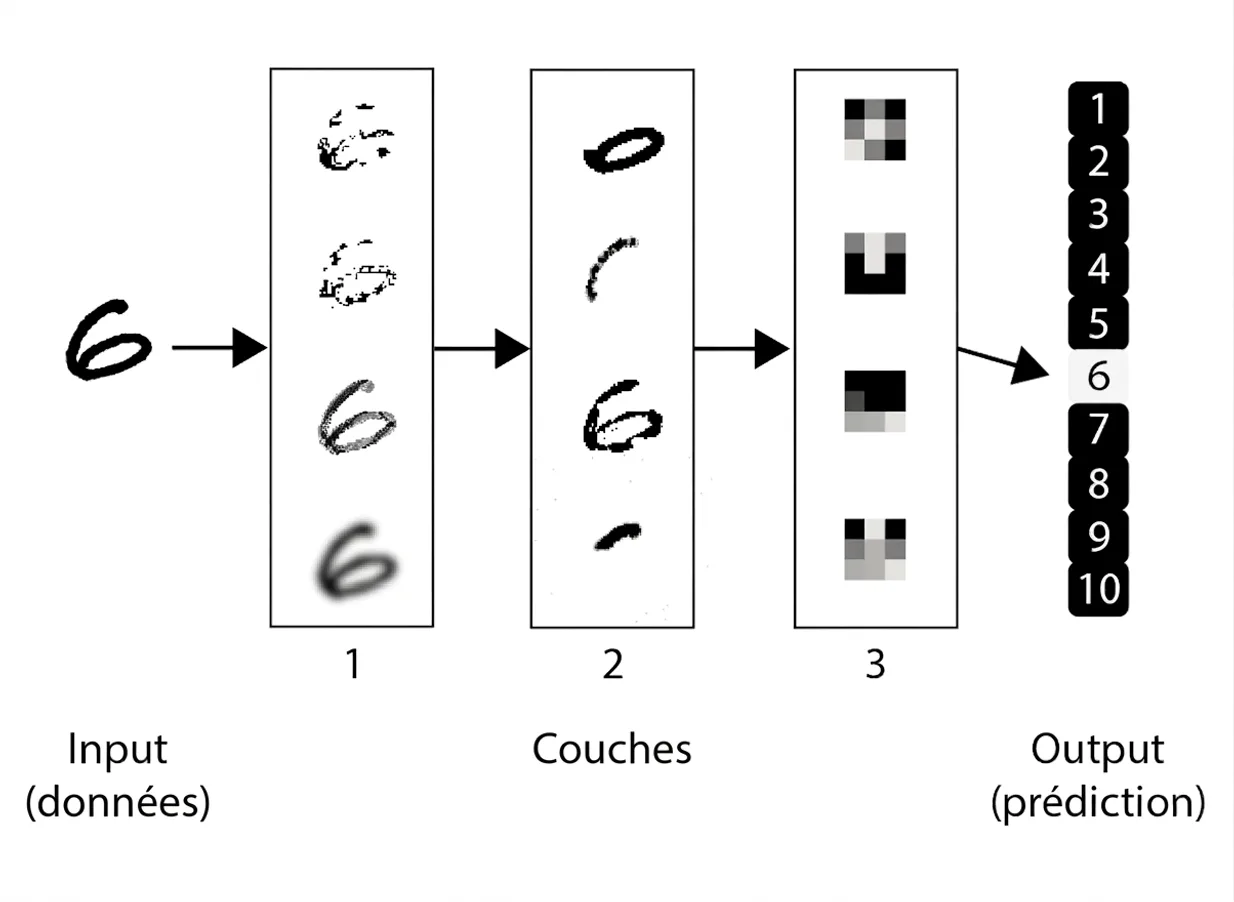
La tâche du réseau de neurones consiste à transformer l'entrée (les données qui lui sont fournies) en représentations de plus en plus différentes de cette entrée, mais aussi de plus en plus informatives. Le réseau distille et filtre l'information, de sorte que seules les caractéristiques utiles et distinctives subsistent dans la dernière couche. Dans cette dernière couche, l'information est condensée à tel point que le réseau peut, d'après l'activation de la couche, déterminer de quel chiffre il s'agit.
Que se passe-t-il dans une couche ?
Chaque couche reçoit de l'information (des nombres) de la couche précédente et traite ces nombres avant de les transmettre à la couche suivante. À mesure que l'information circule à travers les couches, des représentations utiles sont extraites.
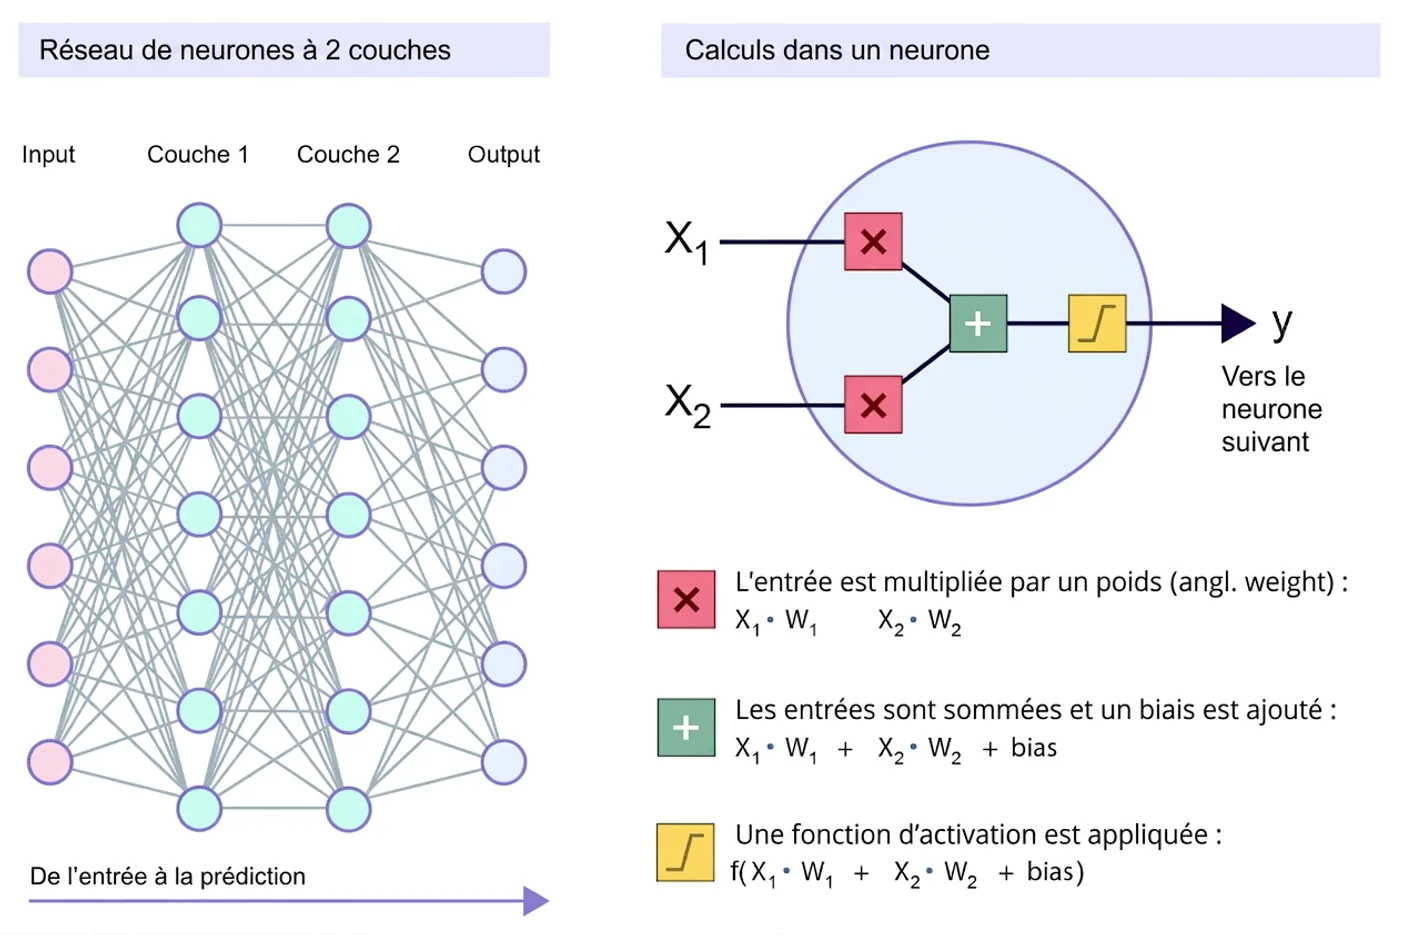
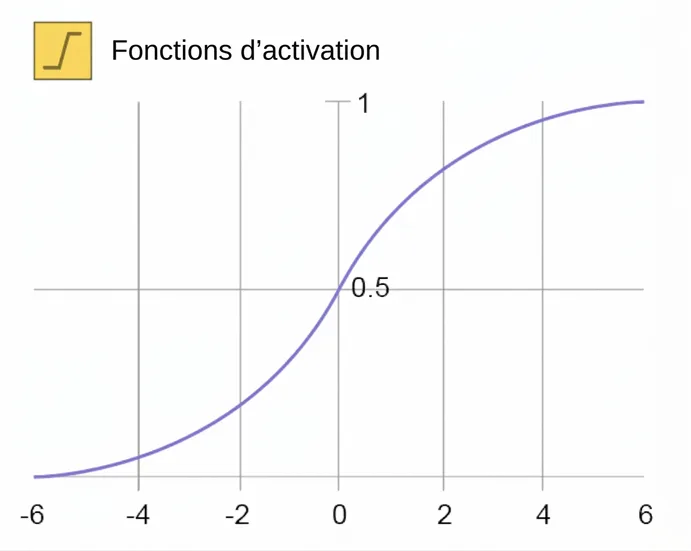
Dans chaque couche, ce sont les neurones (synonyme : nœuds) qui reçoivent, traitent et transmettent l'information. Dans la figure ci-dessus, le neurone reçoit x1 et x2, effectue des calculs puis transmet la valeur y. Dans le neurone, chaque entrée (chaque nombre reçu) est multipliée par un poids. Ensuite, toutes les entrées sont additionnées et un biais est ajouté. Le résultat passe alors par une fonction d'activation, dont le but est de convertir le résultat final en un nombre facile à manipuler. Dans l'exemple ci-dessus, la fonction d'activation est une fonction sigmoïde. Cette fonction transforme toute valeur reçue en un nombre compris entre 0 et 1. Les grands nombres positifs tendent vers 1 et les grands nombres négatifs tendent vers 0.
Les poids sont déterminants pour le réseau de neurones. Avec les bons poids, le réseau fonctionnera bien et accomplira la tâche pour laquelle il a été conçu. Toute la difficulté consiste à trouver les bons poids. Comme un réseau de neurones peut contenir des millions de poids, cela devient un défi considérable. La tâche est encore plus ardue lorsqu'on constate que la modification d'un seul poids peut affecter l'ensemble du réseau. Le grand défi est donc d'ajuster tous ces poids pour qu'ils soient optimaux pour l'objectif visé.
Les poids sont ajustés à l'aide d'une fonction de perte (loss function, évoquée plus haut). La fonction de perte calcule simplement l'écart entre la prédiction actuelle du réseau et la vérité. Cet écart est appelé loss score. Si le loss score est élevé, l'écart entre la prédiction et la vérité est grand, ce qui est mauvais. Si le loss score est faible, le réseau a fait une bonne prédiction. Le loss score sert de signal de rétroaction (feedback signal) utilisé pour ajuster la valeur des poids. Autrement dit, le réseau évalue sa propre performance, se renvoie le résultat et ajuste ensuite ses poids pour s'améliorer. Les poids sont alors modifiés dans la direction qui fait diminuer le loss score.
Chaque réseau de neurones possède un optimiseur (en anglais optimizer). C'est l'optimiseur qui a pour tâche de gérer la rétroaction et d'ajuster les poids du réseau. Il utilise pour cela un algorithme appelé backpropagation algorithm (rétropropagation du gradient).
Lorsque le réseau de neurones est activé pour la première fois, les valeurs de tous les poids sont entièrement aléatoires. La prédiction du réseau est donc mauvaise (le loss score est élevé) au premier passage. Mais pour chaque exemple sur lequel il s'entraîne, le réseau ajuste ses poids dans la bonne direction et sa performance s'améliore progressivement. Si le réseau s'entraîne sur des milliers, voire des centaines de milliers d'exemples, la fonction de perte finit par être minimisée, ce qui signifie que le réseau a maximisé sa performance.
Ce mécanisme simple (chaque neurone reçoit une entrée, effectue une transformation élémentaire et transmet une sortie) se révèle extrêmement puissant.
Un réseau de neurones peut comporter un nombre arbitraire de couches, et chacune de ces couches peut contenir un nombre arbitraire de neurones. Le principe reste le même quelle que soit la taille du réseau : on fournit des valeurs d'entrée, on les laisse circuler à travers les couches et on obtient finalement une sortie dans la dernière couche. Dans un réseau de neurones, la toute première couche est appelée input layer (couche d'entrée) et la toute dernière (celle qui précède le label) est appelée output layer (couche de sortie). Toutes les couches intermédiaires sont appelées hidden layers (couches cachées). À mesure que les données traversent ces couches, l'algorithme apprend quels motifs existent et comment ils sont corrélés au critère de jugement étudié.
Qu'est-ce que le biais ?
Le biais est un paramètre supplémentaire ajusté lors de la calibration du réseau de neurones. En modifiant le biais, on peut augmenter ou diminuer l'activité d'un neurone. Deux éléments sont donc ajustés lorsque le réseau se calibre : les poids et les biais.
Le principe du deep learning
Le réseau de neurones construit des représentations à mesure que l'information circule à travers les couches. Lorsque les poids sont ajustés, certains neurones se renforcent tandis que d'autres s'affaiblissent, voire s'éteignent. Le réseau se guide lui-même à l'aide de la fonction de perte. Le deep learning peut ainsi être vu comme un processus dans lequel les données sont filtrées en plusieurs étapes et déchiffrées au fur et à mesure qu'elles traversent les couches.
Ce mécanisme conduit les couches à extraire les composantes clés des données, grâce auxquelles l'ordinateur apprend quelles composantes distinguent les chiens des chats.
Lorsqu'un ordinateur doit interpréter le contenu d'une image, il ne peut pas en percevoir immédiatement les grands traits. L'image est en effet convertie dans l'ordinateur en une grille de nombres, et ces nombres sont ensuite fournis au réseau de neurones, où l'information est transformée. Au cours de cette transformation, l'information importante est extraite. L'ordinateur peut alors détecter des lignes, des angles, des cercles, etc. La combinaison de ces différentes formes géométriques sert ensuite à distinguer les différents objets.
Pourquoi le deep learning est-il si efficace ?
Il existe de nombreuses méthodes de prédiction. Certaines sont générales et peuvent prédire à partir de nombreux types de données, tandis que d'autres sont plus spécifiques. La grande majorité des méthodes exigent un certain degré de feature engineering, c'est-à-dire que les données brutes doivent être préparées avant de pouvoir être analysées. Cela peut par exemple impliquer de convertir manuellement le contenu d'une photo dans un format analysable. Ce travail manuel est en règle générale très fastidieux et complexe. Avec le deep learning, le feature engineering est entièrement automatisé : le réseau de neurones s'en charge seul, quelle que soit la forme des données. Contrairement à d'autres méthodes d'analyse, le deep learning peut traiter des données tabulaires, des images et de la vidéo.