
Dans ce chapitre, nous utilisons les données de l'étude sur le cathétérisme cardiaque droit (Right Heart Catheterization, RHC) pour présenter les fonctions qui permettent de tabuler des données. Vous pouvez télécharger les données avec la commande suivante :
rhc <- read.csv("https://hbiostat.org/data/repo/rhc.csv", header = TRUE)Fonctions de base R
Base R correspond à l'installation de base, sans aucun package supplémentaire. La fonction la plus utilisée pour créer des tableaux dans base R est table().
Une variable catégorielle isolée peut être tabulée avec la fonction table() :
table(rhc$sex)Female Male
2543 3192Un tableau croisé se crée de la manière suivante :
table(rhc$sex, rhc$death) No Yes
Female 919 1624
Male 1094 2098Notez que le premier argument (sex) définit les lignes et que le second argument (death) définit les colonnes du tableau croisé.
Nous pouvons aussi construire un tableau croisé stratifié sur une troisième variable. Pour stratifier le tableau précédent sur la variable ca (cancer), nous écrivons :
table(rhc$sex, rhc$death, rhc$ca)ca = Metastatic
No Yes
Female 24 175
Male 12 173
ca = No
No Yes
Female 798 1151
Male 960 1470
ca = Yes
No Yes
Female 97 298
Male 122 455Tabulation avec des packages supplémentaires
Les packages janitor, dplyr, gtsummary, crosstable et rstatix proposent des fonctions puissantes pour créer des tableaux descriptifs. Installez-les avec la commande suivante :
install.packages(c("rstatix", "janitor", "gtsummary", "crosstable"))Rstatix
La fonction get_summary_stats() produit des statistiques descriptives pour les variables choisies. Dans l'exemple ci-dessous, nous sélectionnons les variables age, aps1, urin1, adld3p, paco21 et ph1 :
library(rstatix)
rhc %>%
  get_summary_stats(
    age, aps1, urin1, adld3p, paco21, ph1,
    type = "full")
## A tibble: 6 × 13
variable n min max median q1 q3 iqr mad mean sd se ci
adld3p 1439 0 7 0 0 2 2 0 1.18 1.82 0.048 0.094
age 5735 18.0 102. 64.0 50.1 73.9 23.8 17.0 61.4 16.7 0.22 0.432
aps1 5735 3 147 54 41 67 26 19.3 54.7 20.0 0.264 0.517
paco21 5735 1 156 37 31 42 11 8.90 38.7 13.2 0.174 0.341
ph1 5735 6.58 7.77 7.4 7.34 7.46 0.12 0.089 7.39 0.11 0.001 0.003
urin1 2707 0 9000 1927 1110 2955 1845 1357. 2192. 1525. 29.3 57.5L'argument type a été fixé ci-dessus à type="full", ce qui donne les paramètres présentés. Cet argument accepte les options suivantes : "full", "common", "robust", "five_number", "mean_sd", "mean_se", "mean_ci", "median_iqr", "median_mad", "quantile", "mean", "median", "min", "max".
Janitor
Janitor permet de créer des tableaux flexibles. Commençons par décrire la variable cat1 (catégorie diagnostique) :
library(janitor)

rhc %>% tabyl(cat1, show_na = T)
cat1 n percent
ARF 2490 0.434176112
CHF 456 0.079511770
Cirrhosis 224 0.039058413
Colon Cancer 7 0.001220575
Coma 436 0.076024412
COPD 457 0.079686138
Lung Cancer 39 0.006800349
MOSF w/Malignancy 399 0.069572799
MOSF w/Sepsis 1227 0.213949433Nous ajoutons ensuite la variable sex, ce qui donne un tableau croisé :
rhc %>% tabyl(cat1, sex, show_na = T) cat1 Female Male
ARF 1108 1382
CHF 143 313
Cirrhosis 81 143
Colon Cancer 5 2
Coma 230 206
COPD 208 249
Lung Cancer 12 27
MOSF w/Malignancy 190 209
MOSF w/Sepsis 566 661Les fonctions « adorn » de janitor permettent d'enrichir les tableaux avec des informations supplémentaires. Elles peuvent être combinées entre elles. Les voici :
| Nom de la fonction | Rôle |
|---|---|
adorn_totals() |
Ajoute un total. Possède l'argument where =, qui peut valoir “row”, “col” ou “both”. |
adorn_percentages() |
Convertit les effectifs en proportions. Possède l'argument denominator =, qui peut valoir “row”, “col” ou “all”. |
adorn_pct_formatting() |
Convertit les proportions en pourcentages. |
adorn_rounding() |
Arrondit les décimales des proportions. |
adorn_ns() |
Ajoute les effectifs à un tableau de proportions ou de pourcentages. |
adorn_title() |
Ajoute un intitulé aux lignes et aux colonnes du tableau croisé. |
Créons un tableau croisé exprimé en pourcentages :
rhc %>%
  tabyl(cat1, sex, show_na = T) %>%
  adorn_totals(where="col") %>%
  adorn_totals(where="row") %>%
  adorn_percentages() %>%
  adorn_pct_formatting()
cat1 Female Male Total
ARF 44.5% 55.5% 100.0%
CHF 31.4% 68.6% 100.0%
Cirrhosis 36.2% 63.8% 100.0%
Colon Cancer 71.4% 28.6% 100.0%
Coma 52.8% 47.2% 100.0%
COPD 45.5% 54.5% 100.0%
Lung Cancer 30.8% 69.2% 100.0%
MOSF w/Malignancy 47.6% 52.4% 100.0%
MOSF w/Sepsis 46.1% 53.9% 100.0%
Total 44.3% 55.7% 100.0%Ajoutons maintenant les effectifs en plus des pourcentages :
rhc %>%
  tabyl(cat1, sex) %>%
  adorn_totals(where = "row") %>%
  adorn_percentages(denominator = "col") %>%
  adorn_pct_formatting() %>%
  adorn_ns(position = "front") %>%
  adorn_title(
    row_name = "Sjukdom",
    col_name = "Kön")
Kön
Sjukdom Female Male
ARF 1108 (43.6%) 1382 (43.3%)
CHF 143 (5.6%) 313 (9.8%)
Cirrhosis 81 (3.2%) 143 (4.5%)
Colon Cancer 5 (0.2%) 2 (0.1%)
Coma 230 (9.0%) 206 (6.5%)
COPD 208 (8.2%) 249 (7.8%)
Lung Cancer 12 (0.5%) 27 (0.8%)
MOSF w/Malignancy 190 (7.5%) 209 (6.5%)
MOSF w/Sepsis 566 (22.3%) 661 (20.7%)
Total 2543 (100.0%) 3192 (100.0%)Vous pouvez enregistrer le tableau directement au format Microsoft Word, PowerPoint, HTML ou sous forme d'image grâce au package flextable, dont les fonctions s'appliquent directement comme dans l'exemple ci-dessous. La fonction save_as_docx() enregistre le tableau au format Microsoft Word. Vous pouvez aussi utiliser les fonctions save_as_html(), save_as_word(), save_as_ppt() ou save_as_image().
install.packages("flextable")
library(flextable)

rhc %>%
  tabyl(cat1, sex) %>%
  adorn_totals(where = "row") %>%
  adorn_percentages(denominator = "col") %>%
  adorn_pct_formatting() %>%
  adorn_ns(position = "front") %>%
  flextable() %>% # crée une flextable
  autofit() %>% # Garantit au maximum 1 ligne par cellule
  save_as_docx(path="min_tabell.docx") # Enregistre au format Word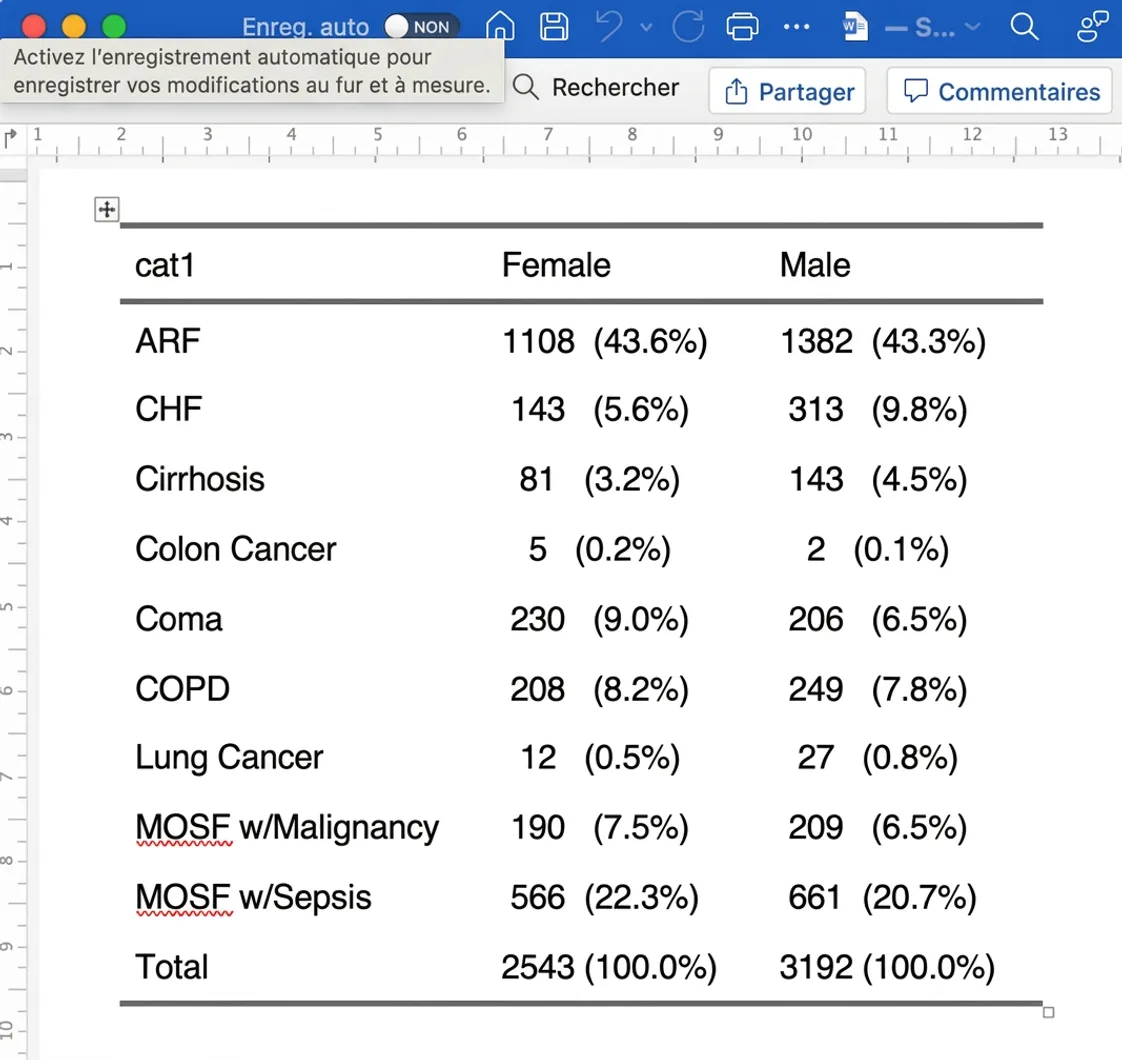
Crosstable
library(crosstable)Créons maintenant un tableau croisé de sex et death. Nous indiquons un motif particulier pour percent_pattern (inutile de le retenir) :
crosstable(data=rhc,
           # Variables à croiser
           cols=c(age, sex),
           # Quels pourcentages afficher ?
           total = "both",
           # Comment afficher les pourcentages ?
           percent_pattern="{n} ({p_row}/{p_col})") %>%
       # Mise en forme plus soignée
       as_flextable()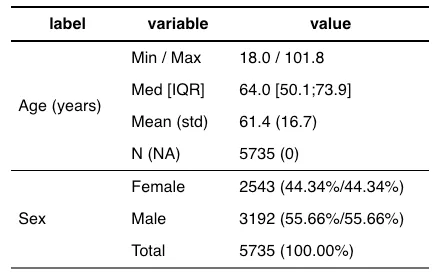
Comme vous le constatez, la fonction n'a pas produit de tableau croisé, car nous avons oublié l'argument by. Corrigeons cela :
crosstable(rhc,
           cols=c(age, sex),
           by=death,
           total = "both",
           percent_pattern="{n} ({p_row}/{p_col})") %>%
  as_flextable()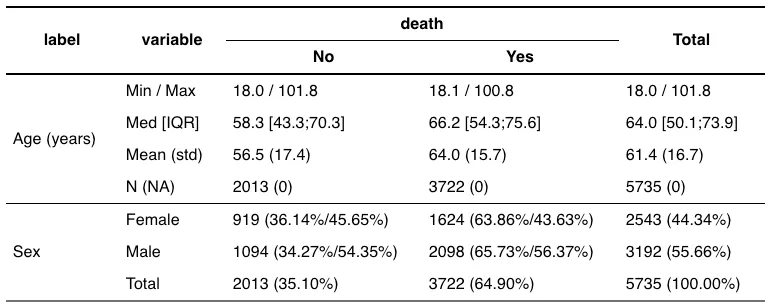
La fonction permet d'examiner toutes les variables stratifiées, par exemple, sur death. Pour examiner toutes les variables, on indique cols=everything() :
crosstable(rhc,
           cols=everything(),
           by=death,
           total = "both",
           percent_pattern="{n} ({p_row}/{p_col})") %>%
  as_flextable()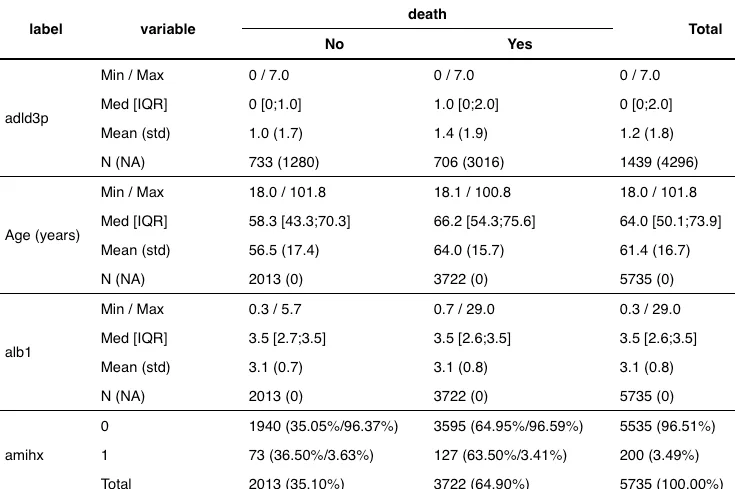
La figure est abrégée.