
Introduction
L'objectif de ce cours est de vous apprendre à gérer, analyser et présenter des données. La data science est un vaste domaine qui peut englober tous les types de schémas d'étude et d'analyses. Le développement fulgurant de la data science au cours des dernières années s'explique notamment par les facteurs suivants :
- Collecte et structuration de données à grande échelle. Grâce à la numérisation, les possibilités de collecter des données se sont multipliées, et nous collectons par conséquent des données à un rythme sans précédent. Les méthodes de stockage des données sont devenues considérablement plus efficaces. L'État, les collectivités territoriales, les régions, les entreprises et les organisations collectent aujourd'hui en continu d'importants volumes de données.
- Amélioration des logiciels et du matériel pour l'analyse des données. Le matériel et les logiciels dédiés à la data science ont évolué rapidement, en particulier dans les domaines de l'apprentissage automatique (machine learning, ML) et de l'intelligence artificielle (IA), où les progrès ont été vertigineux ces dernières années. Les logiciels sont aujourd'hui si performants et si flexibles qu'un débutant peut, en quelques semaines, commencer à utiliser les méthodes les plus avancées.
- Diffusion de la data science. Il existe désormais une quantité presque infinie de ressources pédagogiques en ligne sur la data science. Cette accessibilité a conduit un nombre croissant de personnes à apprendre à maîtriser ces outils. Les initiatives visant à enseigner la data science au grand public sont nombreuses, par exemple Elements of AI, dont l'objectif est d'initier tous les citoyens de Suède et de Finlande à l'intelligence artificielle (IA).
- Intérêt croissant pour les données. Les données sont devenues une ressource précieuse dans toutes les organisations, des administrations publiques aux petites et grandes entreprises. De ce fait, de plus en plus de personnes et d'organisations s'intéressent aux données.
graph TD;
    A(Data science)-->B(Médecine)
    A-->C(Finance);
    A-->D(Physique);
    A-->E(Chimie);
    A-->F(Biologie);
    A-->G(Société);
    A-->H(etc);
Figure 1.1 : La data science est présente dans toutes les disciplines.
La data science est agnostique
Vous pouvez utiliser ce livre pour la recherche médicale, les analyses financières ou la recherche en biologie, en chimie ou en sciences sociales. Le matériel, les logiciels et les méthodes d'analyse sont identiques dans tous les secteurs.
1.1 Prérequis
Une expérience préalable de la programmation est un atout, mais elle n'est pas nécessaire pour lire ce livre. N'importe qui peut apprendre à utiliser R efficacement. Plus vous maîtriserez l'écriture de code, plus votre travail sera facile. Votre aptitude à écrire du code sera une fonction presque linéaire du temps que vous consacrerez à l'apprendre.
1.2 Objectifs
Ce livre vous donne les bases nécessaires pour mener vous-même une étude. Vous ne deviendrez toutefois pas expert par la seule lecture de ce livre. Pour devenir compétent, il faut approfondir davantage, et ce livre vous fournit des références adaptées pour le faire. Vous constaterez néanmoins que ce livre vous mènera loin et qu'il vous donne les bases requises pour travailler avec les méthodes et les sujets qui vous concernent le plus.
Il est important de disposer de bons ouvrages de référence pour approfondir ses connaissances. Pour les méthodes statistiques et le machine learning, nous recommandons :
- Elements of Statistical Learning
- Fundamentals of Clinical Trials
- Applied Predictive Modelling
- Deep Learning with R
- Tidy Modeling with R
1.3 Programmer en R
R est un langage interprété (angl. interpreted language), ce qui signifie que vous devez saisir des commandes pour effectuer des opérations (par exemple des calculs). Programmer ou coder consiste à écrire des commandes. À votre demande, R tentera d'exécuter ces commandes.
1.3.1 Pourquoi programmer quand on peut cliquer ?
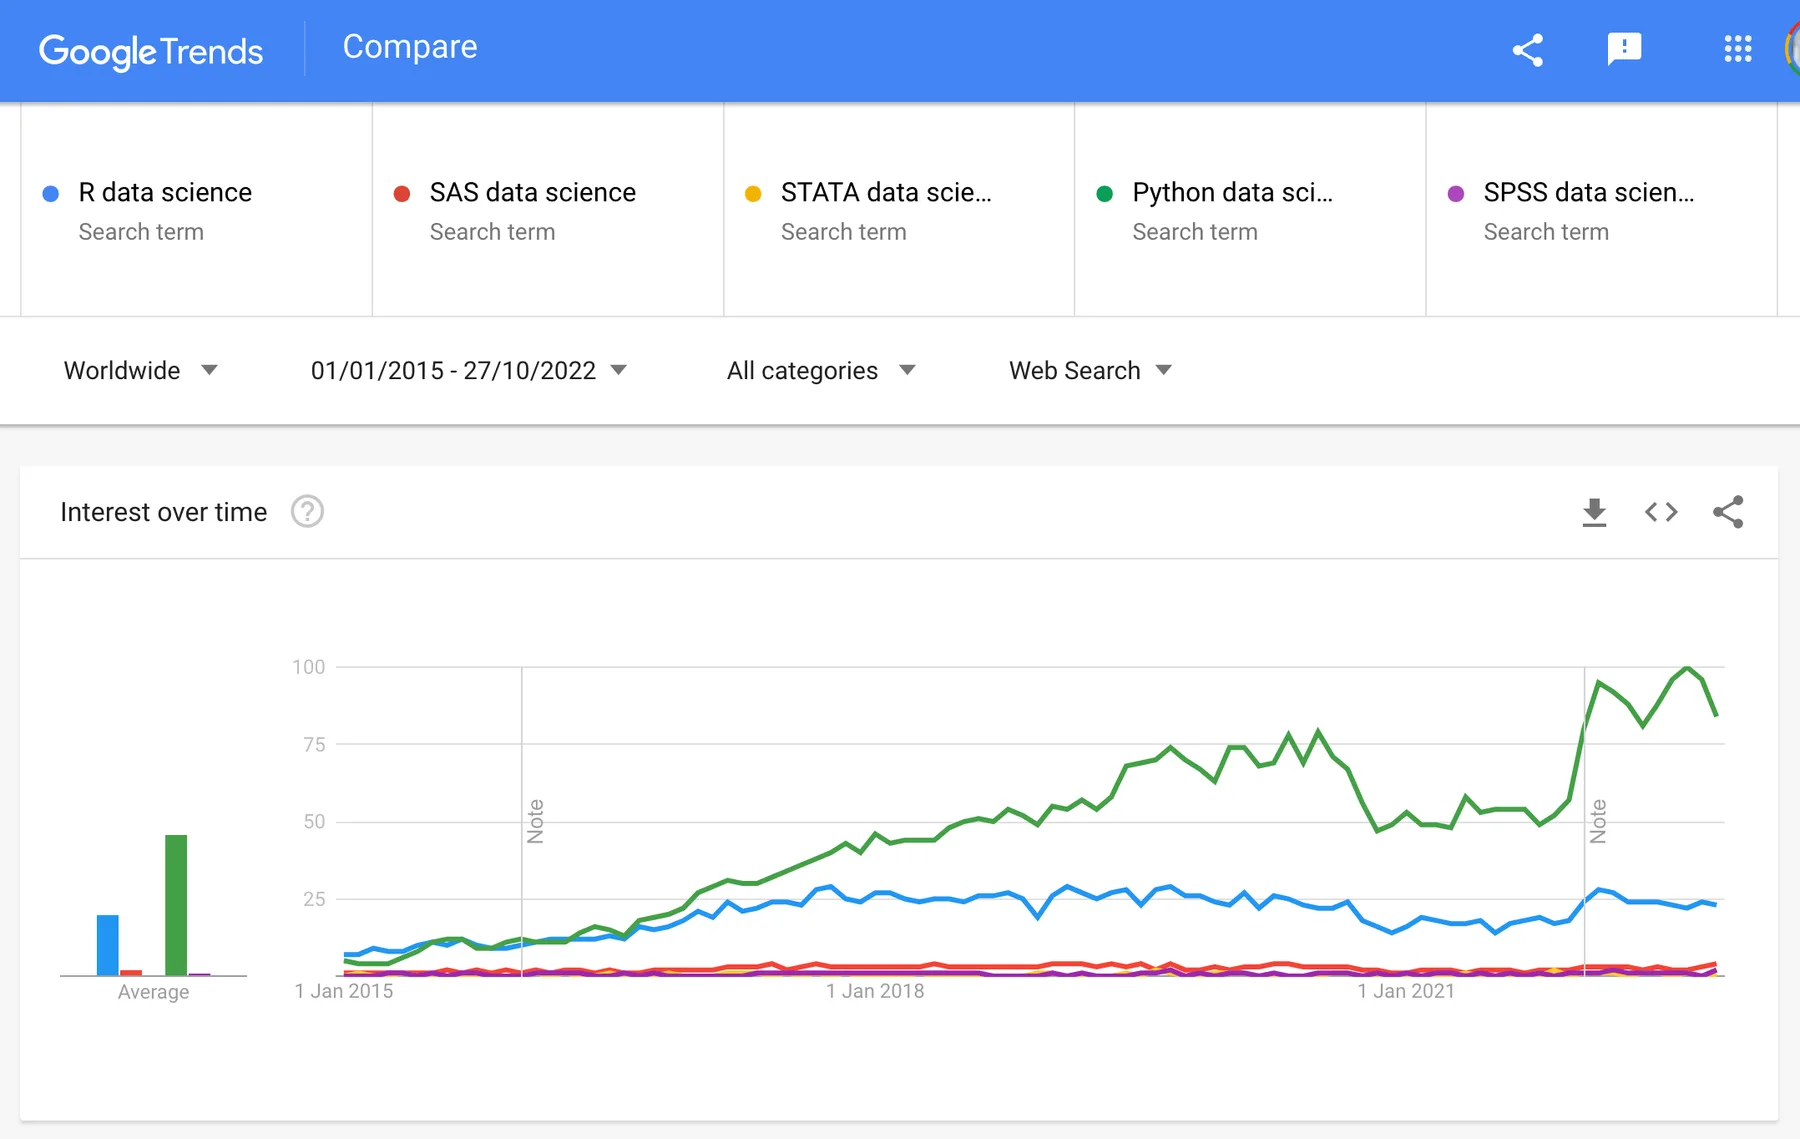
Il existe une différence fondamentale entre les langages interprétés et les logiciels dotés d'une interface graphique (par exemple SPSS, Excel, etc.). Même si des logiciels comme Excel et SPSS paraissent simples et pratiques, puisqu'il suffit de cliquer pour analyser, ils présentent des limites marquées. Il est par exemple difficile de garder la trace de tous les clics effectués, ce qui peut rendre la reproduction des résultats quasiment impossible. De plus, ces logiciels sont limités aux fonctions proposées par l'éditeur. Si vous utilisez R (ou Python), vous pouvez suivre votre code ligne par ligne et analyser précisément ce que vous avez fait. Vous pouvez à tout moment modifier vos commandes et obtenir immédiatement des résultats actualisés. Vous avez également accès aux méthodes et aux techniques les plus récentes, car des centaines de milliers d'experts travaillent chaque jour au développement de R (et de Python). R et Python sont gratuits et dominent aujourd'hui le marché de la recherche, de la data science et de la statistique (Figure 1.2). Il existe des langages commerciaux (par exemple SAS, Stata), mais leur utilisation diminue chaque année au profit de R et de Python.
1.4 Démarche de travail
La Figure 1.3 présente les étapes d'une étude type.
graph TD; A(Importer les données)--> B(Inspecter les données)--> C(Préparer et transformer les données)--> D(Visualiser les données)--> E(Décrire les données)--> F(Créer des modèles de prédiction)--> H(Communiquer les résultats)Figure 1.3 : Étapes d'une étude.
Pour analyser des données dans R, il faut d'abord les importer. Vous pouvez importer dans R pratiquement n'importe quel type de données (SAS, STATA, SPSS, Excel, CSV, etc.). Une fois les données importées, il convient de procéder à une inspection minutieuse. Cette inspection doit permettre de cerner la nature des colonnes et des lignes.
Pour les colonnes (les variables), cela comprend notamment :
- Identifier les types de variables présents et vérifier que R a correctement interprété le type de chaque variable : une variable numérique (par exemple le poids corporel) doit être interprétée comme numérique (numerical) par R afin d'éviter des analyses erronées.
- Identifier et ajuster les différentes modalités (levels) des variables catégorielles : les variables qui ne sont pas numériques sont le plus souvent des facteurs dans R (factor). Les modalités de chaque variable facteur doivent être examinées et ajustées si nécessaire.
- Déterminer la proportion de données manquantes (missing) pour chaque variable : les données manquantes posent problème dans presque toutes les analyses. Il est important d'évaluer l'ampleur du problème, ainsi que la possibilité d'y remédier et la manière de le faire.
- Décrire la distribution des variables : il convient de réaliser des descriptions simples de la distribution des variables (valeur maximale, valeur minimale, moyenne, médiane, etc.).
- Créer de nouvelles variables (colonnes).
Pour les lignes (les observations), cela comprend notamment :
- Déterminer si les lignes représentent des individus uniques.
- Déterminer si un même individu peut apparaître plusieurs fois dans les données.
Termes importants
- Visualisation : création de graphiques et de figures.
- Description : descriptions mathématiques simples des données, par exemple l'utilisation de moyennes et d'écarts-types pour décrire des distributions.
- Prédiction : utilisation d'un modèle pour faire une prévision concernant un critère de jugement ou une valeur. Un exemple de critère de jugement est le décès (oui/non), et un exemple de valeur est la perte de poids en kilogrammes. On peut prédire si un patient va survivre ou non, ou combien de poids une personne va perdre.
- Modèle de prédiction (modèle statistique) : les modèles de prédiction servent à (1) décrire les associations entre variables ou (2) faire des prédictions. Ils sont construits soit par analyse de régression classique, soit par apprentissage automatique. Tous les modèles constituent une description mathématique des données. Ils peuvent servir à estimer l'effet de variables (par exemple l'influence du cholestérol sur le risque d'infarctus du myocarde) ou à faire des prédictions (par exemple le niveau de risque de faire un infarctus du myocarde).
- Tidy data : données dans lesquelles les colonnes correspondent aux variables et les lignes aux observations.
- Data wrangling : traitement des données afin de pouvoir réaliser les analyses.
- La visualisation des données est presque toujours importante. Elle peut intervenir lors de l'inspection, de la description ou de la présentation des résultats finaux.
On construit aussi souvent des modèles statistiques (modèles de prédiction) pour étudier les associations entre variables ou pour créer des modèles de prédiction. Le plus souvent, un même modèle peut servir à la fois à étudier des associations et à faire des prédictions.
1.5 Data frame
Importer des données consiste tout simplement à ouvrir les données et à les rendre accessibles dans R. Les données désignent le plus souvent un tableau rectangulaire composé de lignes et de colonnes. Les lignes sont des observations (par exemple des patients) et les colonnes sont des variables. Dans R, ces tableaux sont appelés data frames, ce qui est souvent abrégé en df.
| Nom | Âge | Revenu | Niveau d'études | Cholestérol |
|---|---|---|---|---|
| Adam | 45 | 324211 | Université | 4,5 |
| Zara | 51 | 198765 | Primaire | 7,6 |
| John | 49 | 250643 | Lycée | 3,2 |
Exemple de data frame.
1.5.1 Autres types de données
Avec R, vous pouvez analyser des data frames, des photos, des illustrations, des enregistrements sonores et des vidéos. Ce livre s'adressant aux débutants, l'accent sera mis sur les data frames.
1.5.2 Logiciels
- R : R est un langage et un logiciel de traitement de données et de graphisme.
- RStudio : RStudio a été créé pour faciliter le travail dans R. À partir d'octobre 2022, RStudio change de nom pour devenir
Posit. Pour travailler avec R, il suffit de lancer RStudio. RStudio permet également de créer des rapports aux formats PDF, EPUB et HTML. - Package (angl. package) : vous pouvez étendre les fonctionnalités de R en installant des packages. Environ 16 000 packages sont disponibles.
1.6 À propos de R et de RStudio
R est un langage développé spécifiquement pour analyser et visualiser des données. R est extrêmement performant pour cet usage. Aucun autre langage n'est aussi efficace, flexible et polyvalent. R a été développé aux Bell Laboratories (anciennement AT&T, aujourd'hui Lucent Technologies) par John Chambers et ses collègues. L'installation standard de R s'accompagne de 16 000 packages supplémentaires, ce qui ouvre des possibilités considérables.
1.6.1 Installer R
Téléchargez R (version desktop) depuis le CRAN (The Comprehensive R Archive Network) : https://cloud.r-project.org.
- Télécharger et installer R. Choisissez le bon système d'exploitation.
- Installez-le comme d'habitude sur votre ordinateur.
1.6.2 Comment installer RStudio
RStudio est un IDE (integrated development environment, environnement de développement intégré), c'est-à-dire un programme qui facilite la programmation. RStudio permet de suivre plus facilement les scripts, les fichiers, les graphiques et les documents. Téléchargez RStudio ici : http://www.rstudio.com/download.
- Télécharger et installer RStudio. La version gratuite suffit amplement.
- Installez-le comme d'habitude sur votre ordinateur.
RStudio se présente comme le montre la Figure 1.4.
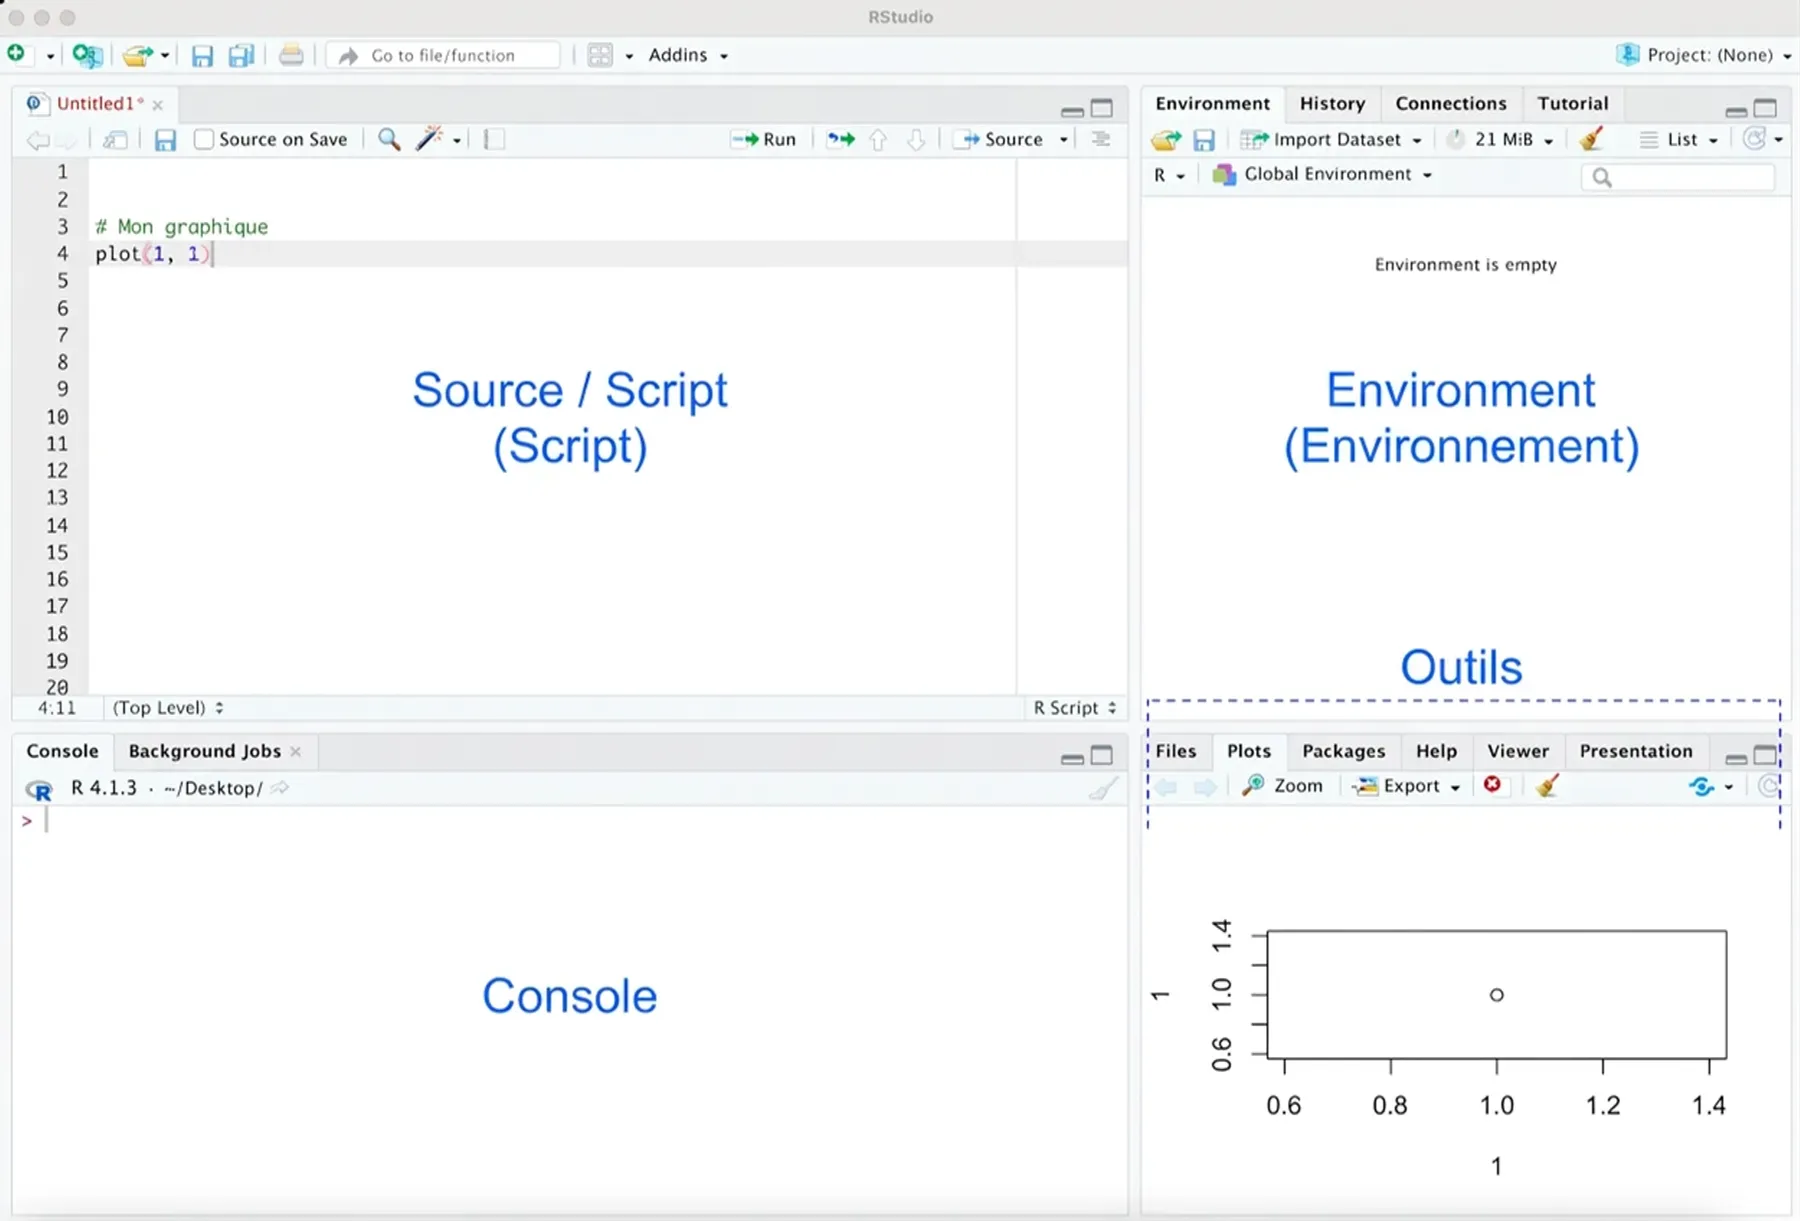
Notez dans la Figure 1.4 que RStudio comporte quatre fenêtres. En haut à gauche se trouve Source/Script, qui sert à écrire et à enregistrer du code (des scripts). C'est dans cette fenêtre que vous écrirez votre code. Sous Source/Script se trouve Console, qui peut servir à exécuter des commandes courtes. C'est aussi dans la Console que vous êtes informé de la bonne exécution (ou non) de votre script.
1.7 Exécuter du code dans R
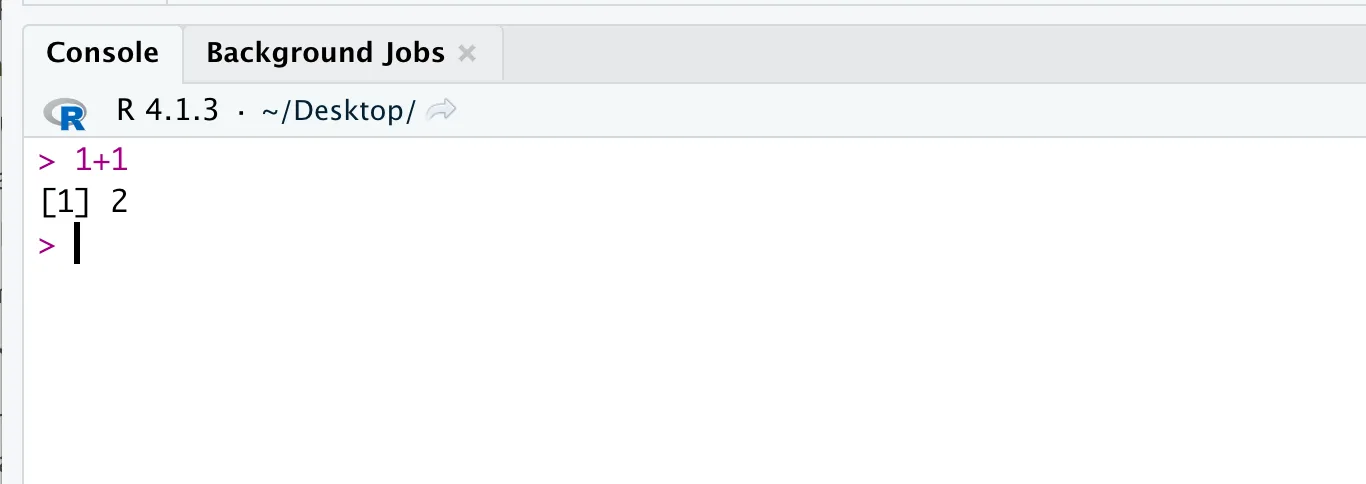
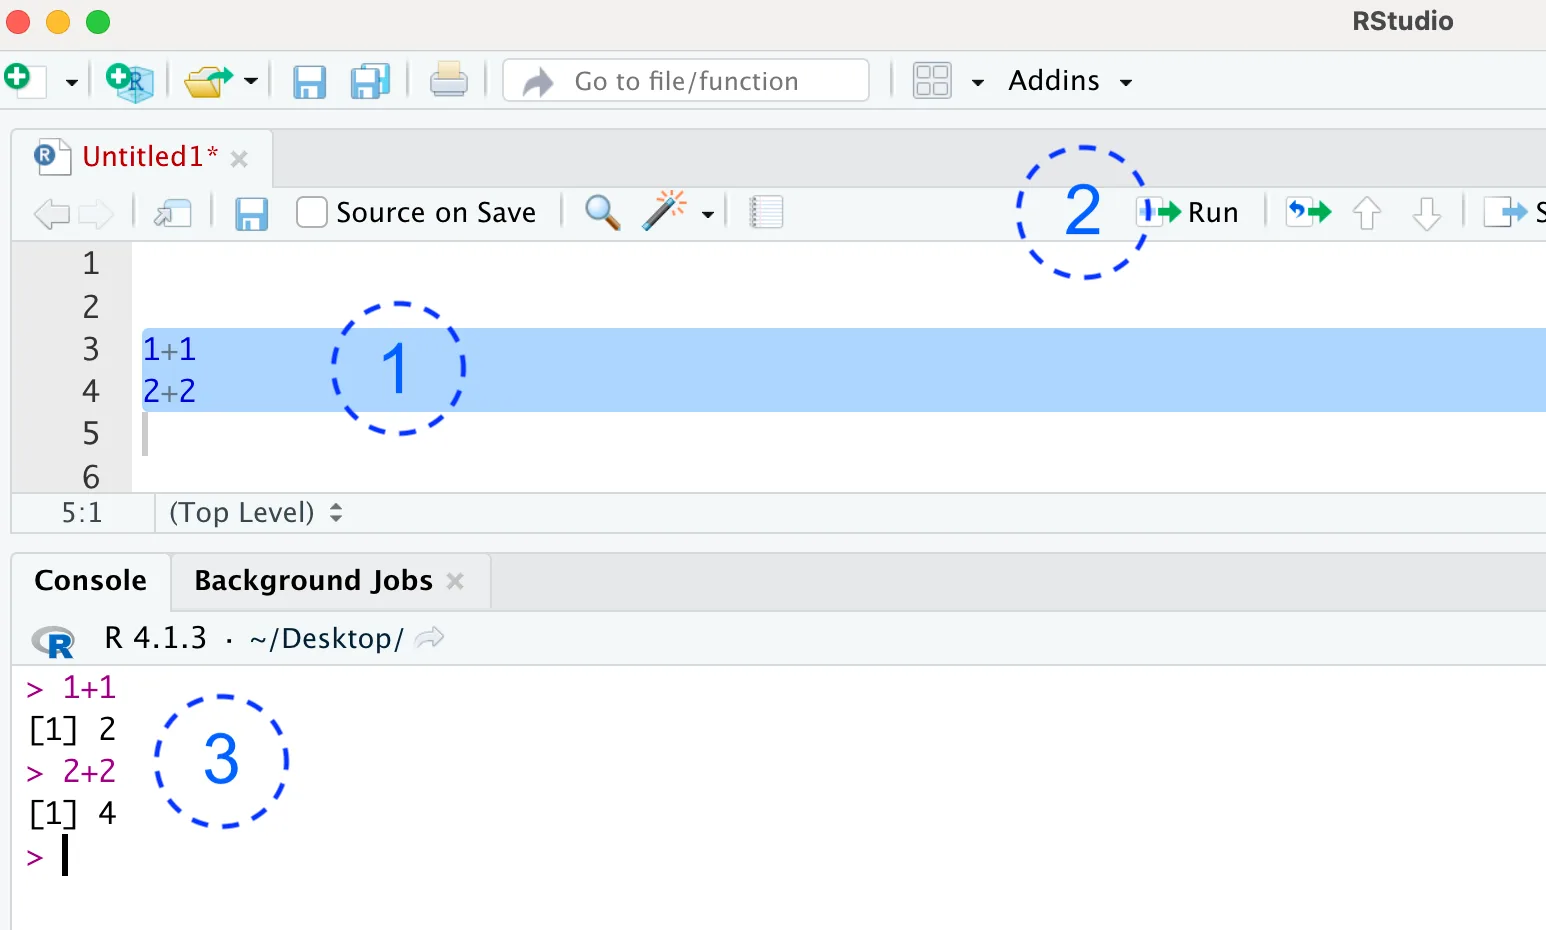
Pour exécuter du code dans la Console, vous pouvez taper votre commande sur la dernière ligne et appuyer sur Enter. La Figure 1.5 montre un exemple d'exécution de la commande 1+1.
Pour exécuter du code dans Source/Script, sélectionnez les lignes à exécuter et cliquez sur Run, en haut à droite de la fenêtre.
Comme le montre la Figure 1.4, R comporte deux autres fenêtres, à savoir Environment (Environnement) et Outils. Sous Environment, vous voyez tous les data frames et autres objets que vous créez et importez. Sous Outils, vous voyez plusieurs panneaux (File, Plots, Packages, Help, etc.). La Figure 1.7 montre que ces panneaux présentent vos fichiers, les graphiques que vous avez créés, les packages disponibles et la documentation d'aide de tous les packages et de toutes les fonctions.
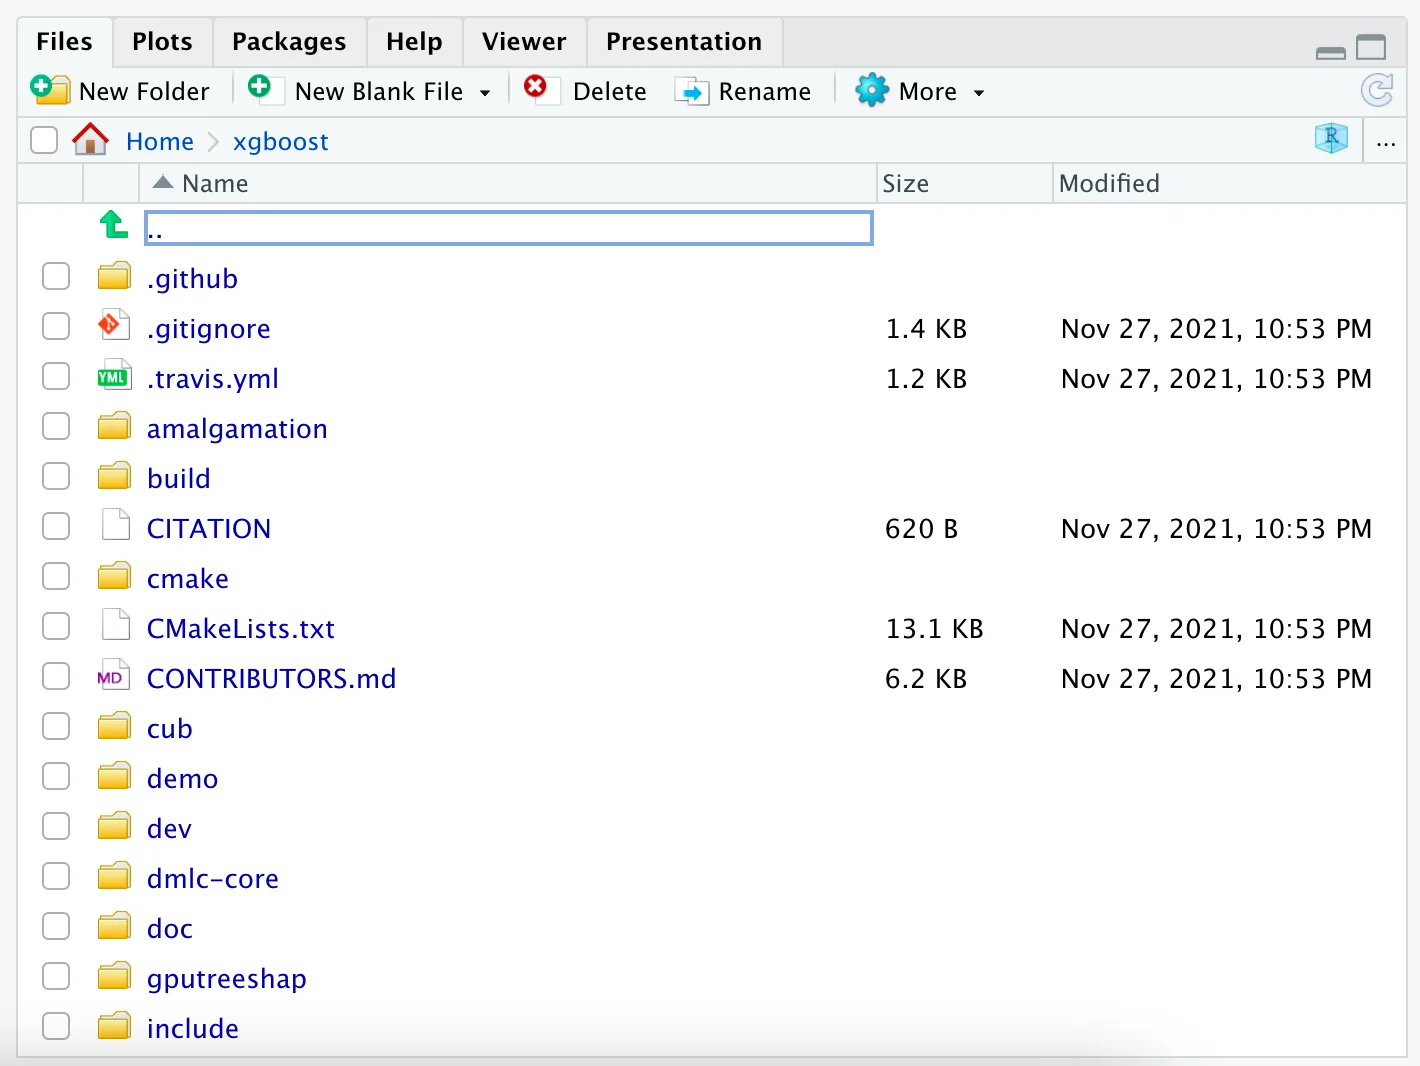
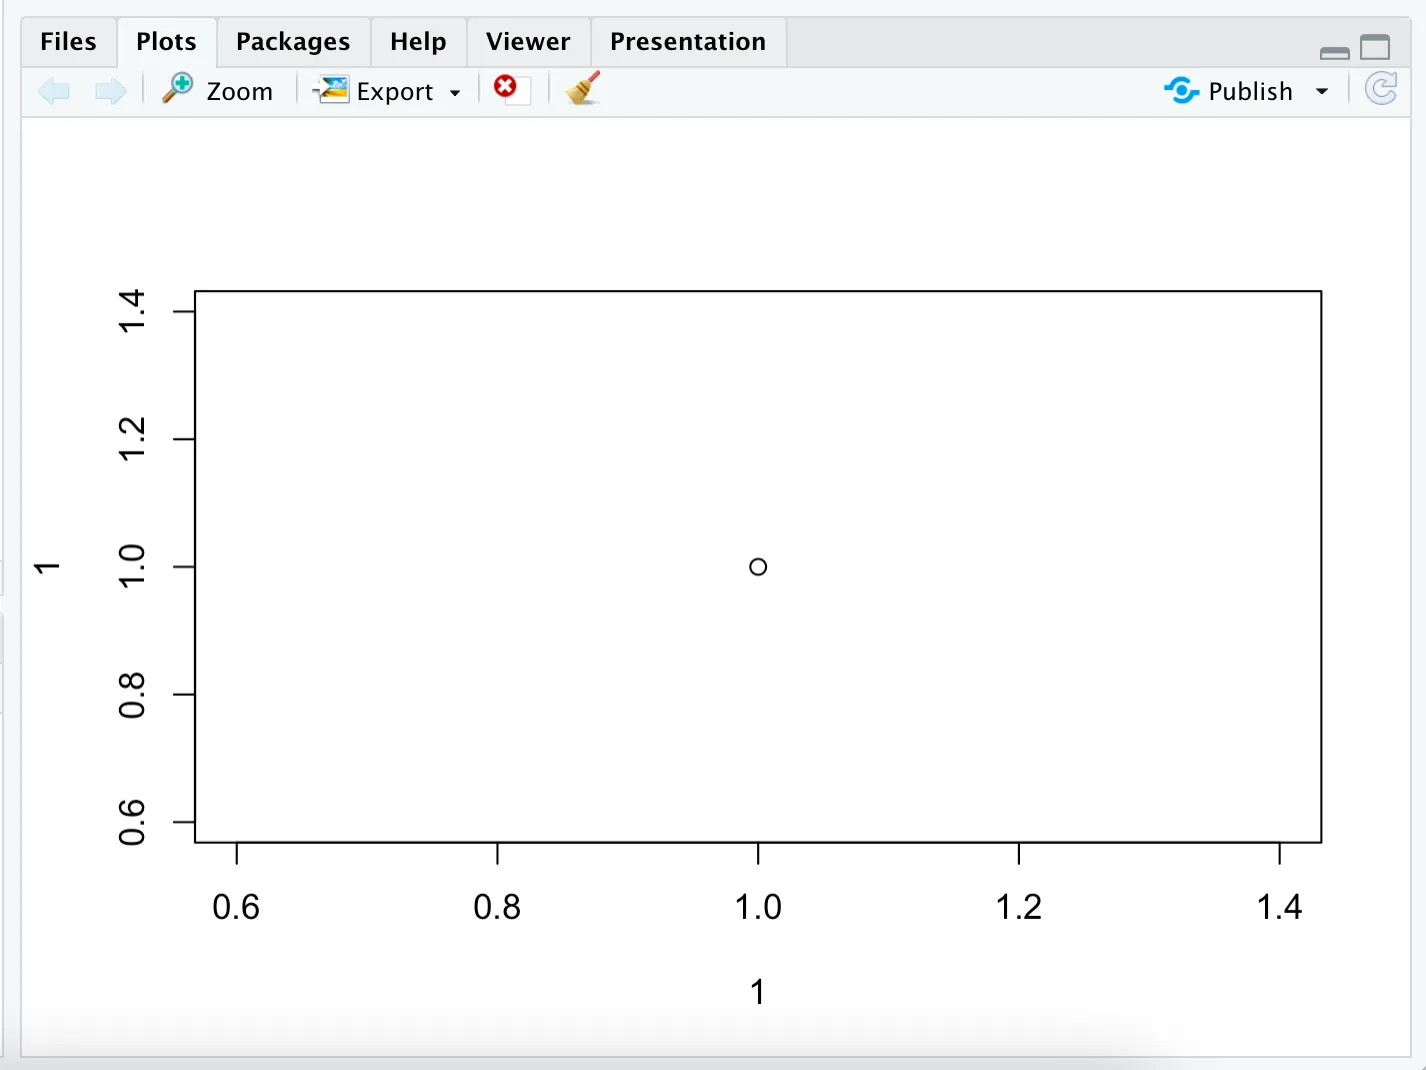
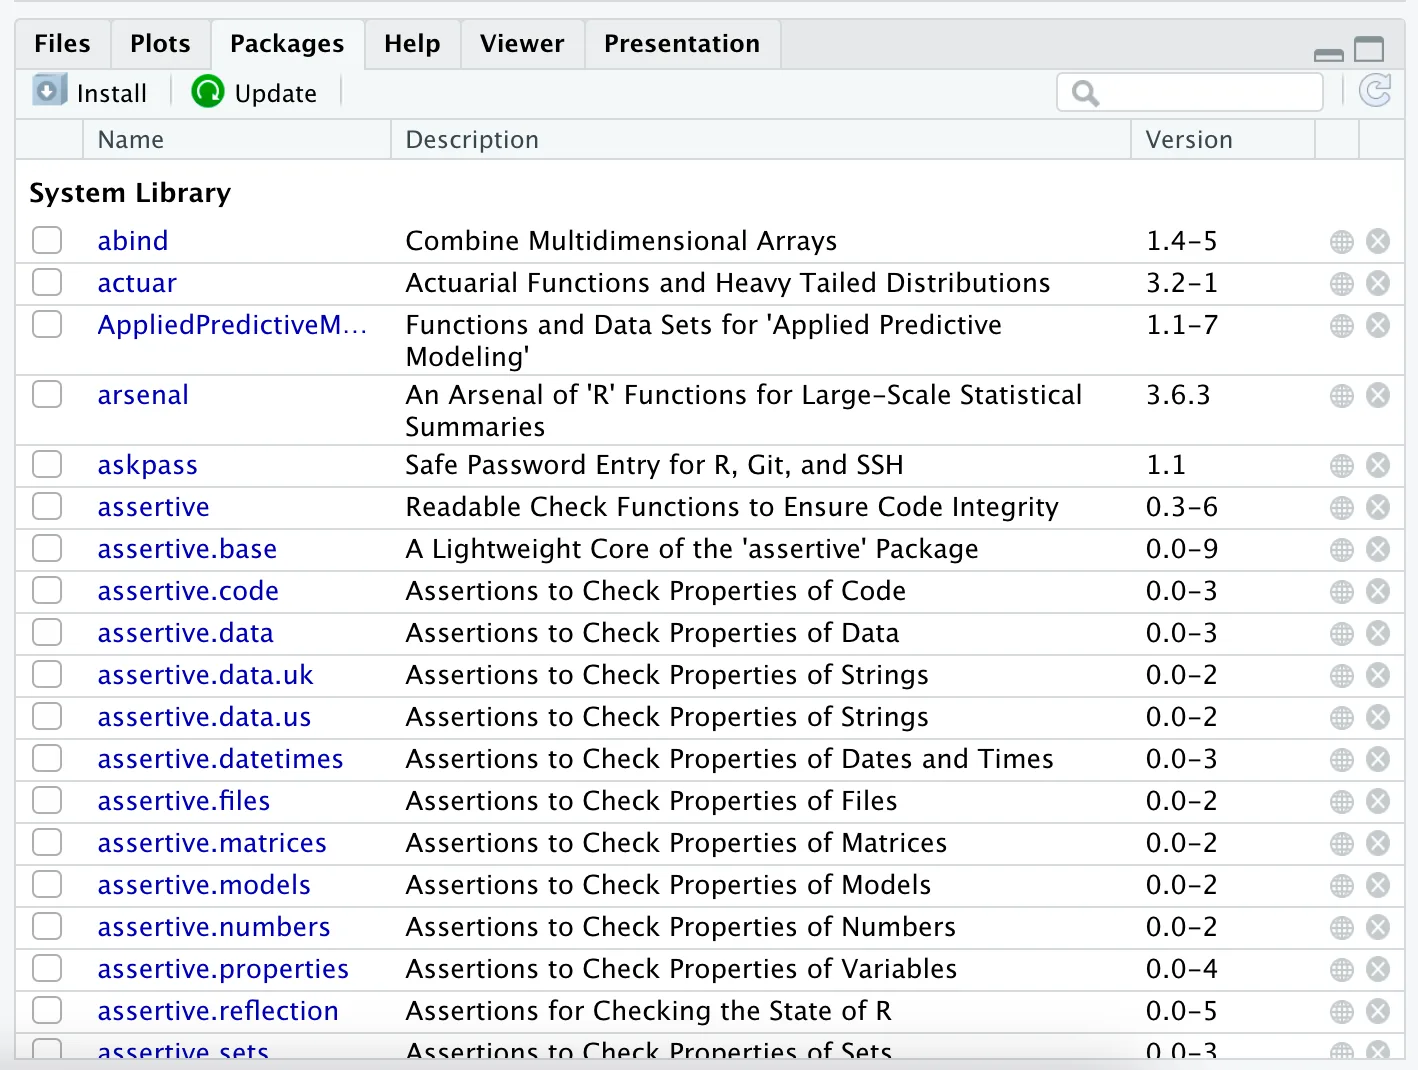
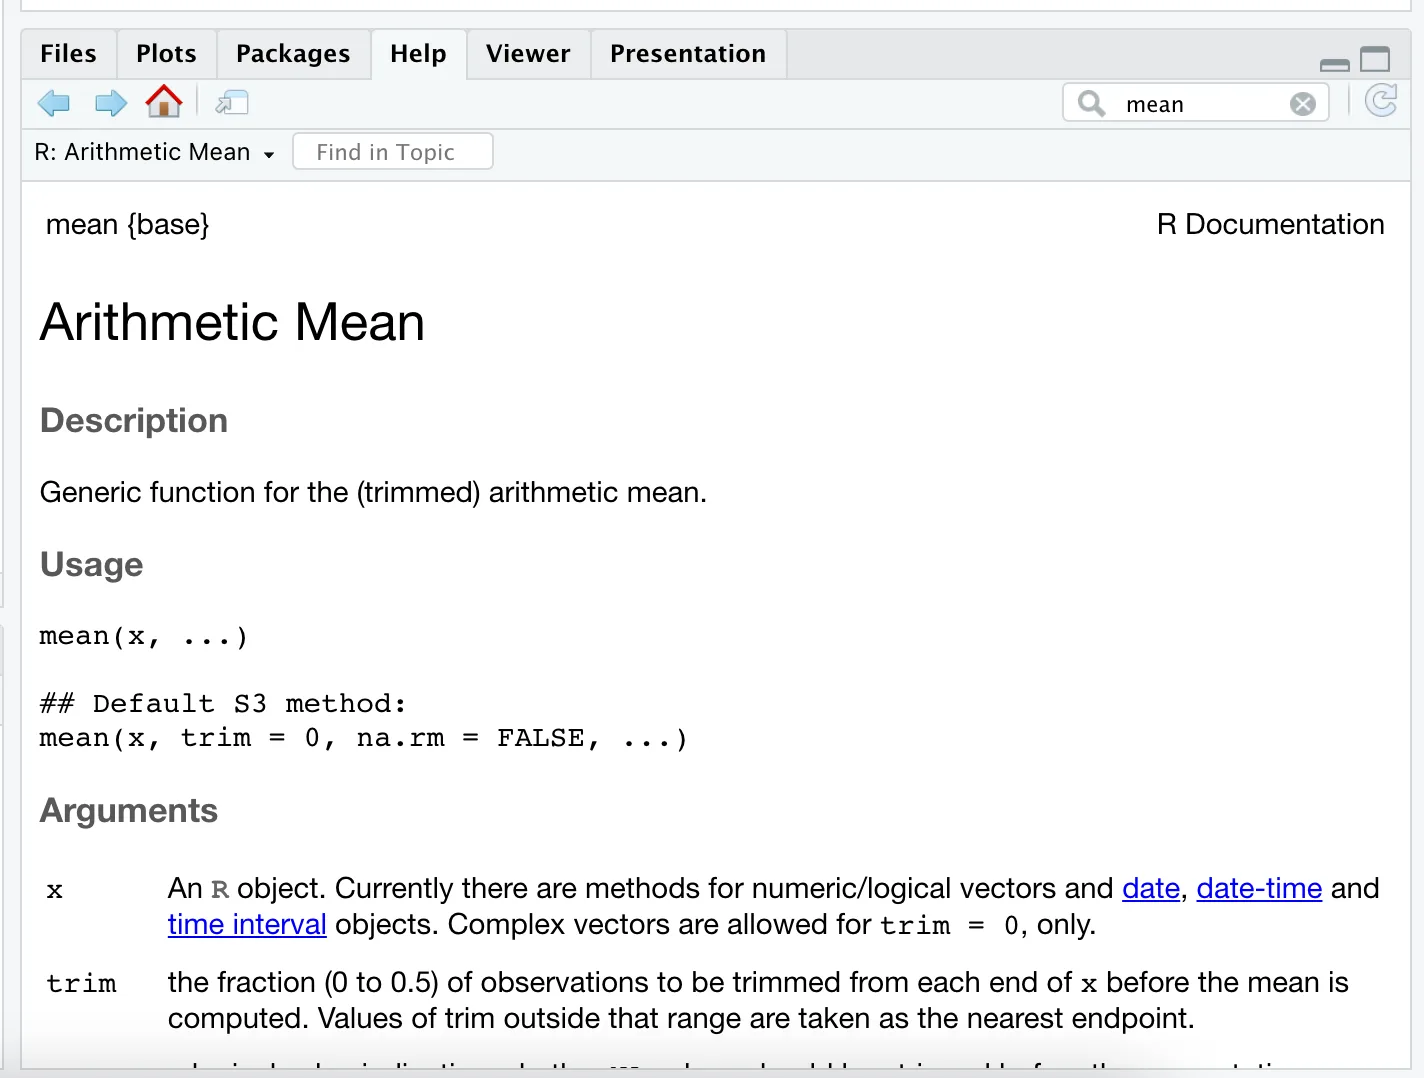
Figure 1.7 : Outils dans RStudio.