Données d'exercice
Dans ce chapitre, nous utilisons les données de gapminder. Gapminder a été fondé à Stockholm en 2005 et rassemble des statistiques mondiales portant notamment sur la santé, le développement économique et l'évolution démographique. Vous pouvez accéder aux données de Gapminder avec les commandes suivantes :
install.packages("gapminder")
library(gapminder)
gapminder
Gapminder contient les variables country, continent, year, lifeExp (espérance de vie), pop (effectif de la population) et gdpPercap (PIB par habitant). Ces données constituent nos données d'exercice.
| country | continent | year | lifeExp | pop | gdpPercap |
|---|---|---|---|---|---|
| Afghanistan | Asia | 1952 | 28.80100 | 8425333 | 779.4453 |
| Afghanistan | Asia | 1957 | 30.33200 | 9240934 | 820.8530 |
| Afghanistan | Asia | 1962 | 31.99700 | 10267083 | 853.1007 |
| Afghanistan | Asia | 1967 | 34.02000 | 11537966 | 836.1971 |
| Afghanistan | Asia | 1972 | 36.08800 | 13079460 | 739.9811 |
| Afghanistan | Asia | 1977 | 38.43800 | 14880372 | 786.1134 |
| Afghanistan | Asia | 1982 | 39.85400 | 12881816 | 978.0114 |
| Afghanistan | Asia | 1987 | 40.82200 | 13867957 | 852.3959 |
| Afghanistan | Asia | 1992 | 41.67400 | 16317921 | 649.3414 |
| Afghanistan | Asia | 1997 | 41.76300 | 22227415 | 635.3414 |
| Afghanistan | Asia | 2002 | 42.12900 | 25268405 | 726.7341 |
| Afghanistan | Asia | 2007 | 43.82800 | 31889923 | 974.5803 |
| Albania | Europe | 1952 | 55.23000 | 1282697 | 1601.0561 |
| Albania | Europe | 1957 | 59.28000 | 1476505 | 1942.2842 |
| Albania | Europe | 1962 | 64.82000 | 1728137 | 2312.8890 |
| Albania | Europe | 1967 | 66.22000 | 1984060 | 2760.1969 |
| Albania | Europe | 1972 | 67.69000 | 2263554 | 3313.4222 |
| Albania | Europe | 1977 | 68.93000 | 2509048 | 3533.0039 |
| Albania | Europe | 1982 | 70.42000 | 2780097 | 3630.8807 |
| Albania | Europe | 1987 | 72.00000 | 3075321 | 3738.9327 |
| Albania | Europe | 1992 | 71.58100 | 3326498 | 2497.4379 |
| Albania | Europe | 1997 | 72.95000 | 3428038 | 3193.0546 |
| Albania | Europe | 2002 | 75.65100 | 3508512 | 4604.2117 |
| Albania | Europe | 2007 | 76.42300 | 3600523 | 5937.0295 |
Le package ggplot2 repose sur une fonction principale : ggplot(). Nous commençons par écrire ggplot() en précisant l'argument data. Lorsque ce code est exécuté, nous obtenons la figure suivante.
ggplot(data=gapminder)
Nous ne voyons ci-dessus qu'un rectangle gris vide, car il manque deux composantes au graphique :
- Correspondance esthétique :
aes() - Composantes géométriques :
geom()
Nous poursuivons en ajoutant aes(), dans lequel nous indiquons que x correspond à year et y à pop. Le résultat reste un graphique vide, mais l'axe des abscisses et l'axe des ordonnées sont désormais spécifiés :
ggplot(data=gapminder,
       aes(x=year,
           y=pop))
Le graphique est vide parce qu'il lui manque geom(), qui définit les composantes géométriques. Nous ajoutons geom_points(), qui précise que nous voulons voir des points sur le graphique :
ggplot(data=gapminder,
       aes(x=year,
           y=pop)) +
  geom_point()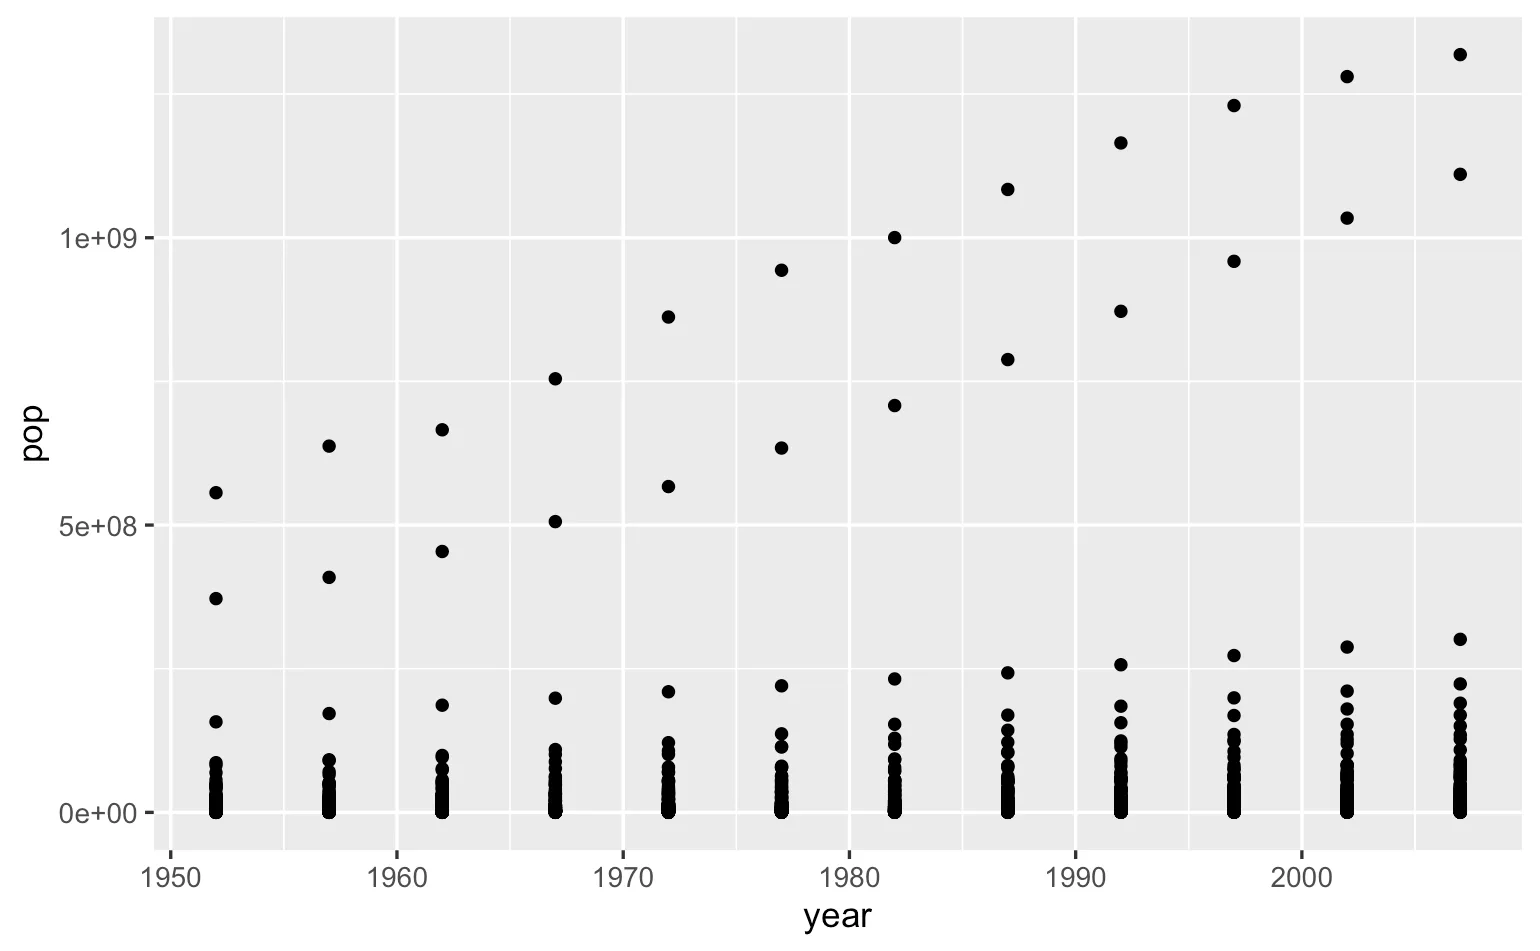
Autrement dit, dans ggplot(), on spécifie une source de données et une correspondance esthétique (aes()) comprenant notamment l'axe des abscisses et l'axe des ordonnées, puis on ajoute des couches de composantes géométriques (par exemple geom_point()). Ainsi, geom_point() a hérité de la correspondance esthétique définie dans ggplot() !
Labels (étiquettes)
Les étiquettes clarifient le contenu du graphique. Le terme anglais est labels, que nous utiliserons désormais ici aussi. Les labels sont définis avec la fonction labs(). Vous pouvez définir des labels pour l'axe des abscisses, l'axe des ordonnées, le titre, le sous-titre, la légende de la figure, etc. En voici un exemple :
ggplot(data=gapminder,
       aes(x=year,
           y=pop)) +
  geom_point() +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")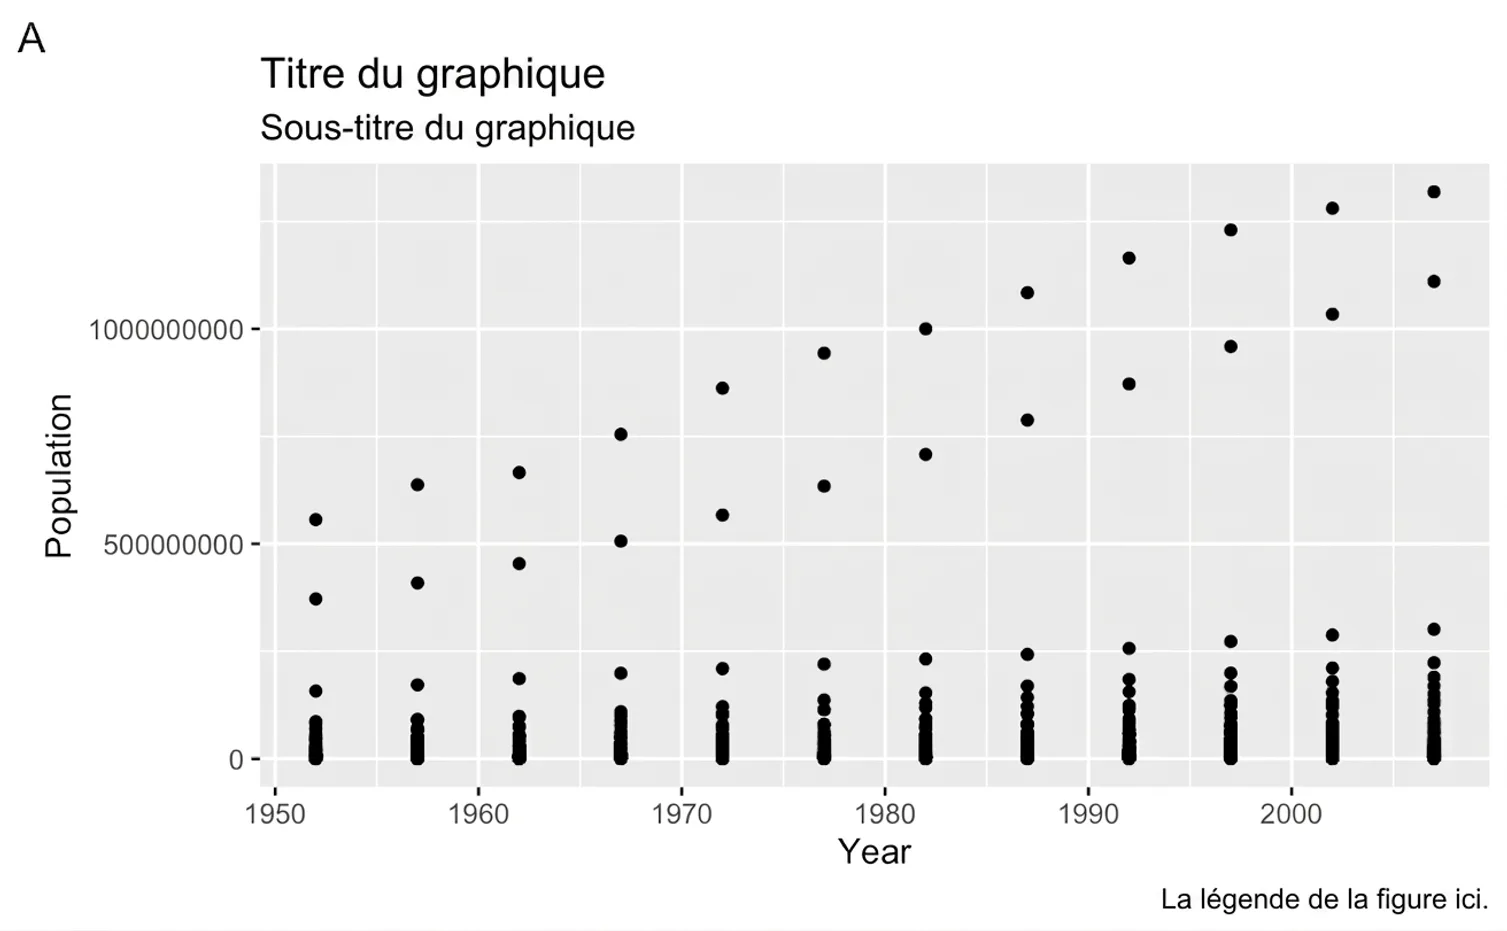
Le code commence à compter quelques lignes. Pour indiquer clairement ce qui est nouveau dans chaque bloc de code, nous le signalerons désormais par le commentaire #NYTT.
Désactiver la notation scientifique
Observez l'axe des ordonnées du graphique précédent. Les valeurs sont présentées en notation scientifique, qui s'active pour les nombres très grands ou très petits. Vous pouvez la désactiver avec la commande :
options(scipen=999)
Comme indiqué plus haut, geom_point() hérite de la correspondance esthétique (aes()) de ggplot(). Nous pouvons toutefois remplacer cette correspondance en spécifiant aes() dans geom_point(). Dans ce cas, geom_point() n'héritera pas de la correspondance. Le graphique suivant est donc identique au précédent :
ggplot(data=gapminder) +
  # NYTT
  geom_point(aes(x=year,
                 y=pop)) +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")
Définir la correspondance esthétique tout en haut présente l'avantage de ne pas avoir à la répéter dans chaque geom().
Colorons les points selon le continent auquel ils appartiennent. Pour cela, on précise color=continent dans aes() :
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           # NYTT
                           color=continent)) +
  geom_point() +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")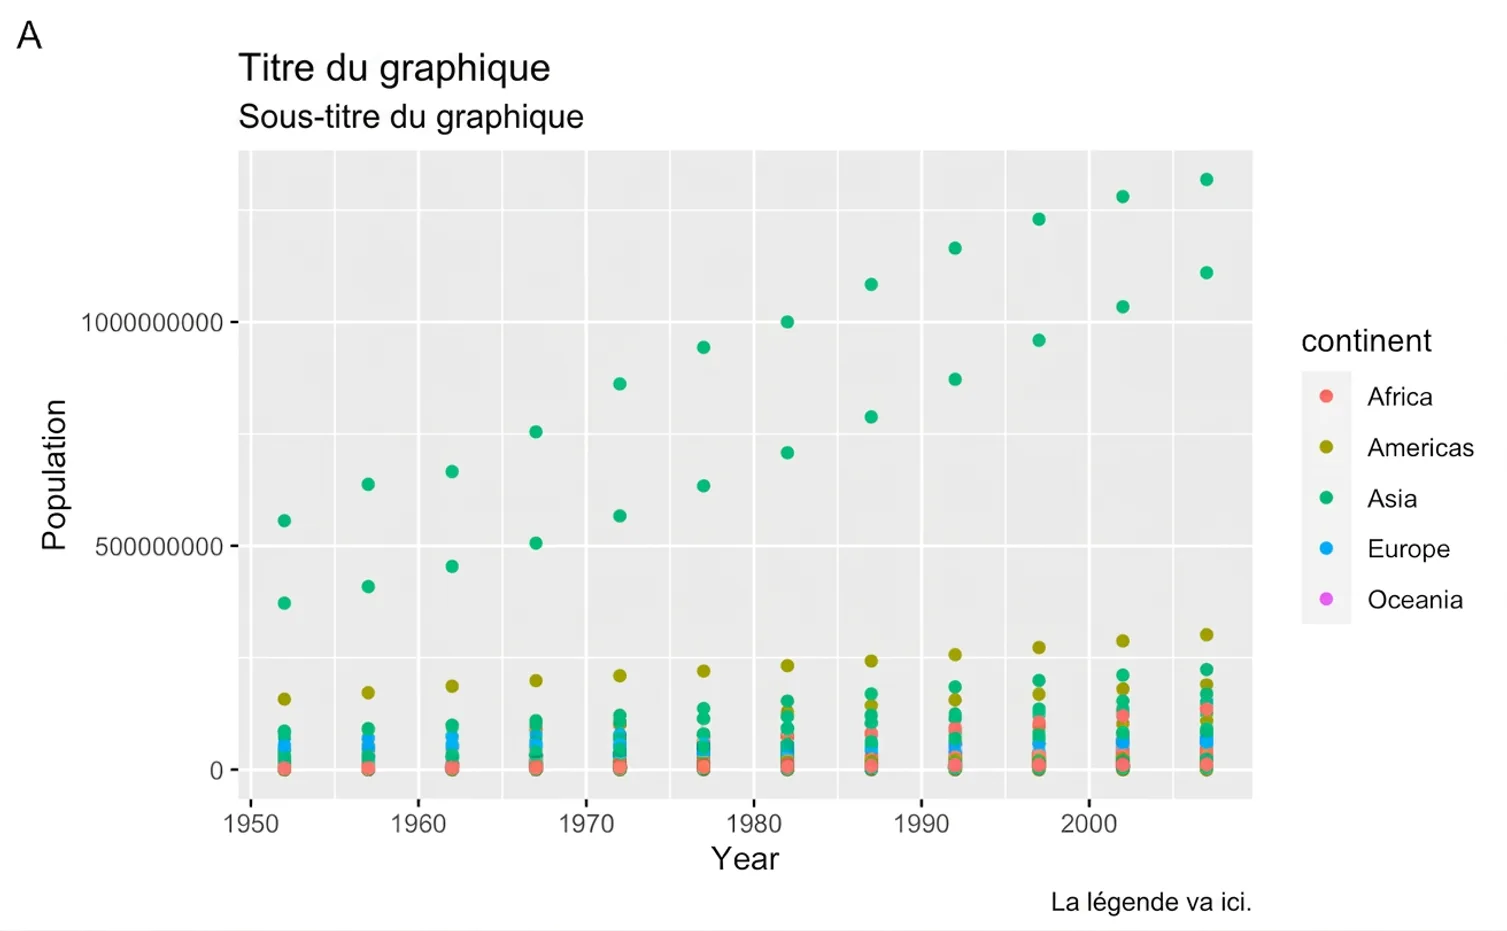
À droite du graphique figure le codage couleur, dont le label « continent » doit être ajusté. On peut définir ce label dans labs() avec l'argument color.
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  geom_point() +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.",
       # NYTT
       color="Kontinent")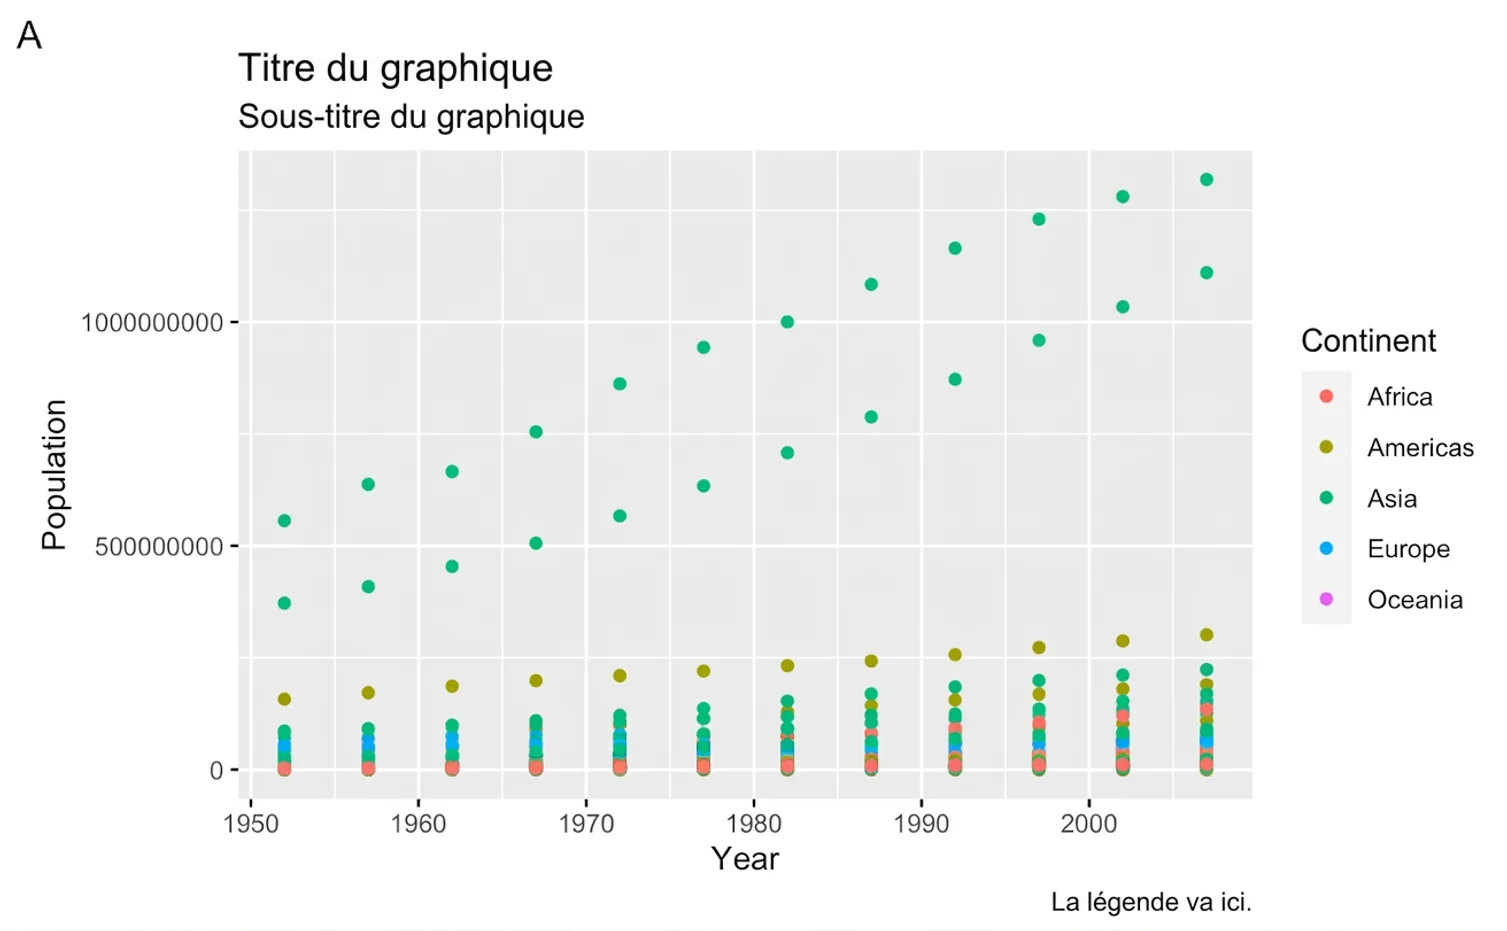
Gapminder contient plusieurs lignes pour chaque pays. À l'étape suivante, nous allons additionner l'effectif de la population de chaque continent pour chaque année civile. Pour ce faire, nous utilisons dplyr de la manière suivante :
gapminder_summary <- gapminder |>
  # Grouper par continent et year
  group_by(continent, year) |>
  # Calculer la somme de pop (pour chaque continent et chaque année)
  summarise(population = sum(pop)) |>
  # Désactiver le regroupement dans le data frame
  ungroup()

## Afficher les données
gapminder_summary| continent | year | population |
|---|---|---|
| Africa | 1952 | 237640501 |
| Africa | 1957 | 264837738 |
| Africa | 1962 | 296516865 |
| Africa | 1967 | 335289489 |
| Africa | 1972 | 379879541 |
| Africa | 1977 | 433061021 |
| Africa | 1982 | 499348587 |
| Africa | 1987 | 574834110 |
| Africa | 1992 | 659081517 |
| Africa | 1997 | 743832984 |
| Africa | 2002 | 833723916 |
| Africa | 2007 | 929539692 |
| Americas | 1952 | 345152446 |
| Americas | 1957 | 386953916 |
| Americas | 1962 | 433270254 |
| Americas | 1967 | 480746623 |
| Americas | 1972 | 529384210 |
Calculons la population totale de chaque continent pour chaque année civile :
ggplot(gapminder_summary,
       aes(x=year,
       y=population,
       color=continent)) +
  geom_point()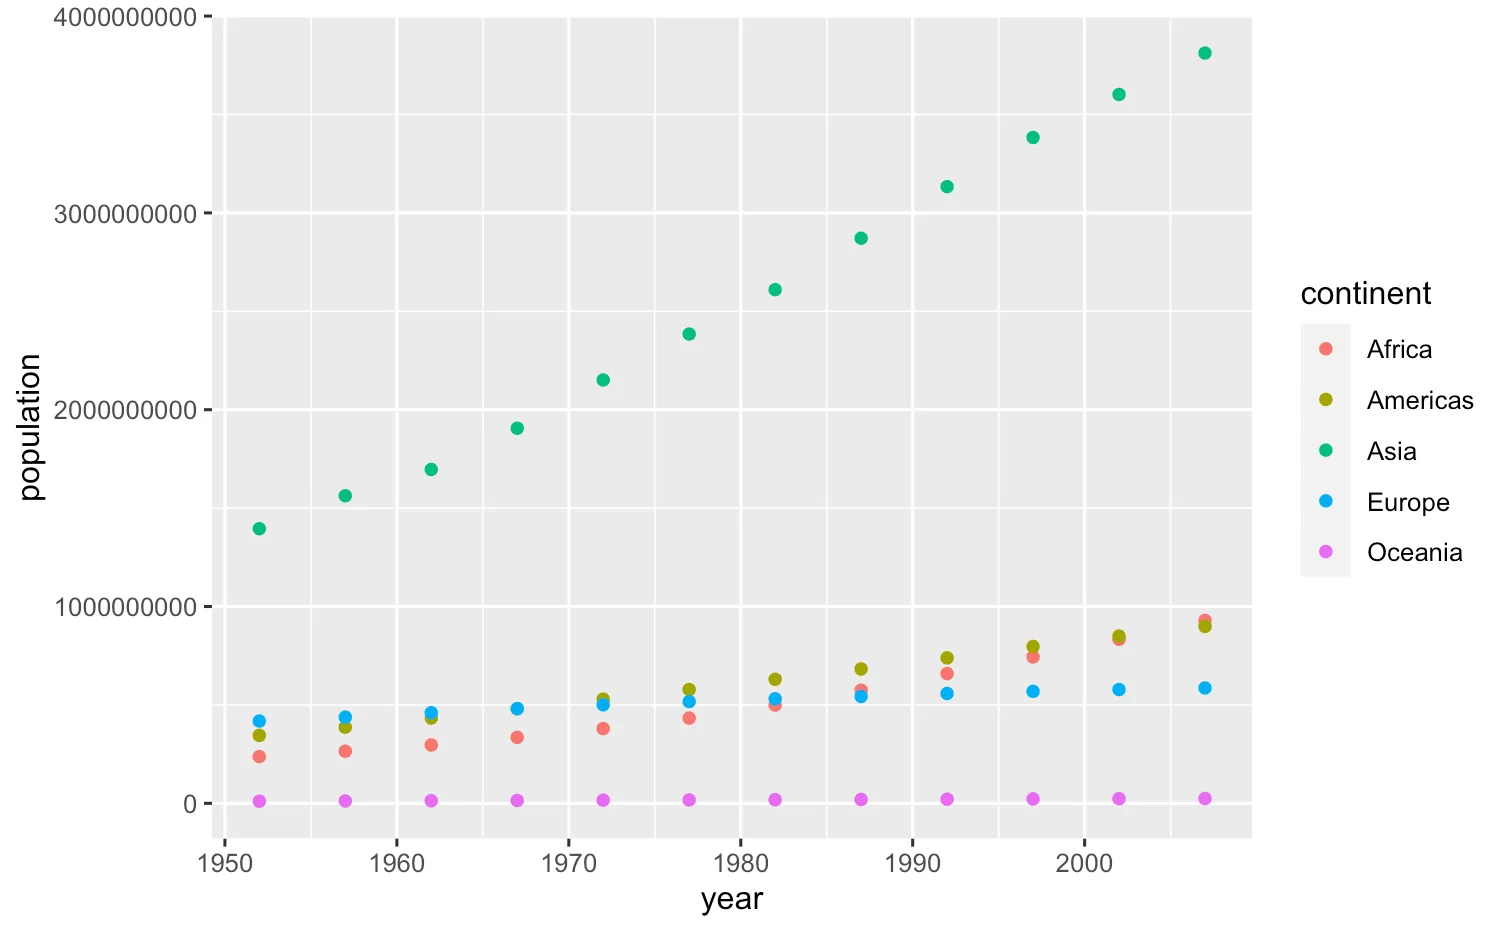
Nous ajoutons une ligne entre les points pour mieux visualiser la tendance :
ggplot(gapminder_summary,
       aes(x=year, y=population, color=continent)) +
  geom_point() +
  # NYTT
  geom_line()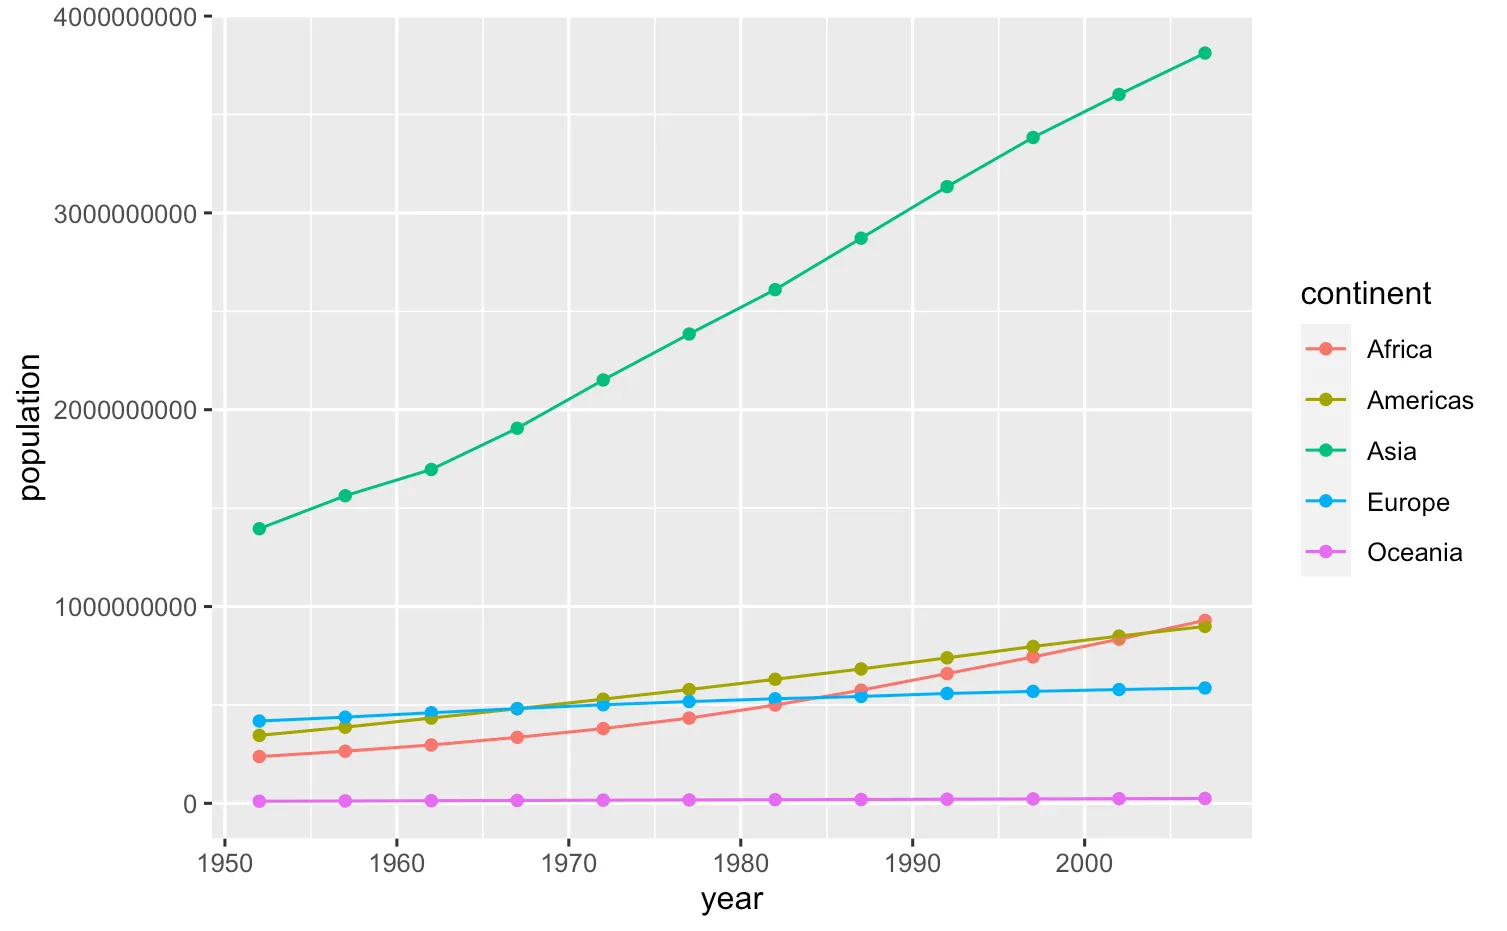
Avec geom_text(), vous pouvez ajouter du texte. Nous ajoutons maintenant geom_text() pour afficher l'effectif de la population à chaque point de données. geom_text() possède lui aussi une correspondance esthétique. Ici, nous indiquons uniquement l'argument label, que nous définissons comme la variable population. Les valeurs x et y de geom_text() seront héritées de ggplot().
ggplot(gapminder_summary,
       aes(x=year, y=population, color=continent)) +
  geom_point() +
  geom_line() +
  # NYTT
  geom_text(aes(label=population))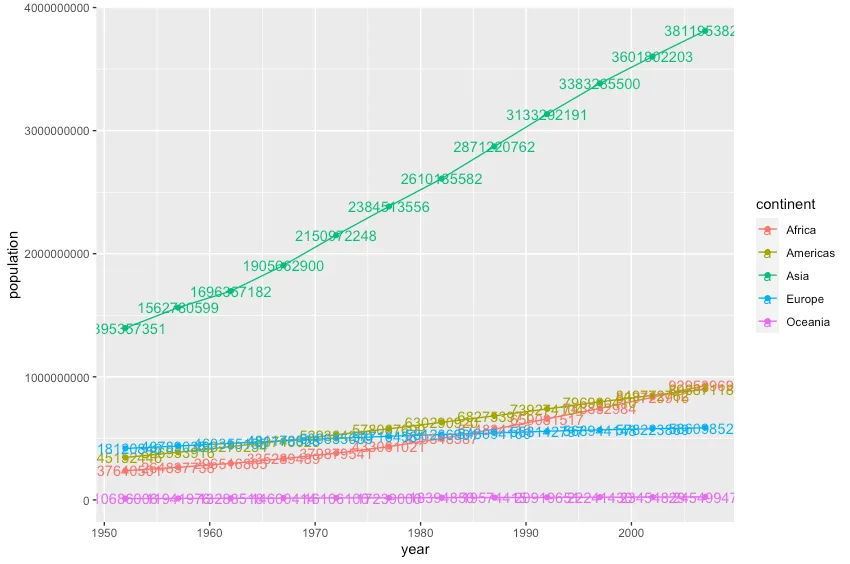
Nous répétons exactement la même procédure, mais avec geom_label() au lieu de geom_text(). Avec geom_label(), le texte reçoit un fond qui le rend plus visible :
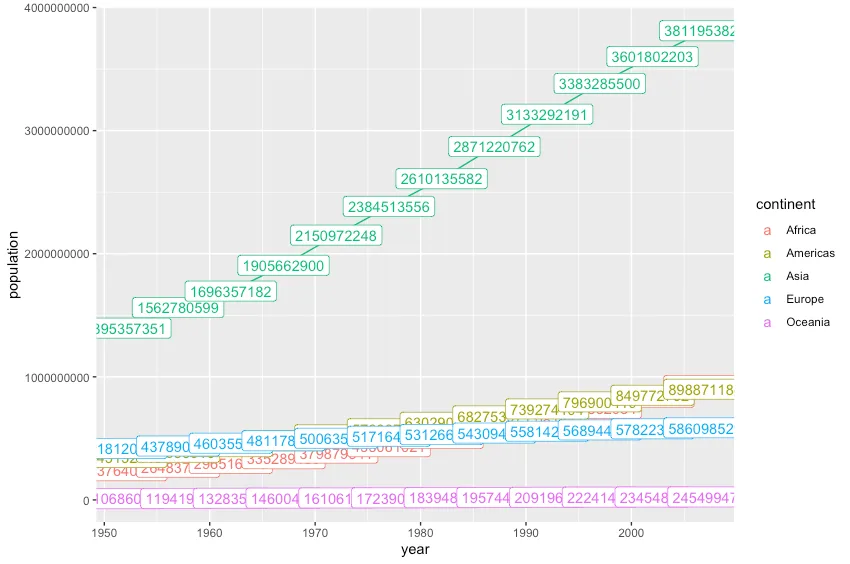
Les deux graphiques ci-dessus ne sont pas optimaux, car les labels sont placés trop près les uns des autres. Il nous faut une fonction capable de séparer automatiquement les labels. Elle existe dans le package ggrepel, dont la fonction geom_text_repel() sépare automatiquement le texte. Le package écarte les points de données qui ne peuvent pas être visualisés de manière raisonnable. Le résultat est en général satisfaisant :
install.packages("ggrepel")
library(ggrepel)ggplot(gapminder_summary,
aes(x=year, y=population, color=continent)) +
geom_point() +
geom_line() +
# NYTT
geom_text_repel(aes(label=population))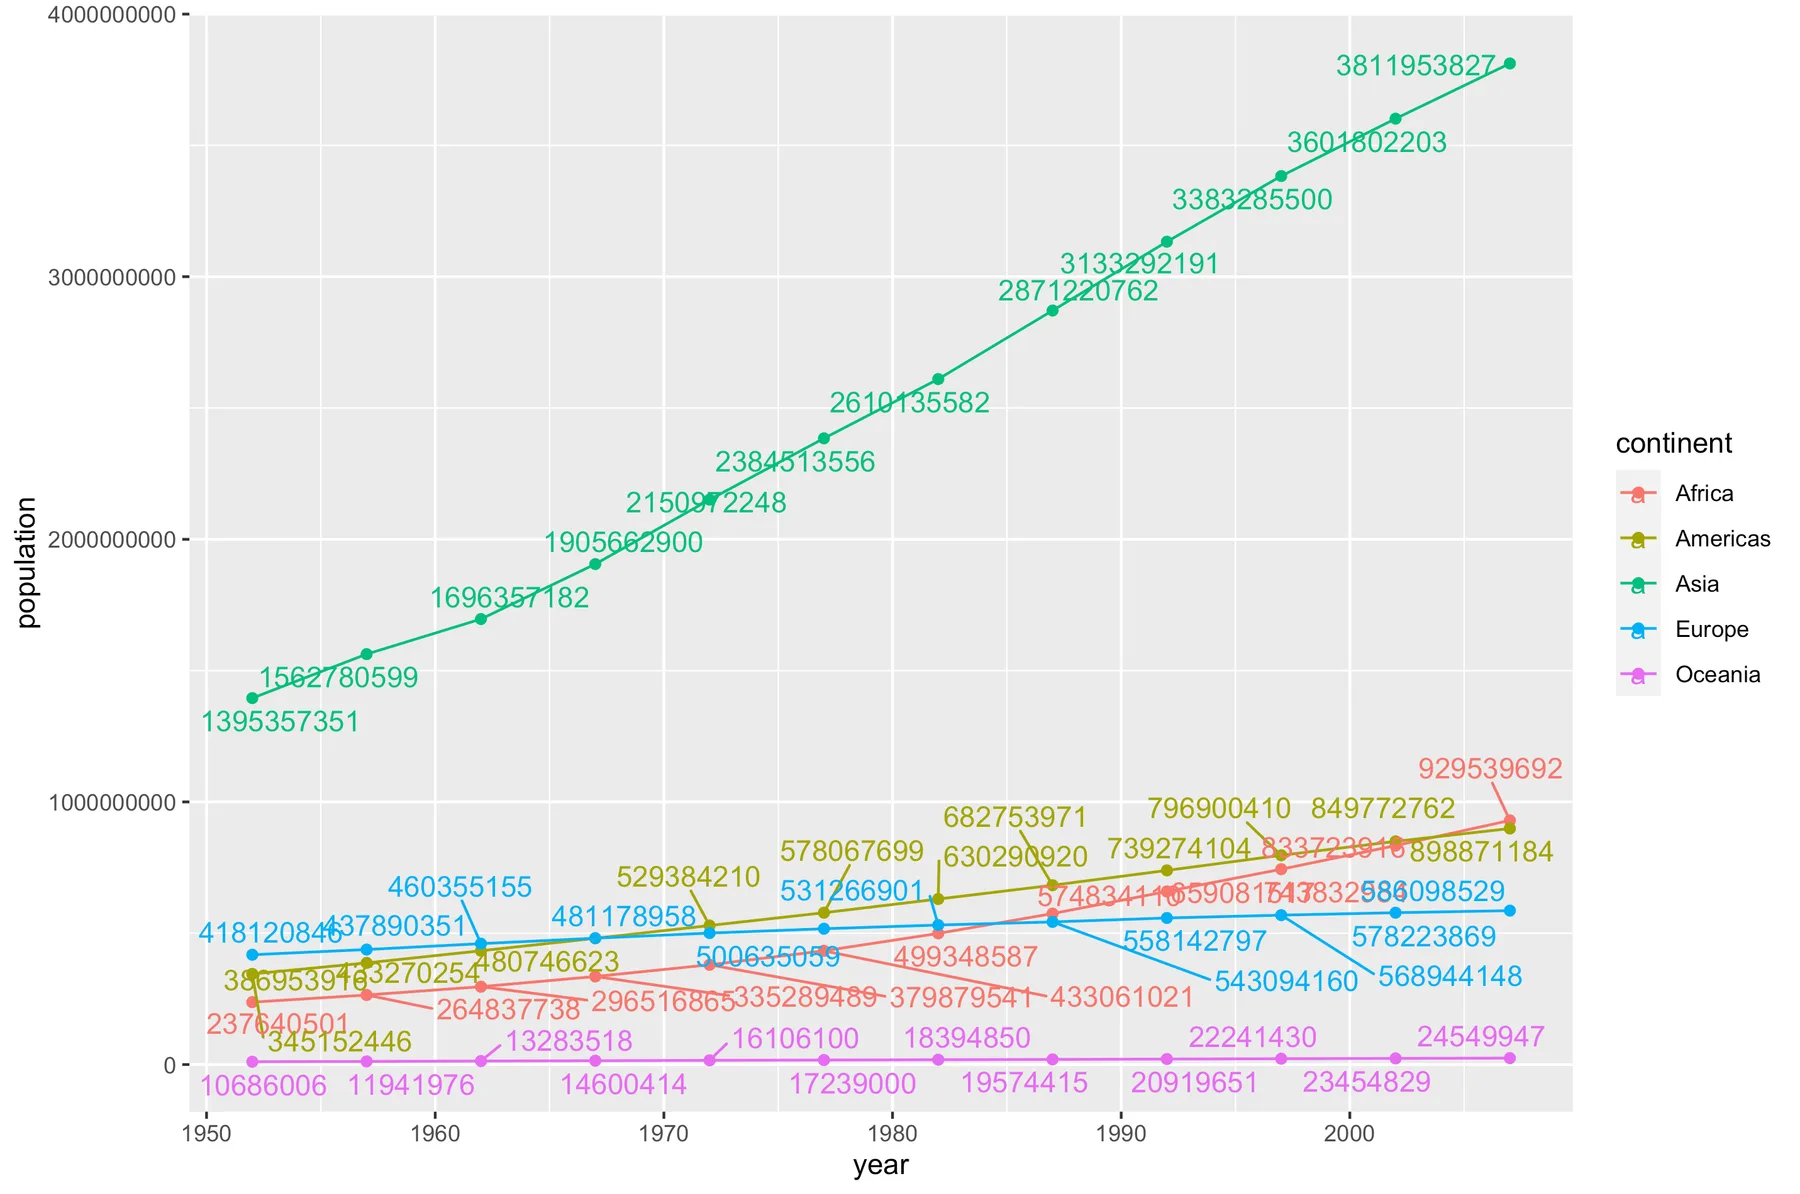
Le résultat reste peu lisible. Il serait peut-être suffisamment informatif de ne présenter les chiffres que pour la première et la dernière année. Pour cela, on peut calculer le nombre maximal et le nombre minimal d'habitants de chaque continent. Ces calculs sont effectués et stockés dans les objets max_population et min_population, qui sont ensuite également utilisés dans ggplot() :
## Calcule la population la plus élevée de chaque continent
max_population <- gapminder_summary %>%
  group_by(continent) %>%
  arrange(continent, desc(population)) %>%
  distinct(continent, .keep_all = T)

## Calcule la population la plus faible de chaque continent
min_population <- gapminder_summary %>%
  group_by(continent) %>%
  arrange(continent, population) %>%
  distinct(continent, .keep_all = T)

## Visualise
ggplot(gapminder_summary,
       aes(x=year, y=population, color=continent)) +
  geom_point() +
  # NYTT
  # Texte pour les valeurs maximales
  geom_label_repel(data=max_population,
                  aes(x=year, y=population, color=continent, label=population)) +
  # NYTT
  # Texte pour les valeurs minimales
  geom_label_repel(data=min_population,
                  aes(x=year, y=population, color=continent, label=population))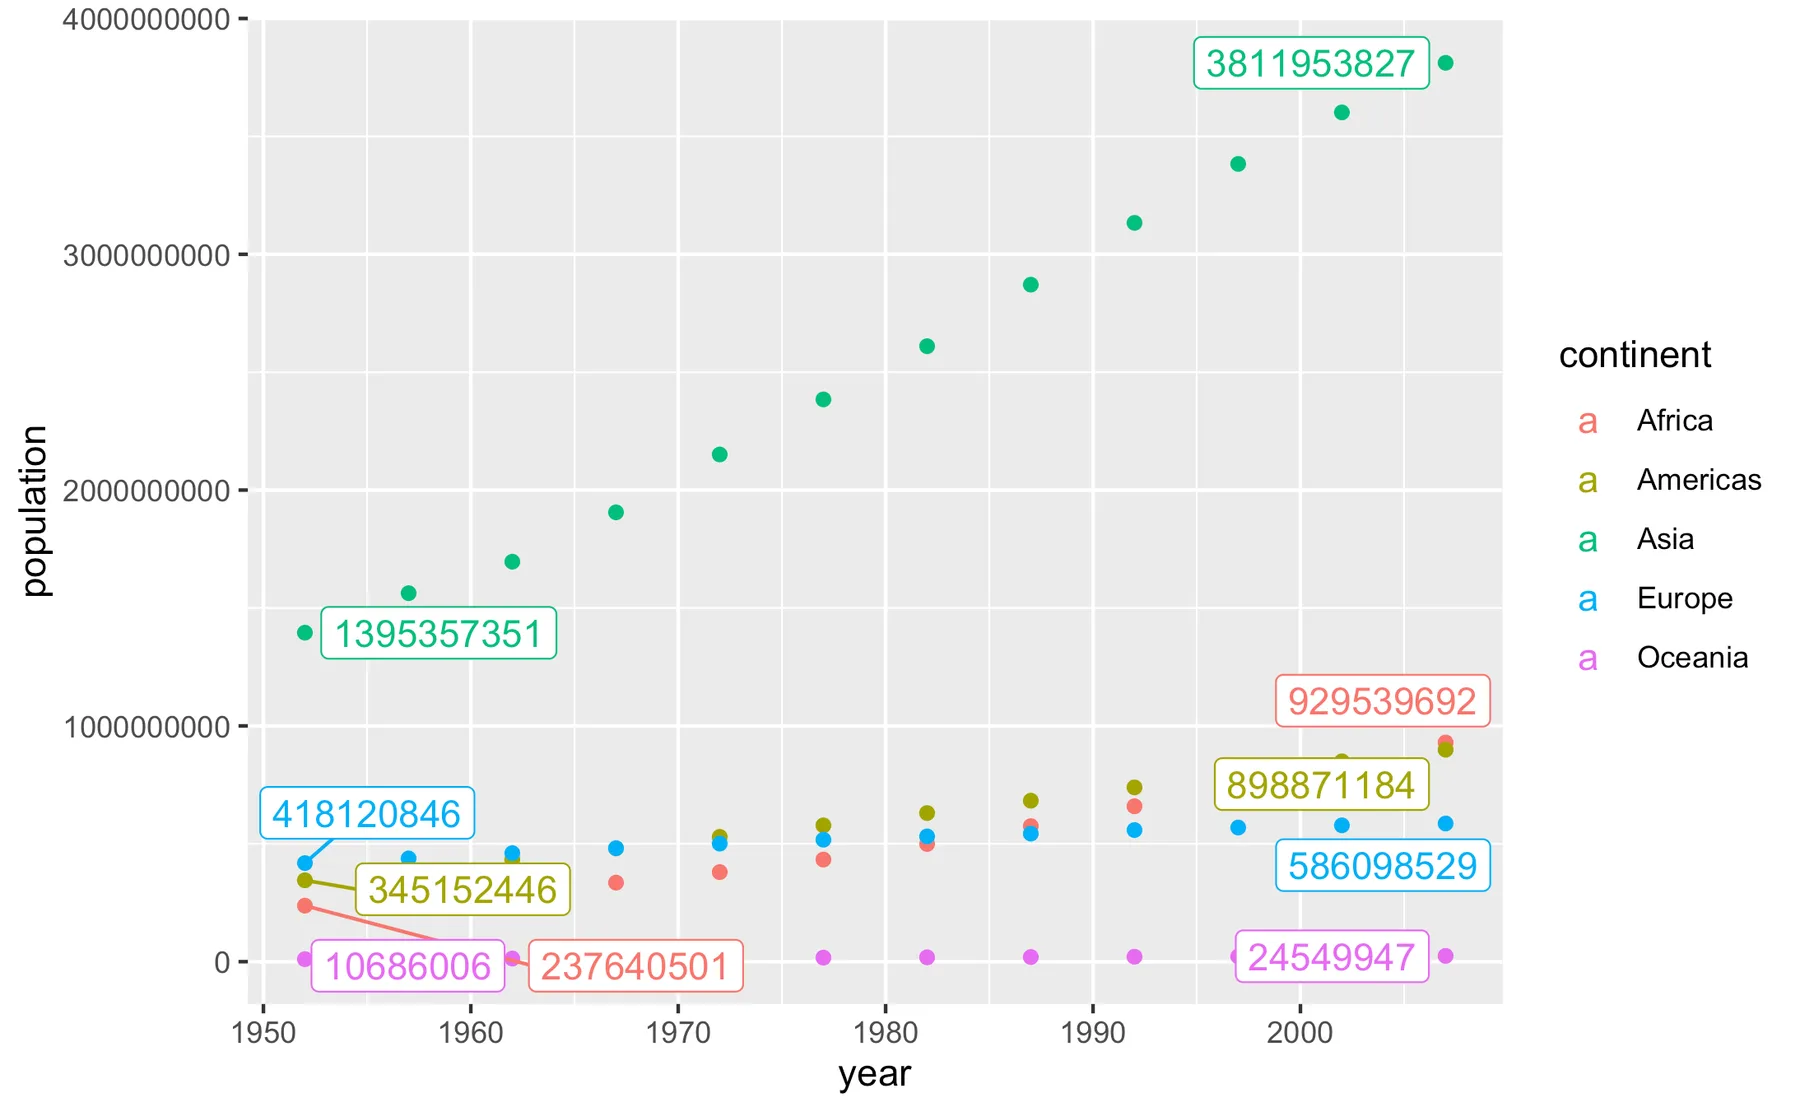
Nous allons maintenant utiliser geom_hline() et geom_vline() pour ajouter des lignes de référence horizontales et verticales. Celles-ci sont généralement placées derrière les points de données, ce qui signifie qu'elles doivent être déclarées avant les points de données (geom_point()) dans le code. Nous plaçons des lignes à deux niveaux de l'axe des ordonnées (spécifiés avec l'argument yintercept) comme ci-dessous :
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  geom_point() +

  # NYTT
  geom_hline(aes(yintercept=1000000000)) +
  geom_hline(aes(yintercept=500000000)) +

  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")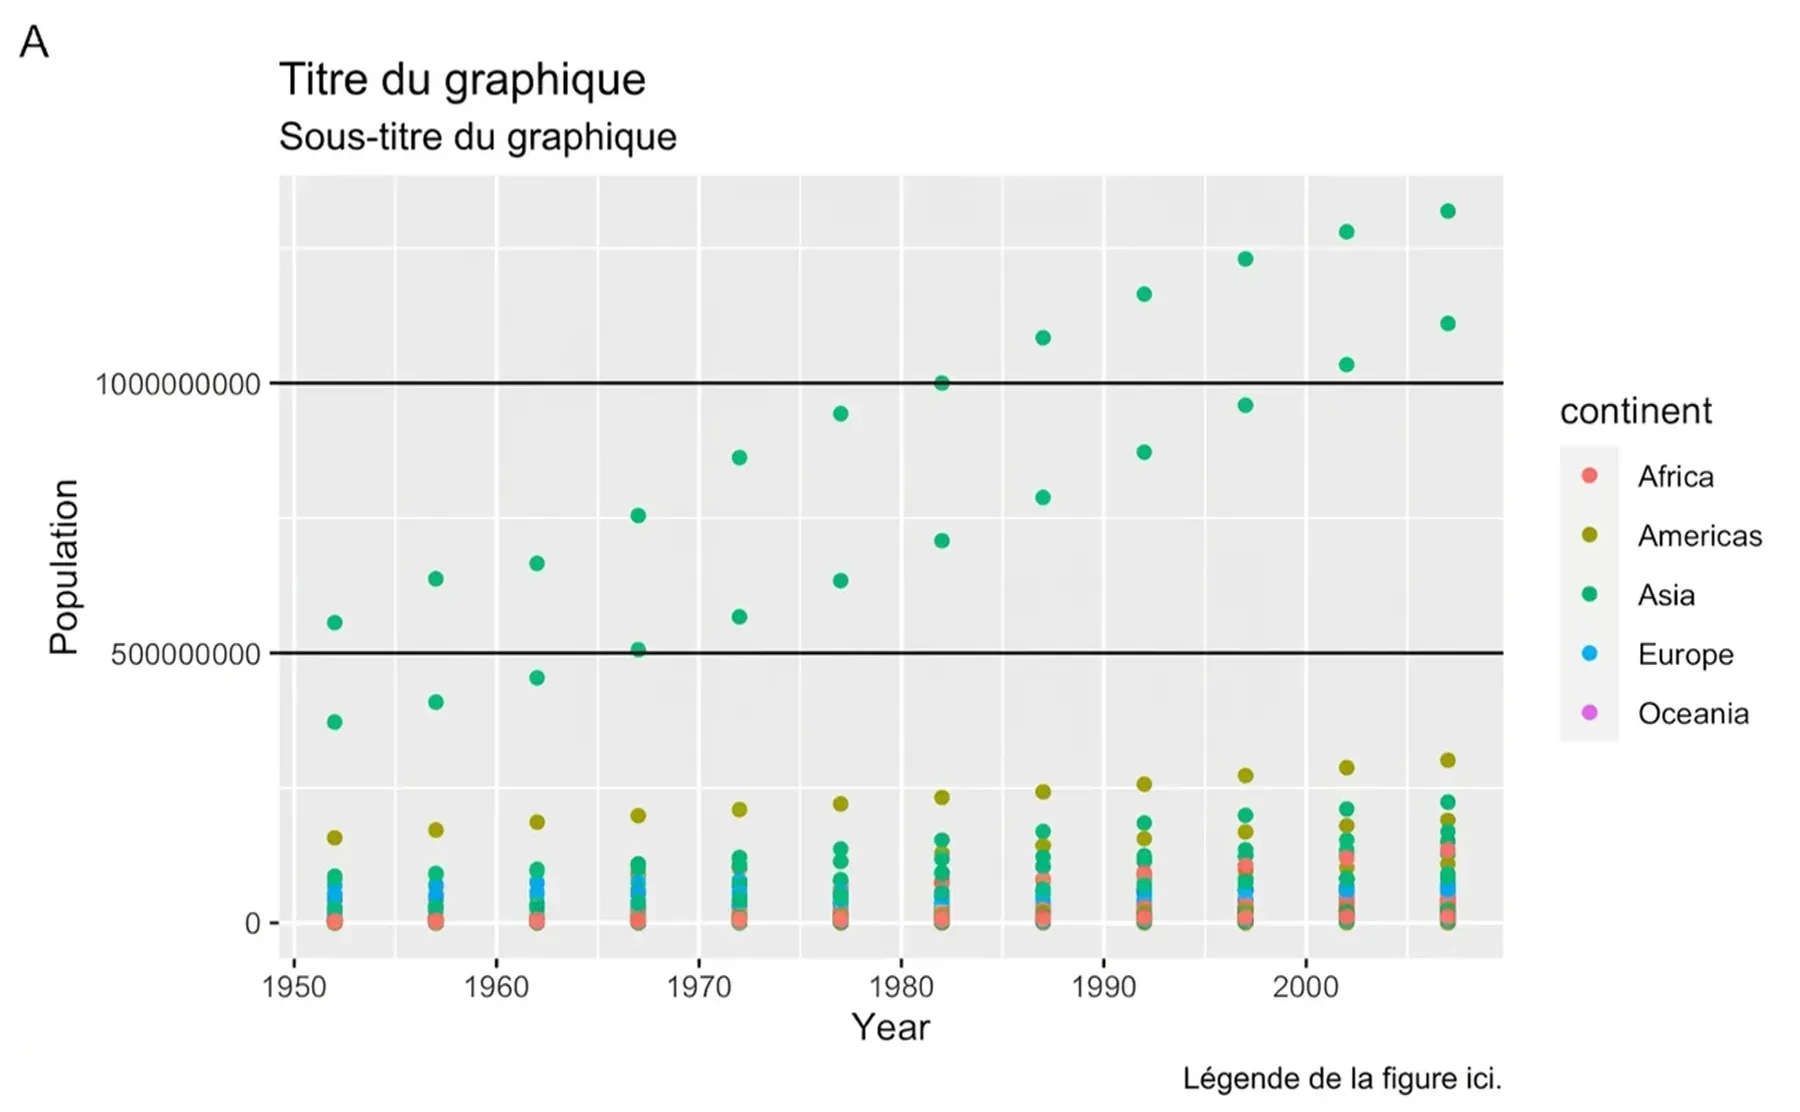
Avec geom_rect(), on peut définir une zone, comme suit :
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  # NYTT
  geom_rect(aes(xmin=1960, xmax=1990, ymin=500000000, ymax=100000000)) +

  geom_point() +

  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")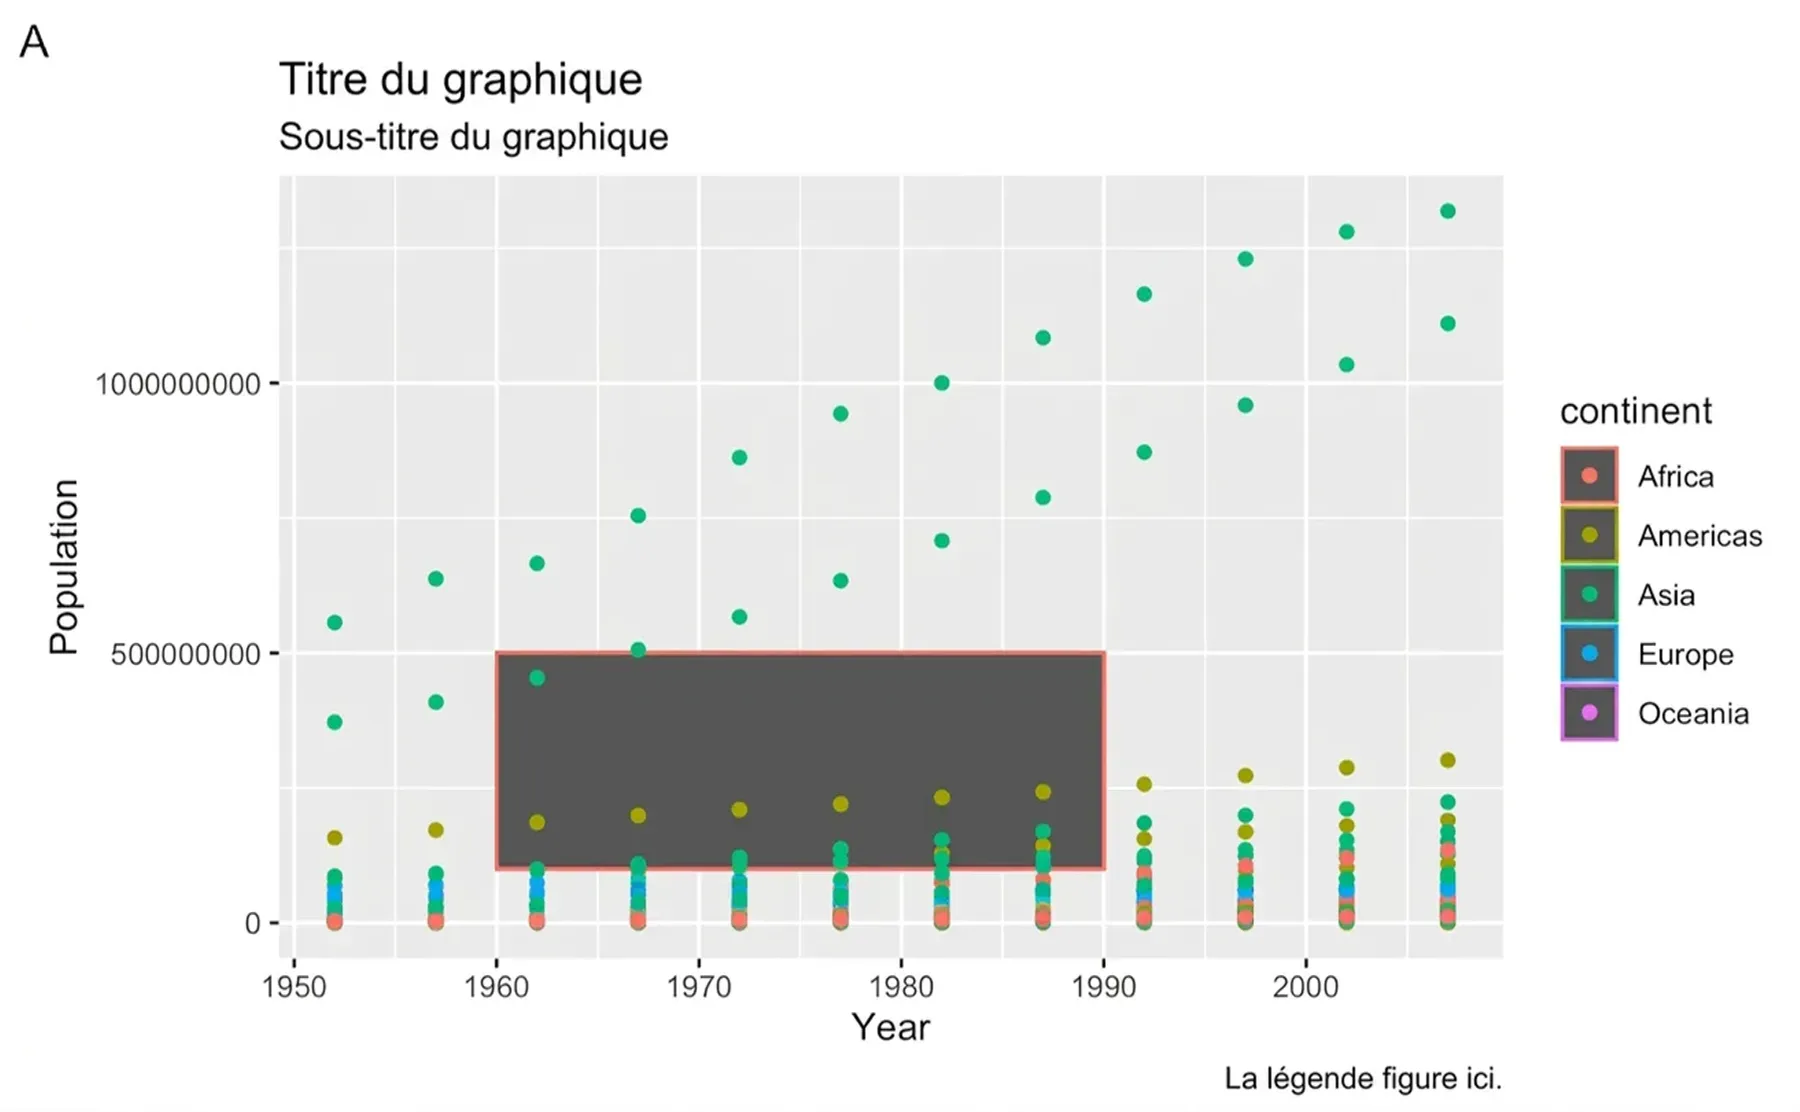
Avec geom_segment(), vous pouvez mettre en évidence des points particulièrement intéressants. La fonction dispose de l'argument arrow pour tracer des flèches.
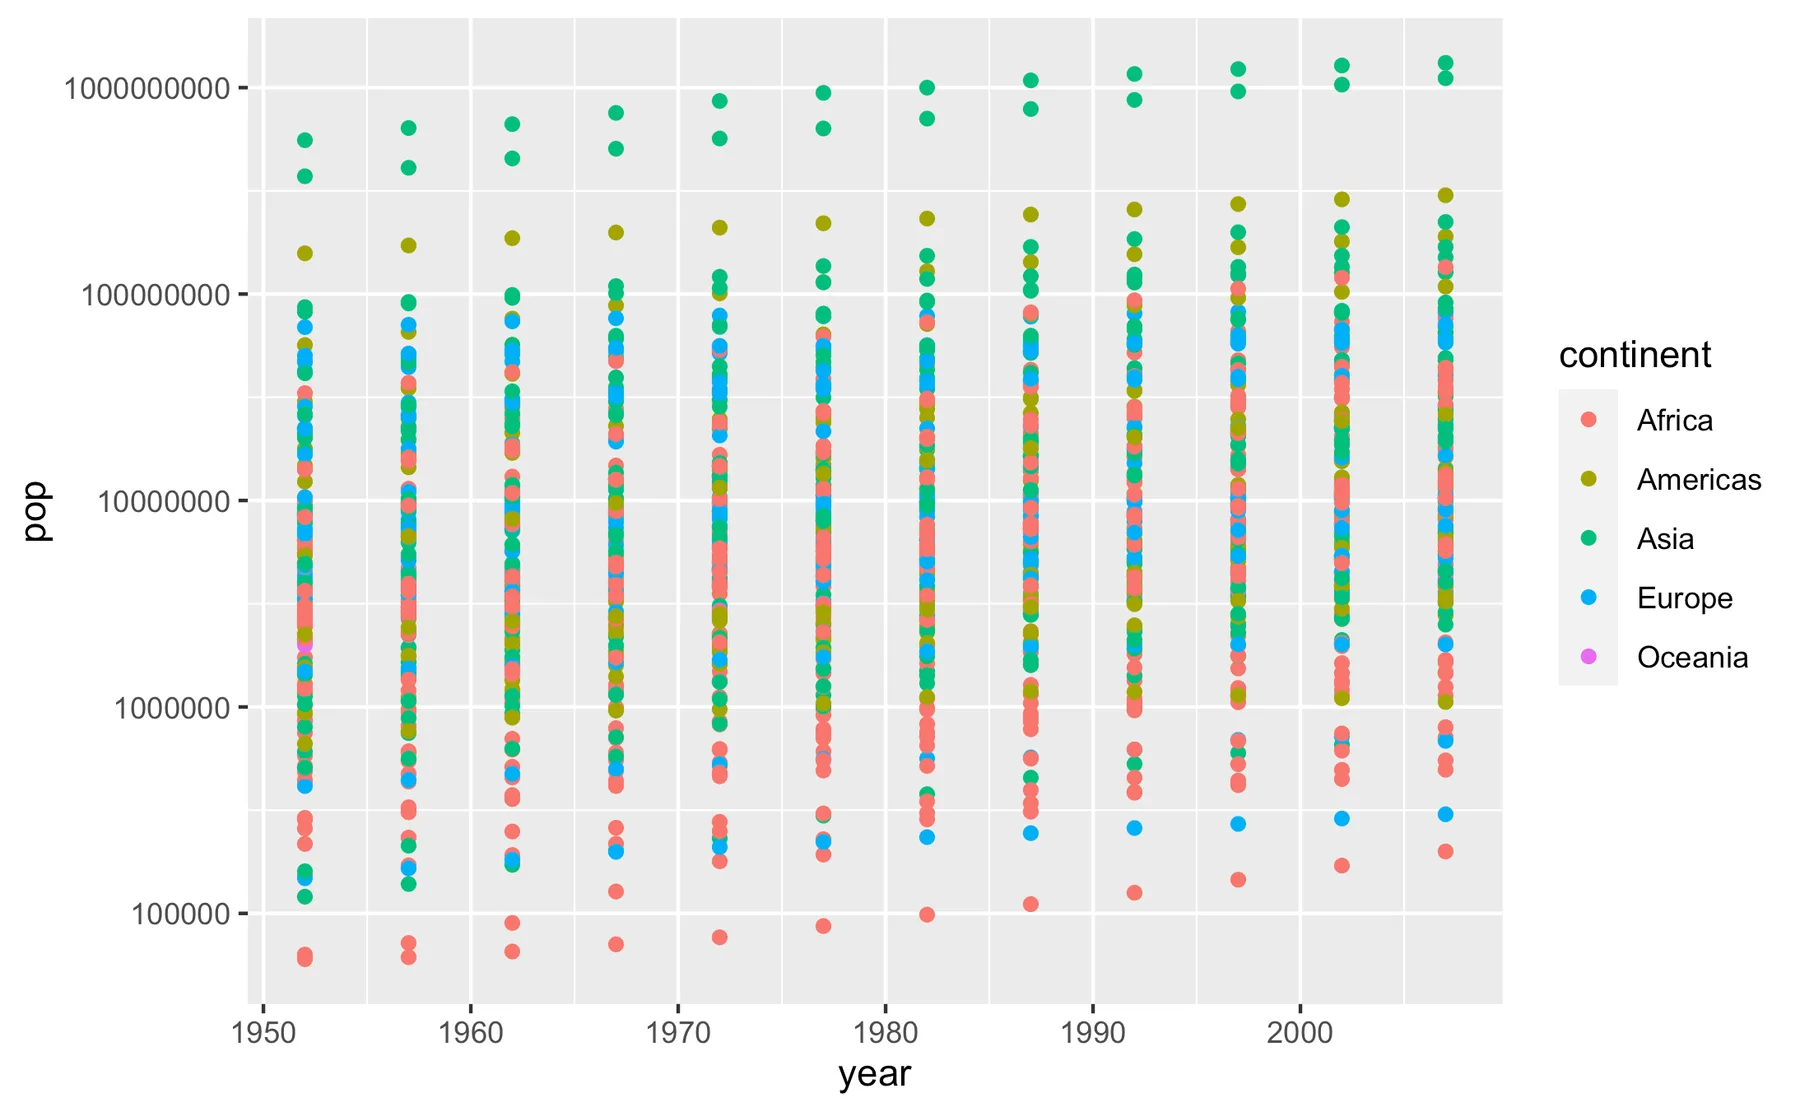
Notez que l'axe des ordonnées couvre un intervalle très large, avec de grands écarts entre les points de données. Dans ce type de situation, il est avantageux de transformer la variable en logarithme. Nous passons l'axe des ordonnées en échelle logarithmique en ajoutant la fonction scale_y_log10(), qui applique le logarithme à toutes les valeurs de y. Cela signifie que vous pouvez effectuer des calculs mathématiques au moment de la visualisation (la source de données n'est pas modifiée).
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  geom_point() +
  # NYTT
  scale_y_log10()