
Chaînes de caractères et expressions régulières (regex)
Les chaînes de caractères sont des informations composées de chiffres, de symboles et/ou de lettres. Une chaîne peut donc être un mélange de ces éléments. Dans R, une chaîne se définit à l'aide de guillemets. Ci-dessous, nous définissons une chaîne que nous enregistrons dans l'objet my_string :
## Enregistrer une chaîne dans un objet
my_string <- "Detta är en sträng!"

## Afficher l'objet
my_string[1] "Detta är en sträng!"Avant d'aller plus loin, nous allons charger le package tidyverse, qui inclut le package stringr, lequel contient toutes les fonctions nécessaires pour manipuler les chaînes de caractères.
library(tidyverse)── Attaching packages ─────────────────────────────────────── tidyverse 1.3.2 ──
ggplot2 3.3.6 purrr 0.3.4
tibble 3.1.8 dplyr 1.0.10
tidyr 1.2.0 stringr 1.4.1
readr 2.1.2 forcats 0.5.1
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
dplyr::filter() masks stats::filter()
dplyr::lag() masks stats::lag()Plusieurs chaînes peuvent être définies avec la fonction [c()](https://rdrr.io/r/base/c.html), qui combine plusieurs éléments en un vecteur :
my_string <- c("Detta är en sträng!", "Detta är en annan sträng")

my_string[1] "Detta är en sträng!" "Detta är en annan sträng"Les chaînes ci-dessus ont été créées avec des guillemets doubles (" "). Une chaîne peut se composer d'un seul caractère ou contenir des livres entiers. Ci-dessous, nous définissons trois chaînes : une chaîne courte (my_string_short), une chaîne composée uniquement de chiffres (my_string_numbers) et une chaîne longue (my_string_long) :
## Une chaîne courte
my_string_short <- c("Detta är en sträng!")

## Une chaîne composée uniquement de chiffres
my_string_numbers <- c("123")

## Une chaîne longue
my_string_long <- c("Salvador Domingo Felipe Jacinto Dalí i Domènech, 1:e markis av Púbol, född 11 maj 1904 i Figueres, Katalonien, Spanien, död 23 januari 1989 i Figueres, var en katalansk (spansk) surrealistisk konstnär. Dalí är mest känd för sina bisarra, absurda och drömska målningar, influerade av bland annat Freuds psykoanalys, Einsteins relativitetsteorier och renässansmåleri.[2][3] Ett av hans mest kända verk, Minnets envishet, blev klart 1931. Utöver måleri omfattade Dalís praktik även film, skulptur, fotografi och text. Han samarbetade med Walt Disney kring den Oscars-nominerade tecknade kortfilmen Destino, som släpptes postumt 2003. Han samarbetade också med Alfred Hitchcock i arbetet med filmen Trollbunden.")
Chaînes de caractères et guillemets
Utilisez des guillemets doubles ("") pour définir une chaîne. N'utilisez des guillemets simples ('') que pour définir une chaîne qui contient elle-même des guillemets doubles.
Une chaîne peut aussi être créée avec des guillemets simples (' ') :
my_string <- c('Detta är en sträng!')
my_string[1] "Detta är en sträng!"Il est toutefois recommandé de définir les chaînes avec des guillemets doubles.
Essayons de définir une chaîne qui contient des guillemets :
my_string <- c("Han fick smeknamnet "Yoggi" men det gillade han inte")
my_stringError: unexpected symbol in "my_string <- c("Han fick smeknamnet "Yoggi"Une erreur (Error) se produit, car R ne sait pas comment interpréter les guillemets autour de Yoggi ("Yoggi"). En effet, les guillemets ont une signification particulière dans les chaînes : ils indiquent le début et la fin de la chaîne. R considère que la chaîne se termine au premier guillemet situé avant la lettre Y ("Y..), mais comme ce guillemet est suivi d'autres lettres, une erreur se produit. Il nous faut donc un moyen d'indiquer à R que les guillemets de la chaîne font réellement partie de la chaîne, et ne sont pas un caractère doté d'une fonction particulière ! D'autres caractères (., *, ], etc.) peuvent provoquer ce type d'ambiguïté et entraîner une erreur.
Pour éviter cette ambiguïté, on utilise la barre oblique inverse (\, backslash*). La barre oblique inverse indique à R que les guillemets autour de “Yoggi” doivent être considérés comme faisant partie de la chaîne. Autrement dit, **la barre oblique inverse (\) sert à échapper (angl. escape) la fonction particulière des guillemets*. Essayons de lire la chaîne une nouvelle fois, mais cette fois avec \ devant chaque guillemet de la chaîne :
my_string <- c("Han fick smeknamnet \"Ylle\" men det gillade han inte")Cela a fonctionné sans erreur ! Affichons la chaîne :
my_string[1] "Han fick smeknamnet \"Ylle\" men det gillade han inte"Notez que la barre oblique inverse (\) apparaît lorsque la chaîne est affichée. La raison en est que R indique où l'échappement a été utilisé. Si vous voulez afficher (*angl.* print) une chaîne sans les caractères d'échappement (\), utilisez la fonction [writeLines()](https://rdrr.io/r/base/writeLines.html) :
writeLines(my_string)Han fick smeknamnet "Ylle" men det gillade han inteDe la même manière, les guillemets simples doivent être précédés de \ pour éviter toute ambiguïté :
my_string <- c('Han fick smeknamnet \'Ylle\' men det gillade han inte')
writeLines(my_string)
Han fick smeknamnet 'Ylle' men det gillade han inteDans le cas particulier des guillemets, on peut aussi éviter l'ambiguïté en utilisant des guillemets doubles pour définir la chaîne et des guillemets simples à l'intérieur de celle-ci, ou inversement. En voici un exemple :
my_string1 <- c("Han fick smeknamnet 'Svurre' men det gillade han inte")
writeLines(my_string)
Han fick smeknamnet 'Svurre' men det gillade han intemy_string2 <- c('Han fick smeknamnet "Svurre" men det gillade han inte')
writeLines(my_string)Han fick smeknamnet 'Svurre' men det gillade han inteLe tableau ci-dessous présente d'autres caractères spéciaux et mises en forme pour lesquels un échappement est nécessaire afin d'éviter toute ambiguïté :
| Escape character | Signification |
|---|---|
| \n | newline |
| \r | carriage return |
| \t | tab |
| \b | backspace |
| \a | alert (bell) |
| \f | form feed |
| \v | vertical tab |
| \\ | backslash \ |
| \’ | ASCII apostrophe ’ |
| \” | ASCII quotation mark ” |
| \` | ASCII grave accent (backtick) ` |
| \nnn | character with given octal code (1, 2 or 3 digits) |
| \xnn | character with given hex code (1 or 2 hex digits) |
| \unnnn | Unicode character with given code (1--4 hex digits) |
| \Unnnnnnnn | Unicode character with given code (1--8 hex digits) |
8.1 Stringr et expressions régulières (regex)
Le package stringr contient toutes les fonctions nécessaires pour manipuler les chaînes de caractères dans R. Nous présentons ci-dessous les fonctions les plus importantes, puis la manière dont les expressions régulières (regular expressions) permettent de réaliser des correspondances puissantes dans les chaînes. La plupart des fonctions de stringr portent le préfixe str_. Commençons par définir une chaîne :
my_string <- c("Det är roligt att lära sig R!")8.1.1 Chaînes identiques
Nous créons à présent deux vecteurs composés d'une chaîne identique (“Sommarlov”) et utilisons la fonction [identical()](https://rdrr.io/r/base/identical.html) pour déterminer s'ils sont identiques :
word_1 <- "Sommarlov"
word_2 <- "Sommarlov"
identical(word_1, word_2)[1] TRUEComme pour beaucoup d'autres fonctions R, vous pouvez placer un point d'exclamation (!) devant le nom de la fonction pour obtenir l'effet inverse. Si la fonction [identical()](https://rdrr.io/r/base/identical.html) indique si deux chaînes sont identiques, alors [identical()](https://rdrr.io/r/base/identical.html) indique si les chaînes ne sont pas identiques. Vérifions maintenant si les mots ne sont pas identiques :
!identical(word_1, word_2)[1] FALSE8.1.2 Changer la casse
Les fonctions [str_to_lower()](https://stringr.tidyverse.org/reference/case.html), [str_to_sentence()](https://stringr.tidyverse.org/reference/case.html), [str_to_title()](https://stringr.tidyverse.org/reference/case.html) et [str_to_upper()](https://stringr.tidyverse.org/reference/case.html) du package stringr permettent de modifier la casse d'une chaîne comme suit :
## Convertit les lettres en minuscules
str_to_lower(my_string)[1] "det är roligt att lära sig r!"## Convertit la chaîne en casse de phrase
str_to_sentence(my_string)[1] "Det är roligt att lära sig r!"## Convertit la chaîne en casse de titre
str_to_title(my_string)[1] "Det Är Roligt Att Lära Sig R!"## Convertit les lettres en majuscules
str_to_upper(my_string)[1] "DET ÄR ROLIGT ATT LÄRA SIG R!"8.1.3 Longueur d'une chaîne
La longueur (nombre de caractères) d'une chaîne se calcule avec [str_length()](https://stringr.tidyverse.org/reference/str_length.html) :
str_length(my_string)[1] 29Comme toutes les autres fonctions de stringr, [str_length()](https://stringr.tidyverse.org/reference/str_length.html) est vectorisée : si vous l'appliquez à un vecteur, le calcul est effectué sur chaque élément du vecteur :
str_length(c("Hej", "Ja", "Kanske"))[1] 3 2 68.1.4 Positions dans les chaînes
Nous pouvons repérer à quel endroit de la chaîne se trouve un caractère donné. On utilise pour cela la fonction [str_locate()](https://stringr.tidyverse.org/reference/str_locate.html). L'exemple suivant calcule à quelle position se trouve la lettre “t”, si elle est présente :
my_string <- c("Det är roligt att lära sig R!")
str_locate(my_string, 't')
start end
[1,] 3 3Selon le résultat, “t” a été trouvé entre la position 3 et la position 3, ce qui signifie que la lettre est le troisième caractère de la chaîne. Notez toutefois que la chaîne contient plusieurs “t” ; pour les repérer tous, il faut utiliser la fonction [str_locate_all()](https://stringr.tidyverse.org/reference/str_locate.html) :
str_locate_all(my_string, 't')[[1]]
     start end
[1,]     3   3
[2,] 13 13
[3,] 16 16
[4,] 17 17On constate que la chaîne contient au total 4 “t”, qui apparaissent aux positions 3, 13, 16 et 17.
8.1.5 Trier des chaînes
Pour trier un vecteur de type character, on utilise la fonction [str_sort()](https://stringr.tidyverse.org/reference/str_order.html) :
my_names <- c('Benny', 'Adam', 'Caesar')
str_sort(my_names)[1] "Adam" "Benny" "Caesar"Nous créons maintenant un data frame contenant des prénoms et des noms de famille. Dorénavant, nous utiliserons les fonctions du package dplyr pour créer et modifier des colonnes.
## Crée les prénoms
first_name <- c('Maria', 'Mohammed', 'Magnus')

## Crée les noms de famille
last_name <- c('Svensson', 'Ayman', 'Bentzel')

## Combine en un tibble (data frame)
my_data <- tibble(first_name, last_name)

## Affiche notre data frame
my_data
## A tibble: 3 × 2
first_name last_name
<chr> <chr>
1 Maria Svensson
2 Mohammed Ayman
3 Magnus Bentzel8.1.6 Combiner des chaînes
Nous réunissons le prénom et le nom de famille en une seule chaîne avec la fonction [str_c()](https://stringr.tidyverse.org/reference/str_c.html). Cette fonction possède l'argument sep, qui précise le caractère servant à séparer les chaînes. Nous choisissons de séparer les chaînes par une espace.
Exemple avec base R (sans dplyr) :
my_data$full_name <- str_c(my_data$first_name,
                           my_data$last_name,
                           sep = " ")

my_data
## A tibble: 3 × 3
first_name last_name full_name
<chr> <chr> <chr>
1 Maria Svensson Maria Svensson
2 Mohammed Ayman Mohammed Ayman
3 Magnus Bentzel Magnus BentzelExemple avec dplyr :
my_data %>%
  mutate(full_name = str_c(first_name, last_name, sep = " "))
## A tibble: 3 × 3
first_name last_name full_name
<chr> <chr> <chr>
1 Maria Svensson Maria Svensson
2 Mohammed Ayman Mohammed Ayman
3 Magnus Bentzel Magnus BentzelAvec dplyr, on obtient un code clair et simple, sans recourir à $, [] ou autre. Les nouvelles colonnes sont créées avec la fonction mutate().
Vous pouvez assembler plus de deux chaînes avec [str_c()](https://stringr.tidyverse.org/reference/str_c.html) :
a = "Hej"
b = "jag"
c = "heter"
d = "Adam"

str_c(a, b, c, d, sep = " ")[1] "Hej jag heter Adam"8.1.7 Compter le nombre de correspondances dans une chaîne
Avec [str_count()](https://stringr.tidyverse.org/reference/str_count.html), nous pouvons calculer combien de fois une chaîne ou un caractère donné apparaît dans une chaîne. Vérifions combien de fois la lettre ‘m’ apparaît dans les prénoms. Nous créons pour cela une nouvelle variable que nous appelons antal_m :
my_data %>%
  mutate(antal_m = str_count(first_name, 'm'))
## A tibble: 3 × 4
first_name last_name full_name antal_m
<chr> <chr> <chr> <int>
1 Maria Svensson Maria Svensson 0
2 Mohammed Ayman Mohammed Ayman 2
3 Magnus Bentzel Magnus Bentzel 0R est sensible à la casse. La lettre m n'est pas équivalente à la lettre M. Essayons à nouveau avec la lettre M :
my_data %>%
  mutate(antal_m = str_count(first_name, 'M'))
## A tibble: 3 × 4
first_name last_name full_name antal_m
<chr> <chr> <chr> <int>
1 Maria Svensson Maria Svensson 1
2 Mohammed Ayman Mohammed Ayman 1
3 Magnus Bentzel Magnus Bentzel 18.1.8 Détecter des chaînes, des caractères et des symboles dans les chaînes
La fonction [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html) permet de déterminer si des chiffres, des lettres, des symboles, des caractères ou des chaînes figurent dans une chaîne. La fonction [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html) renvoie une valeur booléenne (TRUE, FALSE). Nous créons maintenant la variable finns_m, qui indique si la lettre "m" figure dans la chaîne :
my_data %>%
  mutate(finns_m = str_detect(first_name, 'm'))
## A tibble: 3 × 4
first_name last_name full_name finns_m
<chr> <chr> <chr> <lgl>
1 Maria Svensson Maria Svensson FALSE
2 Mohammed Ayman Mohammed Ayman TRUE
3 Magnus Bentzel Magnus Bentzel FALSELes fonctions string_ends() et string_starts() permettent de déterminer si une chaîne commence ou se termine par une chaîne donnée. Vérifions si la chaîne commence par M et se termine par s. Nous créons deux nouvelles variables qui l'indiquent :
my_data %>%
  mutate(starts_M = str_starts(first_name, 'M'),
         ends_s = str_ends(first_name, 's'))
## A tibble: 3 × 5
first_name last_name full_name starts_M ends_s
<chr> <chr> <chr> <lgl> <lgl>
1 Maria Svensson Maria Svensson TRUE FALSE
2 Mohammed Ayman Mohammed Ayman TRUE FALSE
3 Magnus Bentzel Magnus Bentzel TRUE TRUE8.1.9 Remplacer des chaînes et des caractères
Remplacez tout ou partie d'une chaîne avec la fonction [str_replace()](https://stringr.tidyverse.org/reference/str_replace.html). Remplaçons maintenant la lettre M par un astérisque (*) :
my_data %>%
  mutate(new_first_name = str_replace(first_name, 'M', '*'))
## A tibble: 3 × 4
first_name last_name full_name new_first_name
<chr> <chr> <chr> <chr>
1 Maria Svensson Maria Svensson *aria
2 Mohammed Ayman Mohammed Ayman *ohammed
3 Magnus Bentzel Magnus Bentzel *agnusLa fonction [str_replace()](https://stringr.tidyverse.org/reference/str_replace.html) ne remplace que la première instance (occurrence) du motif recherché. Utilisez la fonction [str_replace_all()](https://stringr.tidyverse.org/reference/str_replace.html) pour remplacer toutes les instances. Ci-dessous, nous remplaçons tous les m par * :
my_data %>%
  mutate(new_first_name = str_replace_all(first_name, 'm', '*'))
## A tibble: 3 × 4
first_name last_name full_name new_first_name
<chr> <chr> <chr> <chr>
1 Maria Svensson Maria Svensson Maria
2 Mohammed Ayman Mohammed Ayman Moha**ed
3 Magnus Bentzel Magnus Bentzel Magnus8.1.10 Remplacer NA par “NA”
Missing data est le terme anglais désignant les informations manquantes (données manquantes). Le plus souvent, on emploie simplement le mot missing pour désigner les données manquantes. Dans R, une valeur manquante est notée NA (Not Available). Nous pouvons créer une valeur manquante dans un vecteur de type character en indiquant la valeur NA sans guillemets :
x <- c("abc", NA)
x[1] "abc" NANotez que la chaîne “abc” est entourée de guillemets pour indiquer qu'il s'agit d'une chaîne. NA, en revanche, n'est pas entouré de guillemets, car il s'agit d'une valeur missing. Nous pouvons remplacer la valeur missing (NA) par la chaîne NA (“NA").
x <- c("abc", NA)
str_replace_na(x)[1] "abc" "NA"8.1.11 Extraire des parties de chaînes (substring)
La fonction [str_sub()](https://stringr.tidyverse.org/reference/str_sub.html) permet d'extraire des parties de chaînes. Elle possède les arguments start et end, qui indiquent où l'extraction commence et où elle se termine. Ici, nous extrayons de la première à la deuxième position :
x <- c("Sommarlov")
str_sub(string=x, start=1, end=2)[1] "So"Comme d'habitude, nous pouvons indiquer les valeurs des arguments string, start et end sans préciser le nom des arguments, à condition de les indiquer dans le bon ordre :
x <- c("Sommarlov")
str_sub(x, 1, 2)[1] "So"Des valeurs négatives pour start et end indiquent que l'extraction se compte à partir de la fin de la chaîne. Ici, nous extrayons tous les caractères de l'avant-dernier au dernier :
x <- c("Sommarlov")
str_sub(x, -2, -1)[1] "ov"Si vous essayez d'extraire davantage que ce que contient la chaîne, [str_sub()](https://stringr.tidyverse.org/reference/str_sub.html) renverra autant que possible :
x <- c("Sommarlov")
str_sub(x, 1, 100)[1] "Sommarlov"8.2 Expressions régulières (Regex)
En pratique, vous aurez parfois besoin de correspondances encore plus élaborées, et les expressions régulières (regular expressions) sont alors inestimables. Une expression régulière (regex) est une séquence de caractères qui recherche un motif dans une chaîne.
Autres ressources sur les expressions régulières :
- https://www.regular-expressions.info/ fournit des informations détaillées sur le fonctionnement des expressions régulières.
- https://regex101.com est un outil interactif qui vous permet de tester vos expressions régulières en direct pour vérifier qu'elles se comportent comme prévu.
Les expressions régulières peuvent sembler compliquées au premier abord, mais une fois que vous aurez compris leur fonctionnement, vous verrez qu'elles sont extrêmement puissantes pour manipuler les chaînes de caractères. Il faut souvent procéder à quelques essais avant d'obtenir une expression régulière qui fonctionne ; pour voir comment votre expression régulière correspond aux caractères d'une chaîne, il existe les fonctions [str_view()](https://stringr.tidyverse.org/reference/str_view.html) et [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html). Elles montrent comment les expressions régulières correspondent à une chaîne, en surlignant la partie de la chaîne qui correspond à votre expression régulière. Utilisons maintenant la fonction pour voir si notre expression régulière repère la lettre X dans les chaînes ci-dessous. La chaîne à parcourir est indiquée dans l'argument string et le motif recherché dans pattern :
my_strings <- c("Xxx", "Yyy", "Xxx")
str_view(string=my_strings, pattern='X')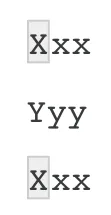
La barre verticale (|) signifie “ou”. Elle permet de rechercher différents caractères, dont un seul doit correspondre. Ci-dessous, nous indiquons pattern='X|x', ce qui signifie que nous recherchons X ou x.
my_strings <- c("Xxx", "xXx")
str_view(string=my_strings, pattern='X|x')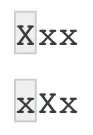
Comme on le voit ci-dessus, seul le premier X ou x a été trouvé, car nous avons utilisé [str_view()](https://stringr.tidyverse.org/reference/str_view.html). La fonction [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html) peut trouver toutes les occurrences d'une chaîne. En voici un exemple :
my_strings <- c("Xxx", "xXx")
str_view_all(string=my_strings, pattern='X|x')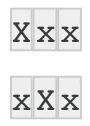
Les fonctions [str_view()](https://stringr.tidyverse.org/reference/str_view.html) et [str_view_all()](https://stringr.tidyverse.org/reference/str_view.html) vous permettent donc de voir comment une expression régulière (regex) correspond à une chaîne. Voici un exemple dans lequel nous utilisons [str_view()](https://stringr.tidyverse.org/reference/str_view.html) pour vérifier si notre expression régulière peut trouver H au début d'une chaîne. Dans les expressions régulières, ^ sert à indiquer le début d'une chaîne. Pour trouver H au début d'une chaîne, on écrit donc :
str_view(string='Hej', pattern='^H')
Notre expression régulière semble bien trouver H, comme prévu.
Le point (.) est une expression régulière qui correspond à n'importe quel caractère. Ci-dessous, nous testons si A. correspond à l'une ou l'autre des chaînes d'un vecteur :
my_strings <- c("A", "AB", "ABC")
str_view(my_strings, 'A.')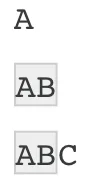
La première chaîne, A, ne correspond pas, car aucun caractère ne suit A. Les chaînes AB et ABC correspondent, car elles contiennent A suivi d'un autre caractère.
Dans l'exemple suivant, nous voulons trouver exactement la chaîne X.X. Le point ne doit pas être traité comme un caractère spécial, mais être recherché tel quel. S'il s'agissait seulement d'une chaîne, nous aurions pu chercher X\.X, mais comme nous voulons utiliser une regex pour la correspondance, il faut ajouter une barre oblique inverse \ supplémentaire, car les regex utilisent elles aussi ce symbole comme caractère d'échappement. Le code suivant est donc nécessaire pour trouver exactement X.X :
Si vous voulez plutôt trouver exactement “A.C”, il faut utiliser l'échappement (\), comme suit :
my_strings <- c("X.X")
str_view(my_strings, "X\\.X")
Comment trouver \ dans une chaîne avec une expression régulière ? Tout d'abord, \ doit être interprété comme un caractère ordinaire (sans fonction particulière), ce qui nécessite un \ supplémentaire. Commençons par écrire un prénom et un nom de famille séparés par \\. Cela devrait donner un \ lorsque nous l'affichons avec [writeLines()](https://rdrr.io/r/base/writeLines.html) :
my_string <- "Monika \\ Svensson"
writeLines(my_string)
Monika \ SvenssonIl faut donc deux barres obliques inverses (\\) pour obtenir une chaîne contenant une barre oblique inverse. Pour créer une regex, il faut maintenant une barre oblique inverse supplémentaire pour chaque barre oblique inverse. Pour trouver une barre oblique inverse dans une chaîne, il faut donc le code suivant :
str_view(my_string, "\\\\")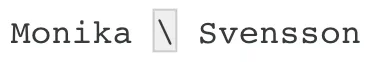
Autrement dit, comme les expressions régulières et les chaînes utilisent le même symbole d'échappement (\), il faut un double échappement lorsque vous utilisez des expressions régulières pour des caractères et symboles particuliers. Il est possible d'éviter l'échappement du caractère lui-même et de ne spécifier que l'échappement de l'expression régulière en utilisant [raw()](https://rdrr.io/r/base/raw.html). Cela correspond aux raw vectors,
str_view(my_string, r"(\\)")Le même principe s'applique pour trouver un astérisque (*) :
str_view(string=c("abc", "a.c", "a*c", "a c"), pattern="\\*")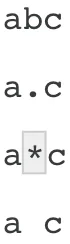
Il existe d'autres expressions régulières pour rechercher des correspondances dans les chaînes, et elles peuvent être combinées. Les voici :
| Sequence | Matches |
|---|---|
. |
Any character except newline |
[xyz] |
Any character listed between the brackets (x, y, and z in this example) |
[a-z] |
Any character between a and z, inclusive |
[^xyz] |
The opposite of [xyz] |
\d |
ASCII digits (0 through 9, inclusive) |
\D |
Anything except ASCII digits |
\s |
ASCII spaces (space, tab, newline, carriage return, form feed) |
\S |
Anything except ASCII spaces |
\w |
The same as [0-9A-Za-z_] |
\W |
Anything except the characters matched by \w |
[[:alnum:]] |
The same as [0-9A-Za-z] |
[[:alpha:]] |
The same as [A-Za-z] |
[[:ascii:]] |
Any ASCII character |
[[:blank:]] |
ASCII tab or space |
[[:cntrl:]] |
ASCII/Unicode control characters |
[[:digit:]] |
The same as [0-9] |
[[:graph:]] |
All “graphical” (printable) ASCII characters |
[[:lower:]] |
The same as [a-z] |
[[:print:]] |
The same as [[:graph:]] |
[[:punct:]] |
The same as [!-/:-@[-`{-~] |
[[:space:]] |
The same as [\t\n\v\f\r ] |
[[:upper:]] |
The same as [A-Z] |
[[:word:]] |
The same as \w |
[[:xdigit:]] |
The same as [0-9A-Fa-f] |
\pN |
Unicode character class by using single-letter class names (“N” in this example) |
\p{Greek} |
Unicode character class by unicode name (“Greek” in this example) |
\PN |
The opposite of \pN |
\P{Greek} |
The opposite of \p{Greek} |
xy |
x followed immediately by y |
x|y |
either x or y, preferring x |
x* |
zero or more x, preferring more |
x*? |
zero or more x, preferring fewer |
x+ |
one or more x, preferring more |
x+? |
one or more x, preferring fewer |
x? |
zero or one x, preferring one |
x?? |
zero or one x, preferring zero |
x{n,m} |
between n and m repetitions of x, preferring more |
x{n,m}? |
between n and m repetitions of x, preferring fewer |
x{n,} |
at least n repetitions of x, preferring more |
x{n,}? |
at least n repetitions of x, preferring fewer |
x{n} |
exactly n repetitions of x |
(x) |
unnamed capture group for sub-pattern x |
(?P<name>x) |
named capture group, named name, for sub-pattern x |
(?:x) |
non-capturing sub-pattern x |
\* |
Literal * for any punctuation character * |
\Q...\E |
Literal ... for any text ... as long as it does not include literally \E |
8.3 Ancres (^, $)
Il existe aussi des expressions régulières qui indiquent où la correspondance doit avoir lieu. Les symboles les plus courants sont ^, qui indique que la correspondance doit se faire au début d'une chaîne, et $, qui indique qu'elle doit se faire à la fin de la chaîne.
| Sequence | Matches |
|---|---|
^ |
At the beginning of the given string |
$ |
At the end of the given string |
\A |
At the beginning of the given string |
\z |
At the end of the given string |
\b |
At an ASCII word boundary (transition between \w and either \W, \A or \z, or vice-versa) |
\B |
Not at an ASCII word boundary |
8.3.1 Character set (classe de caractères)
Un character set est une liste de caractères à rechercher. La liste est indiquée entre []. Pour rechercher les lettres a, b ou c, on utilise le character set suivant : [abc]. Le character set est avantageux, car il dispense de spécifier l'échappement (\) pour les symboles des expressions régulières. Vous n'avez pas besoin d'échappement pour les symboles suivants : $ . | ? * + ( ) [ {. Cela signifie que vous pouvez écrire ces symboles et les rechercher directement dans un character set (sans spécifier d'échappement). Pour rechercher ., , a b ou c, on utilise le character set suivant : [.*abc]
Certains symboles conservent toutefois une fonction particulière, même à l'intérieur d'un character set ; les voici :
]^inverse la liste.[^abc]correspond à tout sauf a, b et c.[a-zA-Z0-9]correspond à toutes les minuscules, majuscules et chiffres
-définit un intervalle selon l'ordre alphabétique ou numérique.- Exemple :
[a-d]correspond aux lettres a, b, c ou d. - Exemple :
[0-4]correspond aux chiffres 0, 1, 2, 3, 4
- Exemple :
\sert à échapper],^et-dans un character set.[a\\-c]correspond àa-c.[\^\-]correspond à^-.
Recherchons maintenant les chaînes qui commencent par a et se terminent par b, avec entre les deux soit un astérisque (*), soit la lettre b :
str_view(c("abc", "a.c", "a*c", "a c"), "a[*b]c")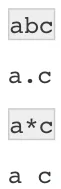
Notez que nous avons réussi à trouver l'astérisque (*) sans utiliser \\, ce qui s'explique par le fait que nous avons utilisé à la place [], que l'on appelle character class (classe de caractères). Essayons à nouveau, mais en remplaçant cette fois le premier a par n'importe quel caractère (.) :
str_view(c("abc", "a.c", "a*c", "a c"), ".[*]c")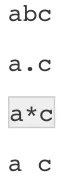
Pour rechercher une espace (blanc), on peut utiliser une espace ordinaire, avec ou sans classe de caractères :
str_view(string=c("a c", "a.c", "a*c"), pattern="a[ ]c")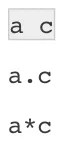
str_view(string=c("a c", "a.c", "a*c"), pattern="a c")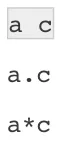
8.3.2 Correspondance par alternance
Vous pouvez rechercher plusieurs possibilités en utilisant la barre verticale (|), comme suit :
str_view(c("a", "b", "c", "d"), "a|b")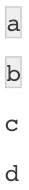
Vous pouvez rechercher plus de deux possibilités :
str_view(c("a", "b", "c", "d"), "a|b|c")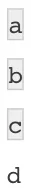
Si la correspondance se fait à l'intérieur d'un mot, des parenthèses sont nécessaires, comme suit :
str_view(c("glad", "glöd"), "gl(a|ö)d")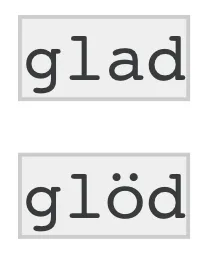
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")

## Le mot commence-t-il par la lettre S ?
str_detect(my_words, "^S")[1] TRUE FALSE FALSE FALSE## Combien de mots se terminent par la lettre i ou r ?
str_detect(my_words, "[ir]$")[1] FALSE TRUE TRUE FALSEstr_subset(my_words, "x$")character(0)8.3.3 Inverser la correspondance
Au lieu de trouver toutes les chaînes qui contiennent un symbole donné, nous pouvons inverser la correspondance. Pour cela, on place un point d'exclamation (!) devant [str_detect()](https://stringr.tidyverse.org/reference/str_detect.html). Le point d'exclamation (!) signifie “inverse” ou “non”. Ainsi, !str_detect() signifie qu'une chaîne ne correspond pas. Essayons :
## Quels mots ne commencent pas par S ?
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")
!str_detect(my_words, "^S")[1] FALSE TRUE TRUE TRUEVous pouvez aussi inverser la correspondance à l'aide d'une classe de caractères. Pour cela, on commence la classe de caractères par ^. Le code suivant identifie les mots qui ne commencent pas par S :
## Quels mots ne commencent pas par S ?
my_words <- c("Sommarlov", "Okidoki", "Tackar", "Bolag")
str_detect(my_words, "^[^S]")[1] FALSE TRUE TRUE TRUE8.4 Correspondance répétée
Nous pouvons contrôler le nombre de fois qu'une chaîne peut correspondre à l'aide des caractères suivants :
my_string <- "AAAAAA"

str_view(my_string, "AA?")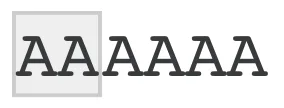
str_view(my_string, "AA+")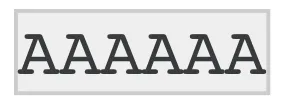
str_view(my_string, "AA*")Les accolades permettent de préciser combien de fois une correspondance doit se produire :
{n}: n fois{n,}: n fois ou plus{,m}: au maximum m fois{n,m}: entre n et m fois
str_view(my_string, "A{2}")str_view(my_string, "A{2,}")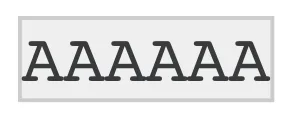
str_view(my_string, "A{2,3}")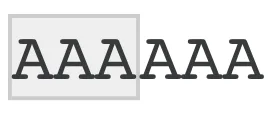
8.4.1 Classes de caractères abrégées (shorthand character classes)
Certains character sets ont été abrégés parce qu'ils sont très souvent utilisés. Les voici :
\d: correspond à n'importe quel chiffre\D: correspond à tout ce qui n'est pas un chiffre\s: correspond à tous les blancs (p. ex. espace, tabulation, saut de ligne) ;\S: correspond à tout ce qui n'est pas un blanc\w: correspond à tous les chiffres et lettres\W: correspond à tout ce qui n'est ni un chiffre ni une lettre
Dans les expressions régulières, elles doivent être écrites avec une barre oblique inverse supplémentaire. Pour \d, on écrit donc \\d.
Recherchons tous les chiffres, puis tout ce qui n'est pas un chiffre :
str_view_all("Hej! 123456 @ # %", "\\d")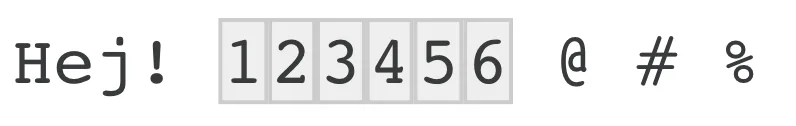
str_view_all("Hej! 123456 @ # %", "\\D")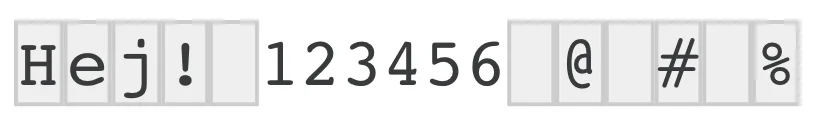
Recherchons toutes les lettres et tous les chiffres, puis l'inverse.
str_view_all("Hej! 123456 @ # %", "\\w")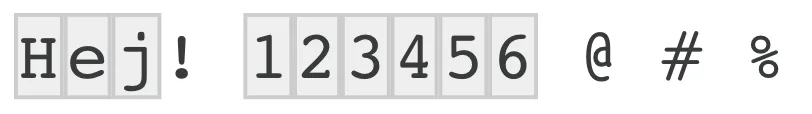
str_view_all("Hej! 123456 @ # %", "\\W")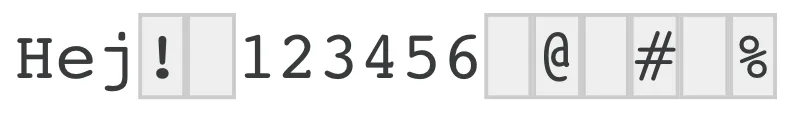
Recherchons tous les blancs, puis l'inverse.
str_view_all("Hej! 123456 @ # %", "\\s")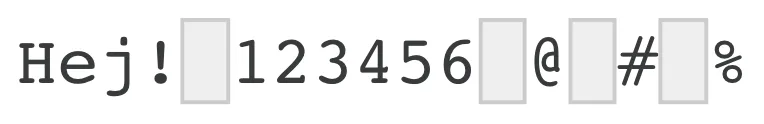
str_view_all("Hej! 123456 @ # %", "\\S")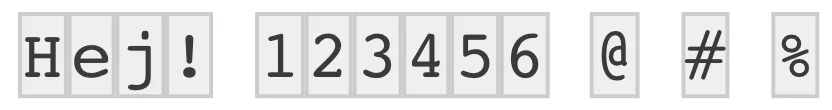
Recherchons toutes les séquences de 5 lettres ou chiffres, ou de 2 chiffres :
str_view_all("Hej jag heter Maggi och har telefonnummer 123456", "\\w{5}|\\d{2}")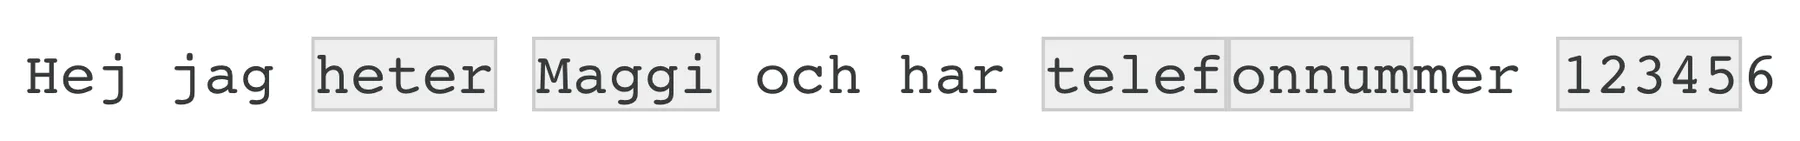
8.4.2 Priorité des opérateurs
Dans les calculs mathématiques, il existe un ordre de priorité des opérations. La multiplication passe avant l'addition et la soustraction. Le calcul 1*2+3 sera évalué comme (1*2)+3, car la multiplication est prioritaire. Les expressions régulières ont elles aussi des règles de priorité. Les quantificateurs (par exemple +) ont une priorité plus élevée que les alternances (|). Si une expression régulière donne un résultat inattendu, il peut être nécessaire de clarifier la priorité à l'aide de parenthèses. En voici un exemple :
## Expression régulière moins explicite
str_view("Jag hittade en vattenkanna", "an+")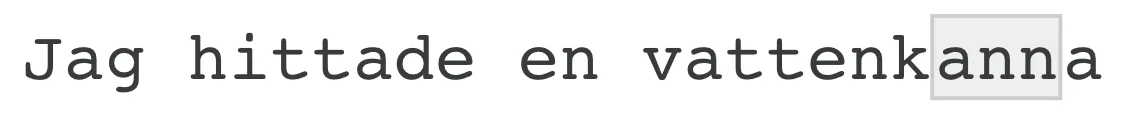
## Expression régulière plus explicite
str_view("Jag hittade en vattenkanna", "a(n+)")
8.4.3 Correspondances booléennes et conditions
Vous pouvez utiliser la barre verticale et & comme d'habitude, y compris avec des chaînes. Les deux commandes suivantes sont donc équivalentes :
## Créer un vecteur de mots
my_words <- c("hej", "bra", "ja", "kanske", "lite", "mycket", "troligen", "sannolikt", "utmärkt")

## Identifier tous les mots contenant "a" ou "b"
my_words[str_detect(my_words, "a") | str_detect(my_words, "b")][1] "bra" "ja" "kanske" "sannolikt"## Identifier tous les mots contenant "a" ou "b"
my_words[str_detect(my_words, "a|b")][1] "bra" "ja" "kanske" "sannolikt"Vous pouvez, de la même manière, formuler d'autres conditions utiles :
## Identifier tous les mots contenant "a", "n" et "k"
my_words[str_detect(my_words, "a") & str_detect(my_words, "n") & str_detect(my_words, "k")][1] "kanske" "sannolikt"